ReLU网络集合的闭性新证:单隐层弱闭,双隐层非闭
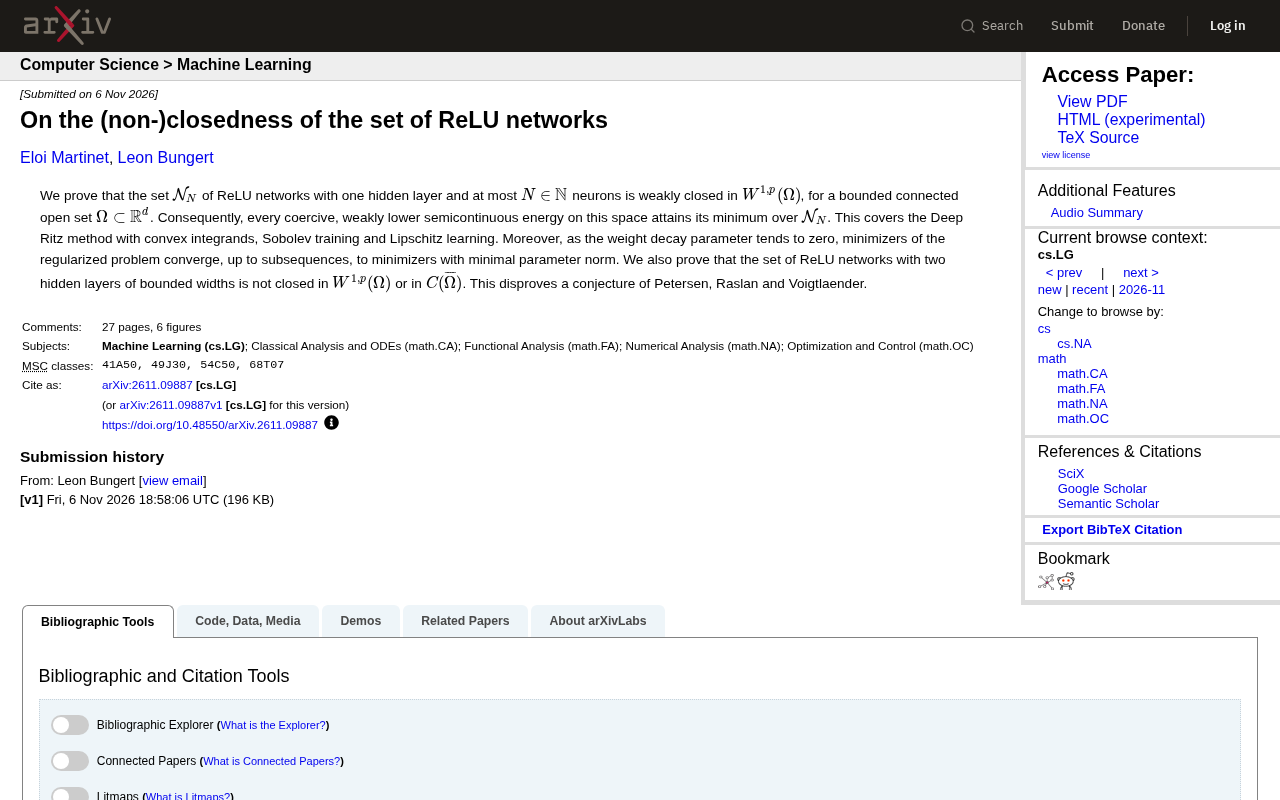
单隐层ReLU网络弱闭保证变分问题可解,双隐层非闭推翻猜想。
本文探讨了ReLU网络集合在函数空间中的闭性性质。对于单隐层网络,论文证明其在Sobolev空间W^{1,p}(Ω)中是弱闭的,从而保证了强制弱下半连续泛函的最小值存在,这一结果适用于Deep Ritz方法、Sobolev训练和Lipschitz学习,并分析了权重衰减正则化的极限行为。相反,对于双隐层有界宽度网络,论文构造反例表明其在W^{1,p}(Ω)和C(Ω̄)中均非闭,推翻了Petersen等人的猜想。非闭性导致变分问题可能无解、训练算法不稳定,并需要更精细的逼近理论。研究划清了单层与双层网络在闭性上的分界线,对基于变分原理的深度学习算法设计具有重要启示。
引言
ReLU网络在深度学习中的成功引发了大量对其函数空间性质的研究。一个核心问题是:由固定架构的ReLU网络构成的集合,在常见的函数空间中是否闭?这个问题的答案直接影响变分问题的可解性、正则化方法的收敛性以及网络逼近的理论保证。最近一篇论文对单隐层和双隐层ReLU网络的闭性给出了截然不同的结论,并推翻了一个已有的猜想。
单隐层ReLU网络:弱闭性成立
论文证明:对于有界连通开集 $\Omega\subset\mathbb{R}^d$,只有一个隐藏层且至多 $N$ 个神经元的ReLU网络集合 $\mathcal{N}_N$,在Sobolev空间 $W^{1,p}(\Omega)$ 中是弱闭的。这一结论意味着,任何强制的、弱下半连续的泛函在该集合上都能达到最小值。
弱闭性比强闭性更弱,但在变分法中足够保证极小元的存在性。直观上,单隐层ReLU网络可以表示为有限个“折线”函数的组合,其参数空间虽然非紧,但弱闭性确保了极限操作不会“逃出”该集合。
对优化方法的意义
这一结果直接覆盖了几类重要的机器学习训练范式:
- Deep Ritz方法:当被积函数关于梯度是凸的时,能量泛函满足弱下半连续性,因此最小化问题在 $\mathcal{N}_N$ 上有解。
- Sobolev训练:在Sobolev范数下训练网络时,损失函数的强制性和弱下半连续性保证了最优网络的存在。
- Lipschitz学习:类似地,Lipschitz常数约束下的学习问题也可受益于该闭性。
此外,论文还分析了权重衰减正则化的极限行为:当权重衰减参数趋于零时,正则化问题的极小元(沿子列)收敛到具有最小参数范数的极小元。这为理解正则化路径提供了理论依据。
弱闭性是泛函分析中的一个拓扑概念。设 $X$ 是一个自反Banach空间,$C\subset X$ 称为弱闭的,如果对 $C$ 中任意弱收敛序列 $x_n\rightharpoonup x$,都有 $x\in C$。由于弱收敛比强(范数)收敛更弱,弱闭性比强闭性更容易满足。在变分法中,弱闭性之所以关键,是因为它常与强制性和弱下半连续性结合,通过直接方法保证极小元的存在:若 $C$ 弱闭、泛函 $F$ 强制且弱下半连续,则 $F$ 在 $C$ 上达到最小值。对于Sobolev空间 $W^{1,p}(\Omega)$($1<p<\infty$),自反性保证了有界序列存在弱收敛子列,这正是分析ReLU网络集合弱闭性的框架。
Sobolev空间 $W^{1,p}(\Omega)$ 由所有 $L^p(\Omega)$ 中且弱导数也属于 $L^p(\Omega)$ 的函数组成,其范数通常定义为 $|u|{W^{1,p}} = (|u|{L^p}^p + |\nabla u|_{L^p}^p)^{1/p}$。在神经网络分析中,选择Sobolev空间而非连续函数空间,是因为ReLU网络本身是分段线性函数,其梯度在通常意义下几乎处处存在但可能不连续,而弱导数框架可以自然处理这种非光滑性。此外,许多物理和机器学习问题(如Deep Ritz方法)的能量泛函依赖于函数的梯度,因此Sobolev空间是更合适的函数空间。$W^{1,p}$ 的自反性(当 $1<p<\infty$)为弱收敛分析提供了基础。
双隐层网络:闭性失效,猜想被推翻
与单隐层情形相反,论文证明:具有两个隐藏层且每层宽度有界的ReLU网络集合,在 $W^{1,p}(\Omega)$ 和 $C(\overline{\Omega})$ 中都不是闭的。这意味着存在一个双隐层ReLU网络序列,其极限函数无法用相同架构的双隐层网络表示。
这一反例直接否定了Petersen、Raslan和Voigtlaender提出的一个猜想——他们曾猜测双隐层ReLU网络集合在连续函数空间中是闭的。论文的构造表明,宽度有界的双隐层网络在极限下可能“退化”为需要更多层或更宽结构的函数。
理论影响
非闭性带来几个重要推论:
- 变分问题可能无解:对于双隐层架构,即使能量泛函强制且弱下半连续,最小值也可能无法在集合内达到,因为极限点不在集合中。
- 训练算法的不稳定性:梯度下降等算法在参数空间中收敛时,对应的函数可能趋近于一个无法被同架构网络表示的极限,导致“表示崩溃”。
- 逼近理论需要更精细的刻画:闭性失效说明双隐层网络的逼近能力边界比预想的更复杂,可能需要考虑闭包而非集合本身。
函数空间中的闭性指的是:一个函数集合 $S$ 在某个拓扑下是闭的,如果 $S$ 中任何收敛序列的极限仍属于 $S$。在本文中,考虑的是 $W^{1,p}(\Omega)$ 中的强收敛(范数收敛)和 $C(\overline{\Omega})$ 中的一致收敛。若集合非闭,则存在序列其极限不在集合内,这意味着该集合的闭包严格大于自身。对于神经网络集合,非闭性通常源于参数空间的非紧性:网络参数可能无界增长,导致极限函数需要更多神经元或不同架构来表示。这与单隐层情形形成对比,后者在弱拓扑下仍保持闭性,因为弱收敛允许参数在某种平均意义下稳定。
结论与展望
该研究划清了单隐层与双隐层ReLU网络在闭性上的分界线:单隐层在弱拓扑下表现良好,而双隐层则可能“漏出”集合。这提醒研究者和工程师,在设计基于变分原理的深度学习算法时,必须考虑网络架构的拓扑性质。未来工作或可探索更一般的深度架构的闭性条件,以及如何通过修改网络结构或正则化项来恢复闭性。
相关推荐
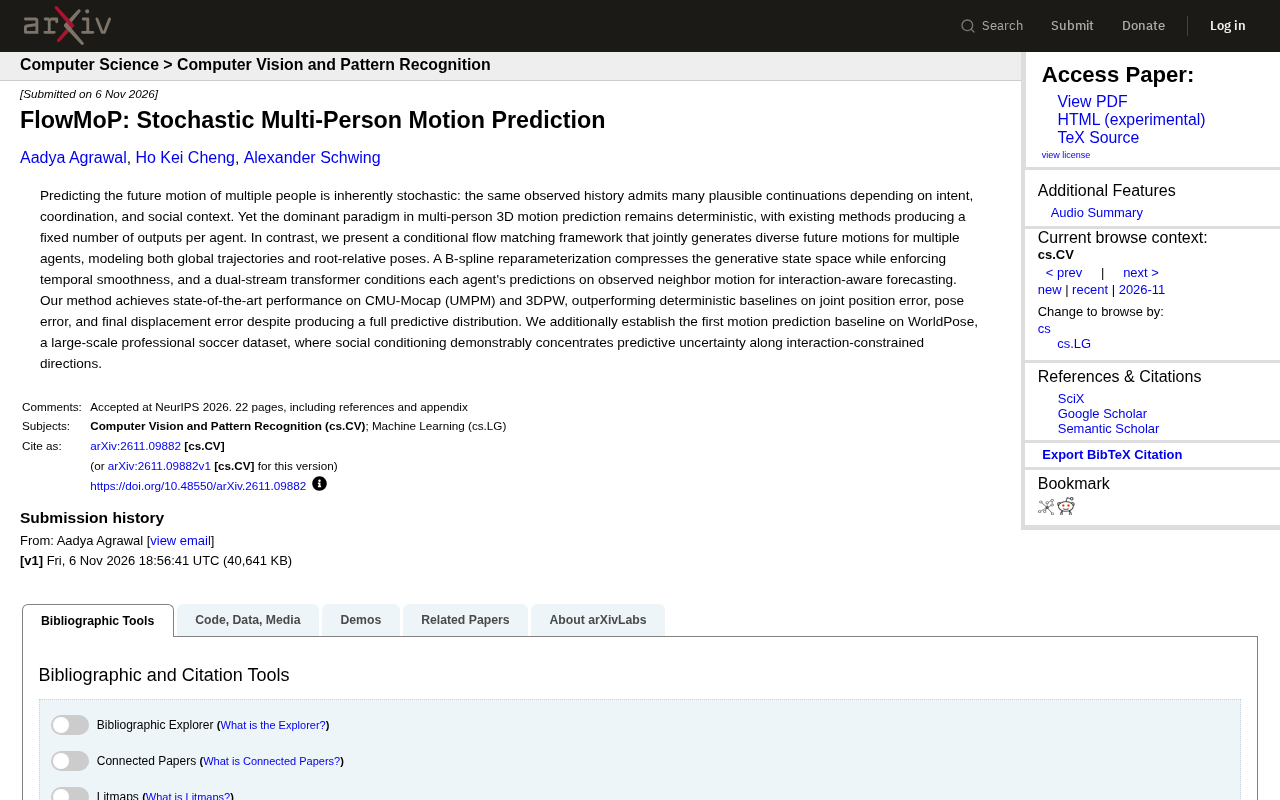
FlowMoP:随机多人运动预测新框架
FlowMoP提出条件流匹配框架,联合生成多个智能体的多样化未来运动,通过B样条重参数化与双流Transformer实现交互感知预测,在CMU-Mocap和3DPW上超越确定性基线,并建立WorldPose首个运动预测基线。
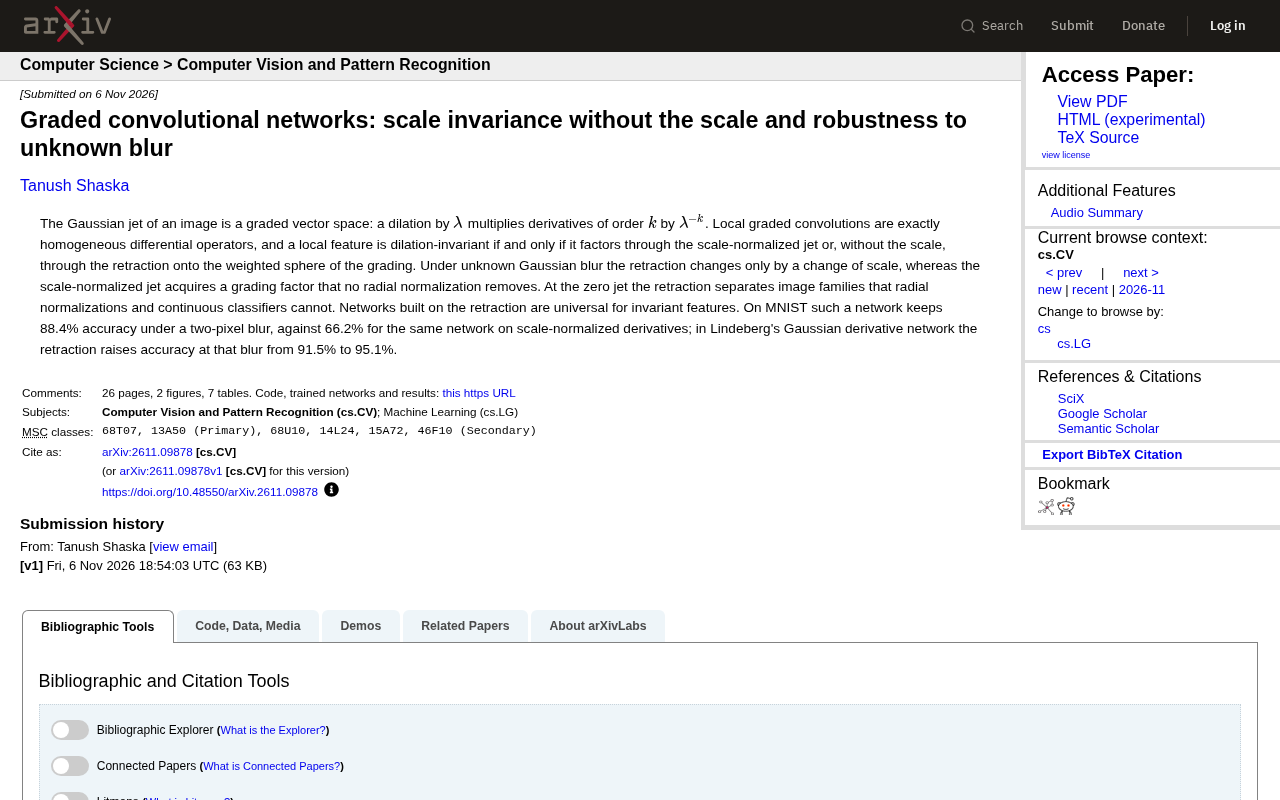
分级卷积网络:无需尺度参数的尺度不变性与抗模糊鲁棒性
分级卷积网络利用图像高斯射流的分级向量空间结构,通过回缩操作实现无需尺度参数的尺度不变性,并在未知高斯模糊下显著提升鲁棒性。MNIST实验显示,两像素模糊下准确率保持88.4%,优于尺度归一化导数的66.2%。

UCR档案翻车?52头猪揭露TSC基准真相
UCR时间序列分类档案遭审计:多个数据集任务被改造、测试划分存缺陷,52头猪数据集揭示TSC基准与真实问题脱节,呼吁更谨慎解读档案分数。