318 tps推理速度意味着什么?大模型性能竞赛深度解析
一条推文引发的性能震撼
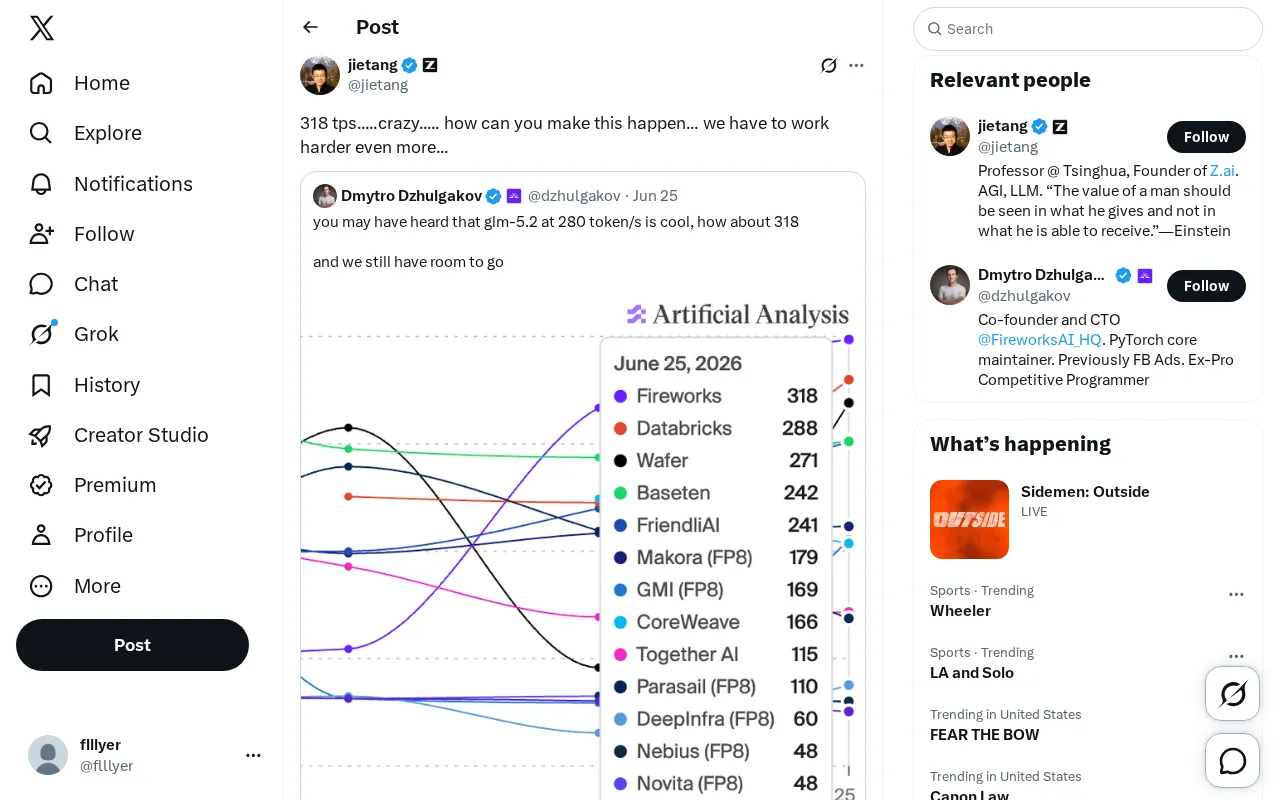
近日,一位AI从业者在Twitter上发出感叹:"318 tps.....crazy..... how can you make this happen... we have to work harder even more..."(318 tps……太疯狂了……你们是怎么做到的……我们还得更加努力……)。这条看似简单的推文,折射出当前大模型推理性能竞赛正进入白热化阶段。
所谓 tps(tokens per second,每秒生成token数),是衡量大语言模型推理速度的核心指标。这里需要先理解什么是token——token是大语言模型处理文本的基本单位,并非简单地等同于一个字或一个词。在英文中,一个token大约对应4个字符或0.75个单词;在中文中,一个汉字通常被编码为1-2个token。因此318 tps在英文场景下大约相当于每秒输出240个单词,在中文场景下约为每秒160-300个汉字。作为参考,人类正常阅读速度约为每分钟200-300个英文单词,即每秒3-5个单词——这意味着318 tps的生成速度已经是人类阅读速度的近50倍。
值得注意的是,不同模型使用的 Tokenizer(分词器) 差异可能影响tps数字的实际含义。主流大模型普遍采用BPE(Byte Pair Encoding,字节对编码)算法进行分词,该算法通过统计语料中字符对的出现频率,迭代地将最高频的字符对合并为新token,最终构建出一个固定大小的词表(通常为32K-128K个token)。例如GPT-4使用约10万token的cl100k_base词表,而LLaMA系列则使用SentencePiece实现的BPE变体。同一段文本在不同模型中可能被切分为不同数量的token,因此跨模型直接比较tps时需要留意这一隐含变量。
318 tps 意味着模型每秒能够生成超过300个token——对于日常对话场景而言,这已经远超人类阅读速度,几乎可以实现"即打即出"的实时体验。这样的数字在一年前还属于难以想象的高端配置,如今却成为行业竞相追逐的新标杆。
为什么318 tps的推理速度如此惊人
从用户体验角度看推理速度差异
在实际应用中,推理速度直接决定了产品的可用性。以常见的对话场景为例:
- 50 tps 以下:能感受到明显的"打字"延迟,长文本生成需要等待数秒;
- 100-150 tps:接近流畅,基本满足实时对话需求;
- 300 tps 以上:几乎瞬间完成,用户几乎无需等待。
当速度突破300 tps后,AI的响应体验发生了质的飞跃。这不仅关乎"快",更意味着可以支撑更复杂的应用场景,比如 实时代码补全、多轮Agent推理、长文档批量处理 等对延迟极度敏感的任务。
从技术实现角度看高吞吐推理
要理解高吞吐推理的技术难度,首先需要了解大模型推理过程中的根本性瓶颈。Transformer架构的大语言模型在生成文本时采用 自回归解码 方式:每一步根据前面所有token的上下文预测下一个token,然后将预测结果追加到输入序列中,循环往复直到生成结束符或达到最大长度。这一过程分为两个阶段:prefill(预填充) 阶段一次性处理整个输入prompt,属于计算密集型操作,GPU利用率高;decode(解码) 阶段逐token生成,每步计算量很小但需要从显存中读取全部模型权重,属于典型的访存密集型操作。对于一个70B参数的FP16模型,每生成一个token就需要从显存中读取约140GB的数据,即使HBM3带宽达到3.35TB/s,理论上也只能达到约24 tps——这就是所谓的"memory wall"(内存墙)问题,也是推理加速需要从多维度协同突破的根本原因。
实现如此高的推理吞吐并非单一因素的功劳,而是软硬件协同优化的结果。业界通常从几个维度发力:
1. 硬件层面:专用推理芯片的崛起
采用专用推理芯片(如Groq的LPU、Cerebras的晶圆级引擎)或最新一代GPU,通过更高的内存带宽和计算密度提升速度。
Groq的LPU(Language Processing Unit,语言处理单元)采用了一种与传统GPU截然不同的架构理念——确定性计算。传统GPU通过大规模并行处理来提升吞吐,但在处理自回归解码(即逐token生成)时存在内存带宽瓶颈,因为每生成一个token都需要从显存中读取全部模型权重。LPU通过将模型权重完全加载到片上SRAM中,消除了对外部HBM显存的依赖,从而将推理延迟降至极低水平。
这里涉及现代AI芯片的 存储层次结构 问题。HBM(High Bandwidth Memory,高带宽内存)是GPU的主存储,如NVIDIA H100配备80GB HBM3,带宽约3.35TB/s;而SRAM(静态随机存取存储器)位于芯片内部,延迟仅为HBM的十分之一到百分之一,带宽可达数十TB/s,但容量极为有限——H100的L2 Cache仅50MB。Groq LPU的激进设计在于将片上SRAM扩展至数百MB级别,足以容纳中等规模模型的全部权重,从而彻底消除访存瓶颈。但这也带来了明显的限制:SRAM的每比特制造成本远高于HBM,且面积占用巨大,使得该方案目前主要适用于参数量较小的模型。
Cerebras则走了另一条更为激进的路线:将整个晶圆直接制成一块巨型芯片(WSE,Wafer Scale Engine),单芯片集成数十万个计算核心和数十GB的片上内存,从根本上消除了多芯片互联的通信开销。这两家公司代表了"推理专用硬件"的两种极端设计哲学,也正是推文作者发出惊叹的可能来源。
2. 模型层面:用更少的计算做更多的事
通过量化、模型蒸馏、稀疏化等手段降低单token的计算成本。
量化技术 是指将模型参数从高精度数值格式(如FP32浮点数,占32位)压缩为低精度格式的过程。INT8使用8位整数表示权重,FP8则使用8位浮点数。精度降低带来的直接好处是:模型体积缩小为原来的四分之一(从FP32到INT8),内存占用和内存带宽需求同比下降,计算速度也因硬件对低精度运算的原生加速而大幅提升——例如NVIDIA的H100 GPU对FP8运算的理论算力是FP32的16倍。业界通过GPTQ、AWQ、SmoothQuant等技术手段,在保持模型输出质量几乎无损的前提下实现了激进的量化压缩。从GPU代际演进来看,A100(2020年)提供312 TFLOPS的FP16算力和2TB/s的HBM2e带宽;H100(2022年)将FP16算力提升至989 TFLOPS并首次引入FP8支持和Transformer Engine;B200(2024年)更是将FP8算力推至9 PETAFLOPS级别,HBM3e带宽达8TB/s。每一代硬件都在为更激进的量化方案提供底层支撑。
模型蒸馏(Knowledge Distillation)最早由Hinton等人在2015年提出,核心思想是让一个小模型(学生模型)学习大模型(教师模型)的输出分布,而非直接从原始数据学习。教师模型的softmax输出包含了丰富的"暗知识"(dark knowledge),例如它对错误答案的概率分配也蕴含了类别之间的相似性信息。通过蒸馏,一个参数量仅为教师模型十分之一的学生模型,往往能保留教师模型80%-95%的性能。在大模型时代,蒸馏被广泛应用于将70B甚至更大参数的模型压缩为7B或更小的高效模型,这也是许多开源小模型性能出人意料的关键原因之一。
稀疏化 的核心理念是:模型推理时并不需要激活所有参数。结构化稀疏通过剪枝(pruning)移除对输出贡献最小的权重连接,非结构化稀疏则利用权重矩阵中大量接近零的值来跳过不必要的计算。更具代表性的是混合专家模型(Mixture of Experts, MoE),如Mixtral 8x7B以及GPT-4被推测采用的架构:模型包含多个"专家"子网络,每个输入token只会被路由到其中2-4个专家处理,其余专家保持休眠。这意味着一个总参数量达数千亿的MoE模型,实际每次推理的计算量可能只相当于一个几百亿参数的稠密模型,在保持大模型能力的同时大幅降低了推理成本。
3. 推理框架层面:榨干每一分算力
借助 speculative decoding(投机解码)、KV Cache优化、continuous batching(连续批处理)等技术压榨每一分算力。
投机解码(Speculative Decoding)巧妙地打破了传统自回归解码中token串行生成的限制。传统方式下,每生成一个token都需要完整地执行一次前向推理,token之间存在严格的依赖关系。投机解码引入一个轻量级的"草稿模型"(draft model),快速预测接下来的若干个token,然后用完整的大模型一次性验证这些预测是否正确。由于验证多个token可以并行完成(本质上是在一次前向传播中同时检查多个位置),当草稿模型的预测命中率较高时,相当于用一次大模型推理就完成了多个token的生成。这项技术在不牺牲任何输出质量的前提下,通常能带来2-3倍的加速效果。
KV Cache优化 是Transformer架构推理加速的关键。在自回归生成中,每个新token的注意力计算都需要参考之前所有token的Key和Value向量。如果不做缓存,每生成一个token就要重新计算整个序列的KV值,计算量随序列长度平方增长。KV Cache将已计算的KV向量保存在显存中,使得每一步只需计算新token的KV并追加到缓存即可。但这也带来了巨大的显存压力——对于长上下文场景,KV Cache可能占据数十GB显存。
业界围绕此问题发展出了一系列优化方案。其中最具影响力的是 PagedAttention,这是vLLM项目的核心技术创新。传统KV Cache管理方式为每个请求预分配一段连续的显存空间,大小按最大可能的序列长度计算,导致严重的内存碎片化和浪费。PagedAttention借鉴了操作系统虚拟内存中的分页机制:将KV Cache切分为固定大小的"页"(如16个token为一页),通过页表映射实现非连续存储,使显存利用率从传统方式的约30%-50%提升至接近100%,直接将同一张GPU能够同时处理的并发请求数提升2-4倍。此外还有GQA(分组查询注意力,减少KV头数量)、MQA(多查询注意力)等从模型架构层面减少KV Cache体积的方案。
连续批处理(Continuous Batching)解决的则是GPU利用率的问题。传统的静态批处理要求一个批次中的所有请求同时开始、同时结束。由于不同请求的生成长度差异可能很大,短请求完成后必须等待最长的请求结束才能释放资源,导致GPU大量空转。连续批处理改变了这一范式:它在每一步解码迭代中动态调度请求,已完成的请求立即释放资源,新请求可以随时插入,使GPU始终保持高负载运行。Orca论文首先提出了这一概念,随后被vLLM、TensorRT-LLM、TGI等主流推理框架广泛采用。
你可能没注意到,推文作者用"how can you make this happen"表达了对竞争对手成果的惊讶,说明318 tps很可能来自某家采用了突破性推理架构的团队——结合上述技术的深度整合,才有可能将推理速度推至如此水平。
推理速度竞赛对AI行业的深远意义
推理效率正在成为新的竞争护城河
过去两年,大模型竞赛的焦点集中在"参数规模"和"基准分数"上。但随着模型能力逐渐趋同,推理效率 正成为区分产品竞争力的关键因素。同样质量的输出,谁更快、谁更便宜,谁就能赢得开发者和企业用户。
以专注推理加速的初创公司为例,Groq和Cerebras等公司通过定制化硬件绕开了传统GPU的架构瓶颈,在特定模型上实现了数倍于主流方案的吞吐。传统GPU架构在推理场景中面临一个根本性矛盾:GPU最初为图形渲染和大规模并行计算设计,擅长的是batch越大越高效的矩阵运算;但大模型的自回归推理本质上是一个序列化过程,每次只生成一个token,计算量小而访存需求大,这使得GPU的计算单元大量闲置——这个问题被称为"memory-bound"(访存瓶颈)。专用芯片正是针对这一痛点进行了架构级的重新设计。这种"专攻速度"的路线,正在重塑整个推理服务市场的格局。
"我们必须更努力"背后的行业焦虑
推文结尾那句"we have to work harder even more",道出了从业者普遍的紧迫感。当竞争对手不断刷新性能天花板时,任何一家团队都无法安于现状。这种良性的竞争压力,客观上加速了整个行业的技术迭代——从推理框架的开源生态到芯片设计的推陈出新,都在这种"军备竞赛"中快速演进。
在开源推理框架方面,不同项目代表了不同的技术定位和创新方向。llama.cpp 由Georgi Gerganov发起,核心价值在于纯C/C++实现,无需GPU即可在CPU上运行量化后的大模型,是端侧部署的基石。SGLang 由Stanford团队开发,引入了RadixAttention(基数注意力)技术,能够在多个请求之间共享KV Cache的公共前缀,对多轮对话和few-shot场景有显著加速效果。vLLM 以PagedAttention为核心,于2023年由UC Berkeley发布后迅速成为开源推理引擎的事实标准。此外还有HuggingFace的TGI提供开箱即用的部署方案,NVIDIA的TensorRT-LLM深度整合其GPU特性实现极致优化。
在芯片层面,NVIDIA从A100到H100再到B200的代际提升持续拉高性能天花板,而AMD MI300X以192GB HBM3容量在大模型推理场景中构成了有力竞争,Intel Gaudi等竞品也在涌入市场。值得注意的是,这场竞赛的参与者不仅包括芯片厂商和云服务商,还包括越来越多的开源社区贡献者——他们通过算法创新不断降低高性能推理的门槛,让更多团队能够在普通硬件上接近顶级性能。
高速推理解锁的实际应用场景
当推理速度不再是瓶颈,许多曾经"不划算"的应用场景变得可行:
- 实时Agent系统:多个模型串联推理时,速度决定了整个链路的可用性。在一个典型的Agent工作流中,一次用户请求可能需要模型进行5-10次甚至更多的推理调用(包括任务规划、工具选择、结果验证等环节)。如果单次推理需要3-5秒,整个链路就会延迟到30秒以上,完全无法满足交互需求。300+ tps让每次推理调用可以在毫秒级完成,使得复杂Agent工作流不再卡顿,真正实现"像人类助手一样思考和行动"的体验;
- 代码智能补全:开发者对延迟极为敏感,研究表明超过200毫秒的延迟就会打断编码思路。高速推理能带来近乎IDE本地补全的流畅体验,这也是GitHub Copilot、Cursor等产品持续优化推理速度的核心原因;
- 大规模内容生产:批量生成、翻译、摘要等任务的成本随速度提升而显著下降。推理速度提升一倍,意味着同样的GPU资源在单位时间内可以处理两倍的请求,直接将每百万token的推理成本砍半;
- 边缘与端侧部署:高效推理技术的下沉,让手机、PC本地运行大模型成为可能。配合量化、蒸馏等模型压缩技术,以及Apple MLX、高通AI Engine等端侧推理框架的成熟,7B参数级别的模型已经可以在旗舰手机上以可用的速度运行,为隐私敏感场景提供了全新的解决方案。
结语:速度只是大模型竞赛的开始
318 tps 的出现,标志着大模型正从"能不能用"迈向"用得爽不爽"的新阶段。但需要理性看待的是,单纯的速度数字并不能代表全部——推理质量、上下文长度、成本效益同样重要。在实际部署中,tps数字往往与具体的模型大小、输入长度、并发用户数等条件密切相关,脱离这些条件谈速度容易产生误导。真正的赢家,是能在"快、准、省"三者间取得最佳平衡的团队。
这场性能竞赛远未结束。正如推文所言,"我们必须更加努力"。可以预见的是,未来一段时间,tps数字还会继续被刷新——从硬件层面的新一代芯片架构到算法层面的持续创新,每一次突破,都将为AI应用的普及铺平道路。而当推理成本降至足够低、速度快至足够快时,我们或许将迎来一个AI能力如同水电一样无处不在的时代。
核心要点
相关推荐

AI检测误判风波:作家被指用AI写作,谁该举证?
2026年英联邦短篇小说奖地区获奖者被Pangram检测工具判定100% AI生成,最终靠草稿自证清白。这起事件揭示了AI检测工具的误判风险与创作者面临的举证困境,以及作家协会承认没有可靠AI检测方法的现实。

Paul Ford新作引热议:Web本身已经足够
Paul Ford 文章《The Web Is More Than Enough》在 Hacker News 引发讨论,主张 Web 标准已足够承载应用开发,反对动辄引入封闭平台。本文梳理其核心论点、与当前 AI 应用潮流的张力,以及对开发者技术选型的实际含义。

斯坦福如何教授AI原生工程:CS146S课程揭秘
斯坦福CS146S课程直面AI一键生成作业的挑战,探索AI原生工程教育。Mihail Eric分享如何将AI作为工程伙伴,培养系统设计和代码审查能力,为工程教育提供新范本。