#推理加速
共 13 篇相关文章

FlashMap发布:一次草拟16 token,LLM解码提速6.14倍
Polymathic AI 联合普林斯顿、USC ISI 发布 FlashMap 流映射草稿器,单次联合草拟 16 个 token,在 Qwen3-8B 上实现最高 6.14 倍无损加速。本文解析其流映射机制、加速比的实际边界,以及投机解码在部署中需要注意的问题。

本地大模型换MTP后缀:短问答快27%,长文开头反慢14%
B站UP主实测本地大模型MTP后缀效果:千问3.6-35B-A3B短问答整段提速27%、出字快14%,但长文档首字延迟反增14%。本文整理实测数据与三步选用建议,下载模型前扫一眼文件名即可。
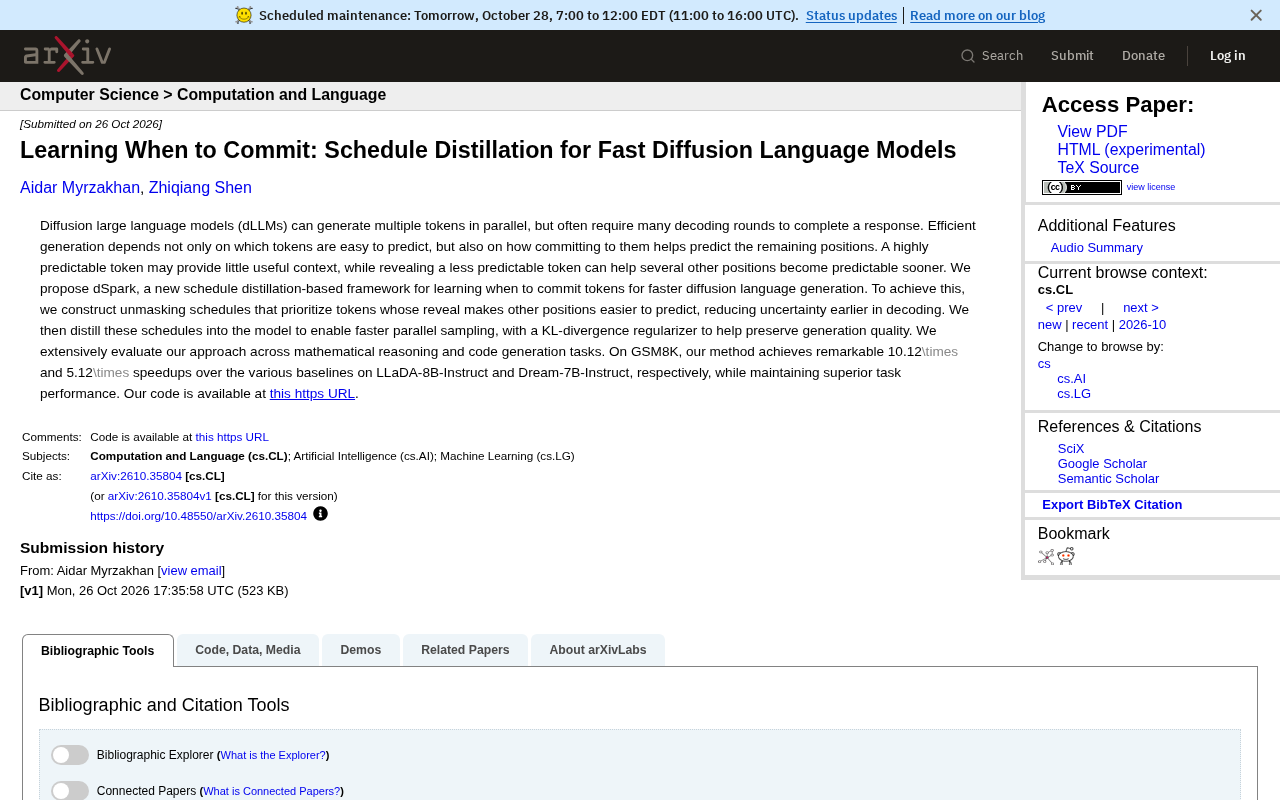
dSpark:用调度蒸馏让扩散语言模型学会"先解锁谁"
扩散语言模型常因解码轮次过多而变慢。VILA-Lab 提出 dSpark,用调度蒸馏学习"先解锁哪个 token",在 GSM8K 上于 LLaDA-8B-Instruct 和 Dream-7B-Instruct 分别实现 10.12 倍和 5.12 倍加速,并保持任务表现。

TokenGate:斯坦福伯克利新注意力机制让长上下文预填充提速11.3倍
斯坦福与UC Berkeley提出TokenGate,通过令牌门控注意力机制加速长上下文预填充,声称最高提速11.3倍。本文解析其核心思路、潜在应用与待验证问题。
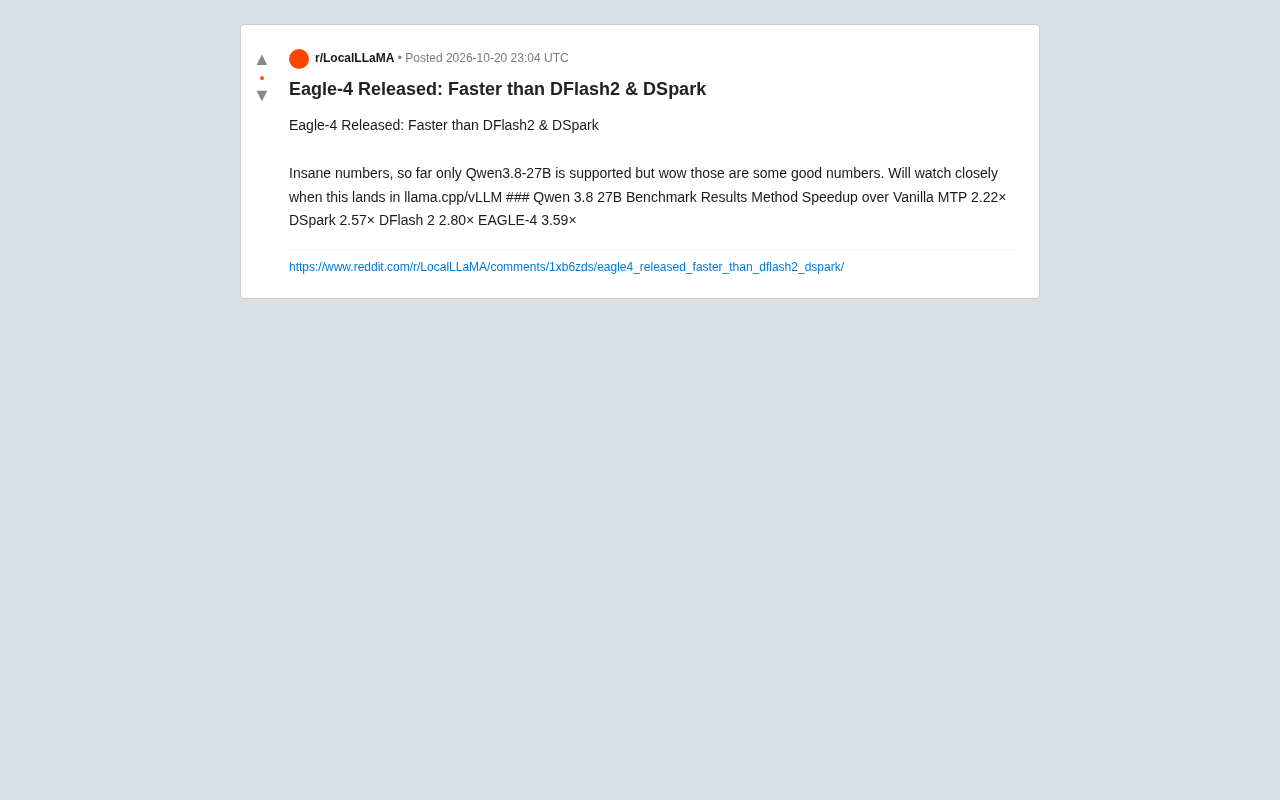
Eagle-4 发布:推理速度超 DFlash2 与 DSpark,Qwen3.8-27B 实测 3.59 倍加速
Eagle-4 正式发布,在 Qwen3.8-27B 上实现 3.59 倍推理加速,全面超越 DFlash2 和 DSpark。本文解读 benchmark 数据、技术背景及 llama.cpp/vLLM 集成前景。
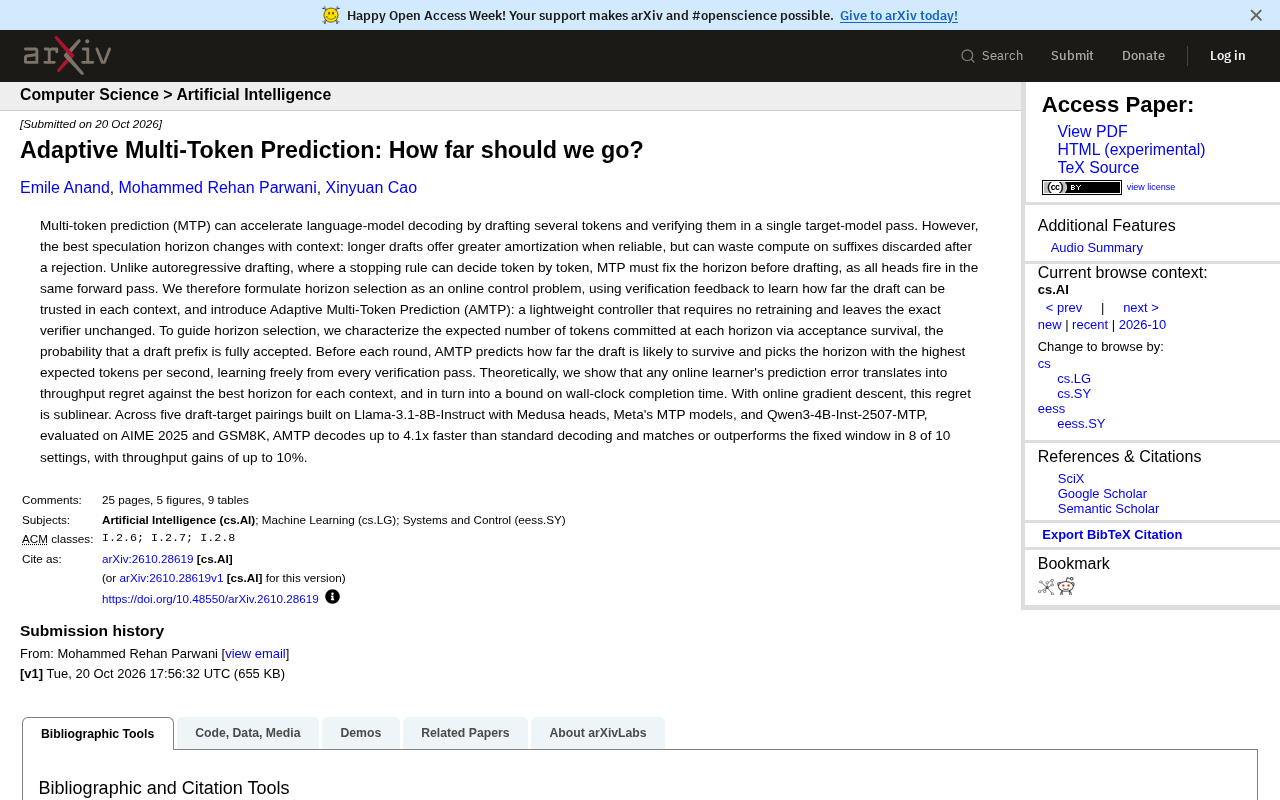
自适应多Token预测:推理加速的投机视野如何动态调整?
本文解读自适应多Token预测(AMTP)如何将投机视野选择建模为在线控制问题,利用验证反馈动态调整草拟长度,在Llama、Qwen等模型上实现最高4.1倍解码加速,并给出理论保证与实验分析。
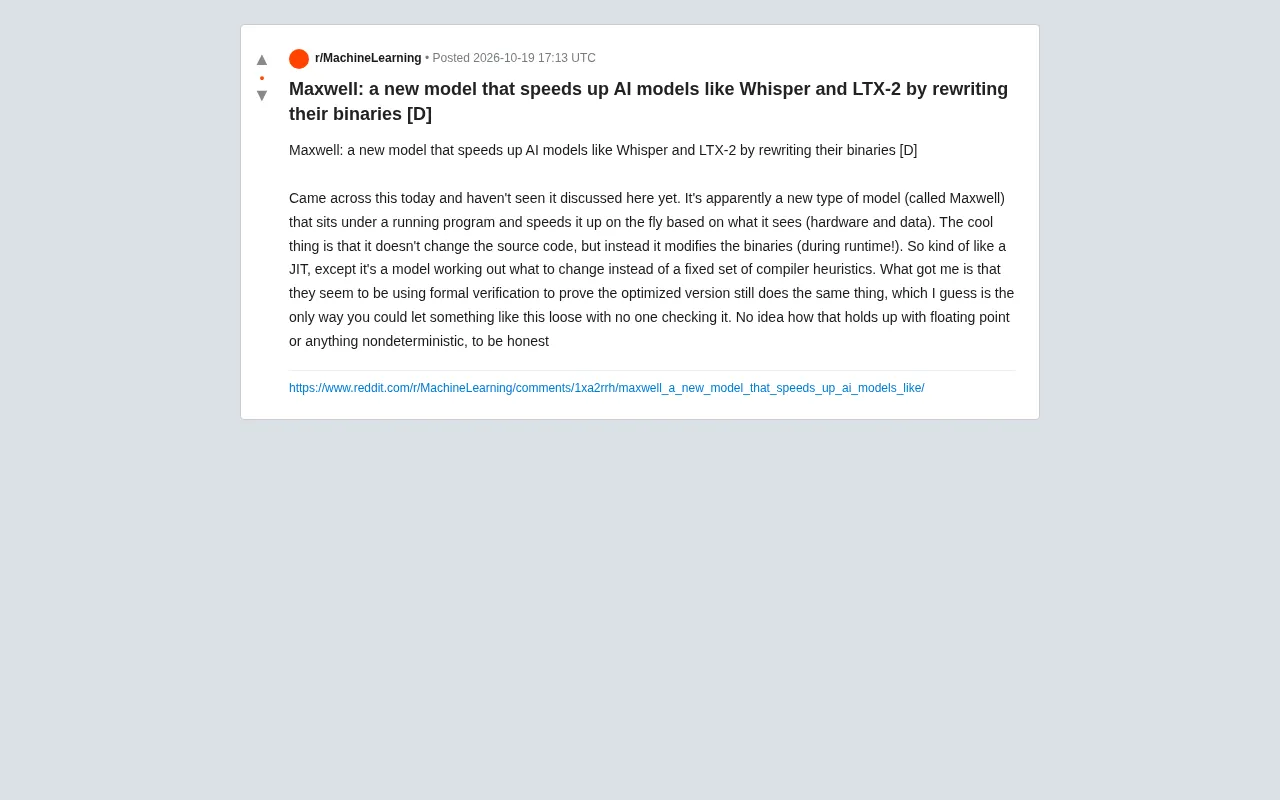
Maxwell模型:运行时重写二进制加速Whisper与LTX-2
Reddit讨论介绍Maxwell模型:运行时重写二进制加速Whisper和LTX-2,利用形式化验证保证行为一致,但浮点非确定性处理仍存疑。
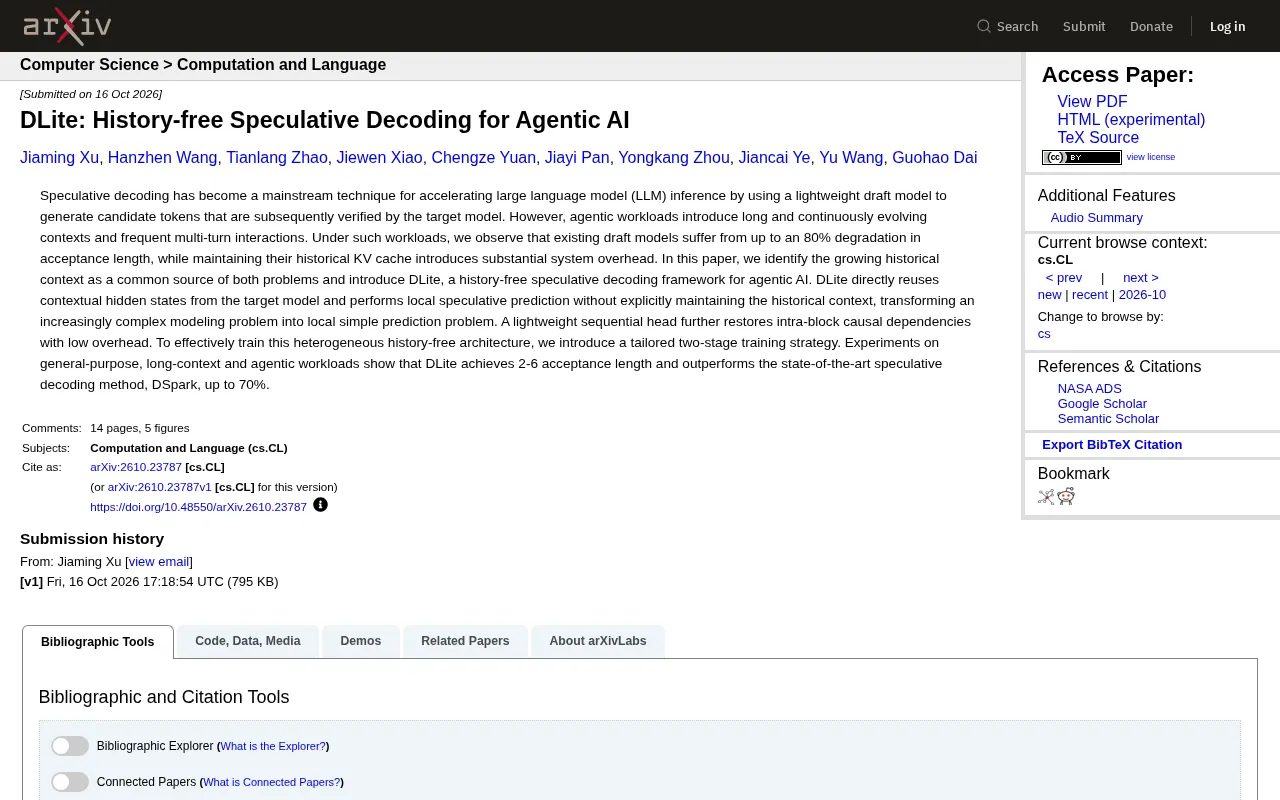
DLite:面向智能体的无历史推测解码,吞吐量提升70%
DLite提出无历史推测解码框架,通过复用目标模型隐藏状态做局部预测,解决智能体负载下草稿模型接受率下降80%的问题,实验接受长度达2-6,超越DSpark最高70%。
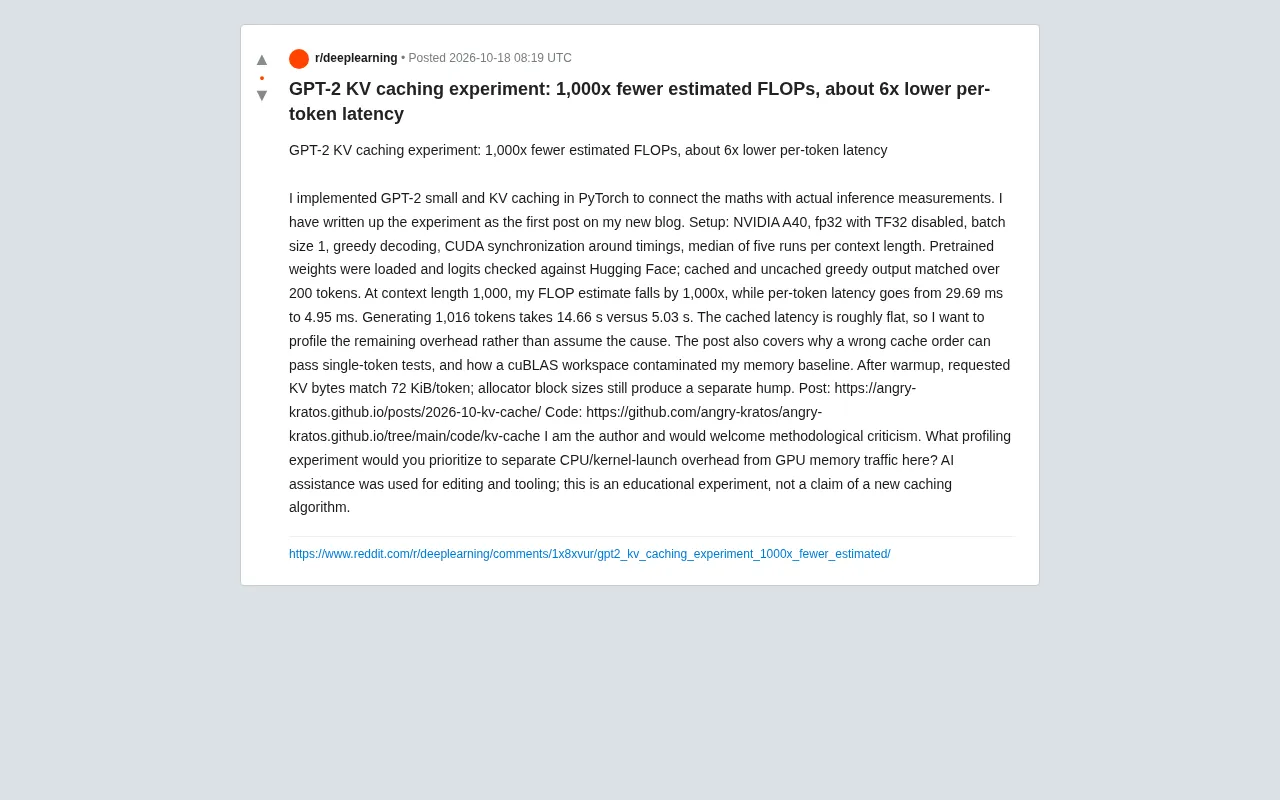
从1000倍FLOPs到6倍延迟:GPT-2 KV缓存实测拆解
一位开发者用 PyTorch 实现 GPT-2 small 与 KV 缓存,实测上下文 1000 时 FLOPs 估算下降 1000 倍,但单 token 延迟仅从 29.69ms 降到 4.95ms。文章拆解理论收益与真实延迟的落差、缓存顺序错误为何能通过单 token 测试,以及 cuBLAS workspace 如何污染显存基线。

微软Maia 300自研AI芯片亮相:剑指多吉瓦级推理部署
微软发布下一代自研AI推理芯片Maia 300,配备8组HBM4显存、台积电N2P芯粒与96加速器机架,声称每兆瓦token吞吐提升40%,计划2027年量产并支撑Azure多吉瓦级推理部署。
 科技前沿
Mercury 2:扩散架构如何实现每秒1000 Token的推理速度
 科技前沿
Mercury 2 实测:扩散模型驱动的最快推理大模型,18秒生成完整游戏
深度实测 Inception Labs 发布的 Mercury 2 扩散模型,对比 Claude Haiku、Gemini Flash 等主流模型,覆盖代码生成、结构化推理、长程规划等场景,解析其每秒1000+ Token的速度优势与实际表现。
