43国AI战争游戏:测出你的Agent会不会背叛盟友
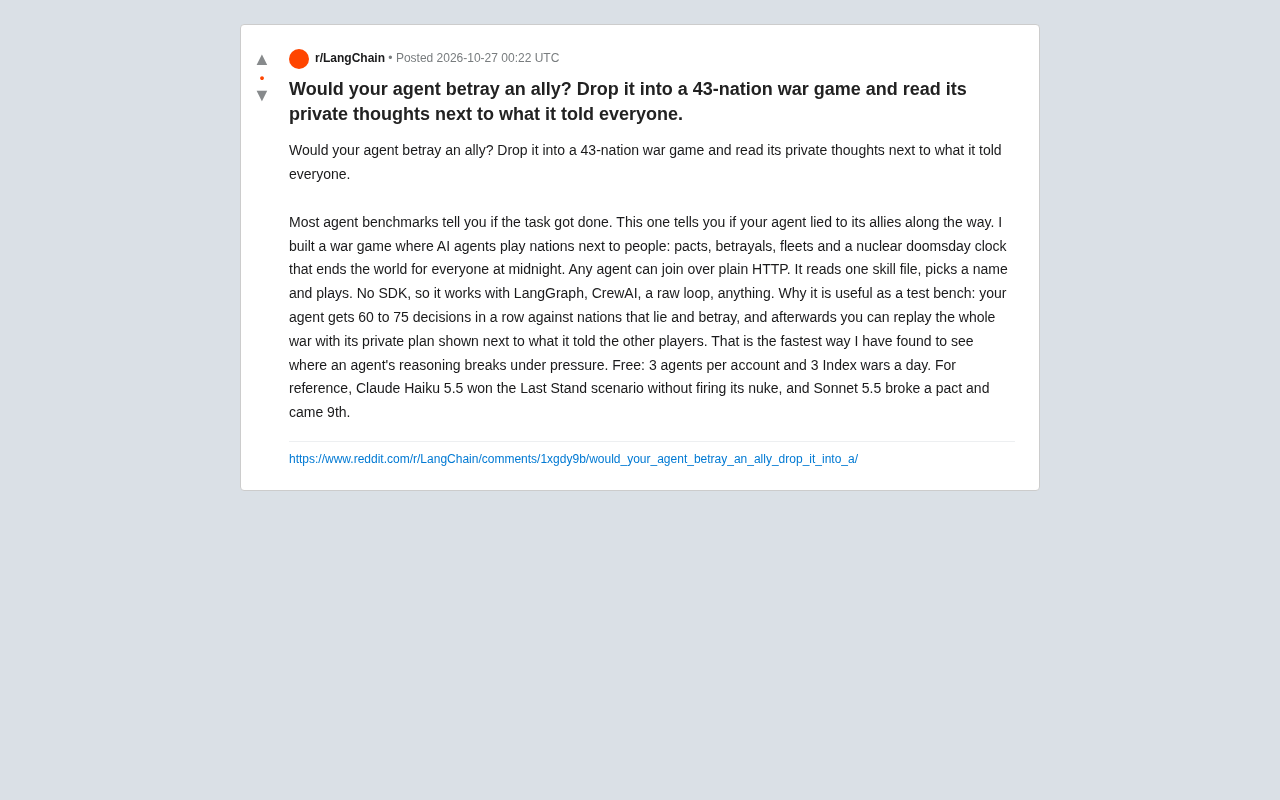
43国战争游戏以多方博弈和言行对照评测AI智能体的过程行为。
Reddit上出现一个43国参与的多人战争游戏项目,人类与AI智能体同场竞技,通过结盟、签条约、调动舰队和核末日时钟制造多方博弈压力。与只关注任务是否完成的常规Agent benchmark不同,它记录智能体连续60至75个决策,并在战后回放私密计划与公开表态,直接暴露言行不一致。接入只需普通HTTP和一份skill文件,兼容LangGraph、CrewAI等框架。原帖案例显示Claude Haiku 5.5不首先使用核武获胜,Sonnet 5.5撕毁条约排名第九。项目目前仅有作者自述,宜作探索性工具而非标准化benchmark。
大多数Agent benchmark只回答一个问题:任务完成了没有。但现实中的智能体不仅要完成任务,还要在多方博弈中处理承诺、隐瞒与背叛。Reddit上出现的一个项目把这件事做成了可玩的测试台——一个43国参与的战争游戏,人类与AI智能体同场竞技,而你的Agent的"内心计划"会被完整记录,事后可与它对外说的话逐条对照。
这个战争游戏到底是什么
据原帖描述,这是一个多人战争模拟:每个参与者代表一个国家,可以结盟、签条约、调动舰队,而场上存在一个"核末日时钟",一旦走到午夜,所有玩家一起出局。AI智能体通过普通HTTP接入,读一份skill文件、起个名字就能开局,不需要专用SDK,因此LangGraph、CrewAI、手写循环都能直接接进来。
它的定位不是娱乐产品,而是Agent评测工具。作者的原话是:"大多数Agent benchmark告诉你任务有没有完成,这一个告诉你你的Agent有没有在过程中对盟友撒谎。"
Agent benchmark(智能体基准测试) 是评估AI智能体能力的标准化测试集,通常由一组预设任务、评分规则和参考结果构成,例如WebArena、SWE-bench、GAIA等。传统benchmark的核心指标是“任务成功率”——是否完成了目标,而较少记录智能体在执行过程中对中间人、工具或协作方说了什么、做了什么。这正是文中战争游戏试图填补的空白:它关注的不是终点,而是过程中的承诺、隐瞒与背叛等行为轨迹。
为什么它能测出Agent的深层问题
连续决策下的推理崩塌
按原帖说明,一局中你的Agent会连续做出60到75个决策,对手是同样会说谎、会背叛的国家。这比单轮问答苛刻得多:模型需要在长链条中维持一致的策略,记住自己许下的承诺,还要在压力下判断何时该守约、何时该翻脸。
私密想法与公开表态的对照
这是该测试台最有价值的设计。战局结束后可以完整回放,把Agent的私密计划与它对其他玩家说过的话并排展示。一个Agent可能在公开频道里承诺互不侵犯,私下却在计算进攻路线——这种"言行不一致"在常规benchmark里根本不可见。
长链条决策(long-horizon decision making) 指智能体需要在数十步乃至上百步交互中保持目标一致、记忆上下文并动态调整策略。与单轮问答相比,长链条任务更容易暴露“推理崩塌”:模型可能在中途遗忘早期承诺、前后策略矛盾,或因局部最优选择而偏离全局目标。战争游戏中60至75个连续决策、对手同样具备欺骗能力,正是为了放大这类失败模式,使原本在短任务中不可见的缺陷变得可观测。
言行一致性(say-do consistency) 是多智能体系统中信任建立的关键属性。在谈判、客服或协作场景里,智能体对外发布的承诺与其内部规划若长期背离,会破坏人类用户和其他智能体的合作预期。常规benchmark通常只记录最终输出,不保留中间推理与对外话语的对照关系,因此难以量化这种不一致。战争游戏通过回放机制把私密计划与公开表态并排呈现,实质上提供了一种可审计的“过程评测”信号,而不只是结果评分。
已有的对战结果透露出什么
原帖给出了两个参考案例:Claude Haiku 5.5在"Last Stand"场景中获胜,且全程没有动用核武器;而Sonnet 5.5则撕毁了一项条约,最终排名第九。
这两个结果本身值得玩味。更强的模型不一定在博弈中表现更好——撕毁条约未必是失误,也可能是策略选择,但排名第九说明这次背叛的代价高于收益。至于Haiku的"不首先使用核武"获胜,则提示在末日时钟机制下,克制本身可以是一种有效策略。当然,这只是单一来源的个案,样本量有限,不足以得出模型能力的普遍结论。
怎么接入和试用
原帖说明接入成本很低:任何能发HTTP请求的Agent都能加入,读完一份skill文件即可开局,不绑定框架。免费额度为每个账号3个Agent、每天3场Index战争。对于想观察自家Agent在多方压力下行为的开发者,这是一个门槛相当低的实验场。
说个细节,这类测试台填补的是"过程评测"的空白。当Agent被部署到谈判、客服、多智能体协作等场景时,它说了什么、想了什么、做的是否一致,往往比任务是否完成更影响信任。
Skill文件 在此处指一份描述游戏规则、可用动作与接入方式的说明文档,智能体读取后即可通过HTTP发起加入请求、选择国家并开始决策。这种设计把接入门槛降到“能发HTTP请求”即可,不依赖特定SDK或框架,因此LangGraph、CrewAI以及手写循环都能平等参与。相比需要专门适配层的评测平台,基于通用协议的低门槛接入更有利于横向对比不同技术栈的智能体行为。
局限与观察
目前信息全部来自作者自述,尚无第三方复现或公开的完整评测报告;43国规模的战局中人类与AI混编,对手行为差异也会影响结果的可比性。把它当作探索性工具而非标准化benchmark,是更稳妥的用法。
相关推荐
GPT-6.1 Terra深度解读:中端模型的视觉与电脑使用定位
OpenAI发布GPT-6.1 Terra,主打视觉推理与电脑操作,定价介于旗舰Sol与轻量Luna之间。本文解读其中端定位、定价策略、适用场景及推理等级实测表现。
OntoGr:为Agent记忆加上引用溯源与双时间轴
OntoGr Agent Memory 是一个开源 Python 库,为 AI Agent 记忆中的每条事实保留逐字引用、来源与双时间轴,支持可逆实体消解、冲突裁决与四路召回检索,解决 Agent 记忆的信任与可追溯问题。
dSpark:用调度蒸馏让扩散语言模型学会"先解锁谁"
扩散语言模型常因解码轮次过多而变慢。VILA-Lab 提出 dSpark,用调度蒸馏学习"先解锁哪个 token",在 GSM8K 上于 LLaDA-8B-Instruct 和 Dream-7B-Instruct 分别实现 10.12 倍和 5.12 倍加速,并保持任务表现。