530万参数服饰分类器Pasma:小模型逆袭还是场景限定?
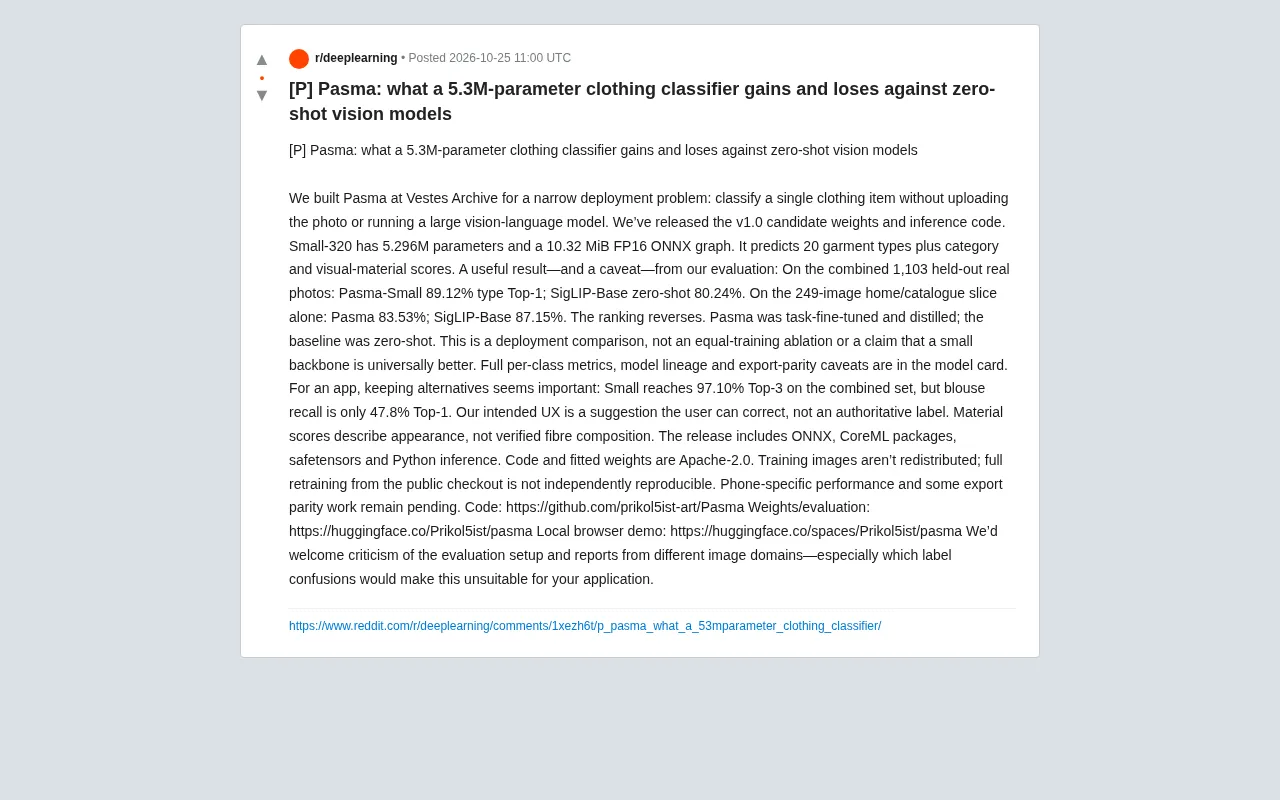
5M参数小模型微调后在综合集领先零样本大模型,但家居目录子集反转,揭示域偏移代价。
Vestes Archive 开源了仅 5.296M 参数、10.32MiB ONNX 图的 Pasma-Small-320,用于单件衣物分类。在 1,103 张真实照片合并集上,其任务微调后的 Top-1 准确率达 89.12%,高于零样本 SigLIP-Base 的 80.24%;但在 249 张家居/目录图片子集上排名反转(83.53% vs 87.15%),说明微调模型对训练分布更敏感。作者明确定位为部署对比而非公平消融,并指出 blouse 类别 Top-1 召回仅 47.8% 的类别不均衡短板。模型以 Apache-2.0 发布 ONNX、CoreML、safetensors 及推理代码,但训练图像不分发导致无法完全复现。结论是:小模型适合端侧隐私场景,但需在业务数据上验证并保留零样本备选。
在小模型与零样本视觉模型之间做选择时,一项来自 Vestes Archive 的实践给出了一个不寻常的答案:任务微调后的小模型在综合测试集上大幅领先,却在特定场景中败下阵来。
他们开源的 Pasma-Small-320 仅有 5.296M 参数,FP16 ONNX 图仅 10.32 MiB,却要挑战 SigLIP-Base 这类零样本大模型。评估结果的“反转”比胜负本身更有讨论价值。
评估设置:部署对比而非公平消融
Pasma 解决的部署问题非常具体:在不上传照片、不运行大型视觉语言模型的前提下,对单件衣物做分类。输出包括 20 种服装类型,以及类别和视觉材质评分。
按作者在 Reddit 原帖中的说明,Pasma 是任务微调并蒸馏的结果,而 SigLIP-Base 保持零样本状态。因此这个对比的定位是“部署对比”(deployment comparison),不是等训练量的消融实验,也不能据此宣称小骨干网络普遍更强。
这一声明本身值得肯定。很多小模型对比文章容易忽略基线是否经过同等训练,导致结论被夸大。
零样本(Zero-shot) 指模型在没有针对下游任务进行任何微调或示例的情况下,直接完成分类或识别。SigLIP-Base 属于视觉-语言对比学习模型,通过大规模图文对训练,将图像和文本映射到同一嵌入空间,推理时用文本描述(如“a photo of a blouse”)与图像匹配实现分类。其优势是泛化性强、无需任务数据,但计算量和参数量远大于专用小模型。
任务微调与蒸馏则是在特定数据集上继续训练,或让小模型模仿大模型输出,以牺牲部分泛化性换取目标域精度和极小体积。两者训练目标、数据暴露程度和部署成本都不同,因此文中强调这是“部署对比”而非控制变量的消融实验。
数据反转:综合集领先,家居目录集落后
在 1,103 张留出的真实照片合并集上,Pasma-Small 的服装类型 Top-1 准确率为 89.12%,SigLIP-Base 零样本为 80.24%,差距接近 9 个百分点。
但在仅包含 249 张家居/目录图片的子集上,排名完全颠倒:Pasma 为 83.53%,SigLIP-Base 为 87.15%。
这说明微调模型对训练分布更敏感——在相似风格上表现强势,一旦遇到目录级白底图或特定拍摄风格,泛化能力就可能落后于零样本大模型。作者也明确表示,这并非要证明小模型在所有场景下都更优。
域偏移(Domain Shift) 指测试数据分布与训练数据分布不一致,例如训练集多为生活场景照片,而测试集出现白底目录图、不同光照或拍摄角度。微调模型容易过拟合训练分布,遇到新风格时性能下降更明显;零样本大模型因见过更广泛的图文数据,对风格变化通常更稳健。这也是家居/目录子集上排名反转的可能原因。
Top-1 与 Top-3 准确率是分类任务常用指标:Top-1 要求最高概率类别正确;Top-3 只要正确类别出现在概率最高的三个候选中即算命中。Top-3 更高说明模型虽不一定直接给出正确答案,但能把正确选项保留在候选列表里,适合“建议+用户纠正”的交互流程。
Top-3 可用性与最弱类别
对实际应用来说,Top-1 往往不是唯一指标。Pasma-Small 在合并集上的 Top-3 准确率达到 97.10%,这意味着把它当作“建议候选”有相当的可操作性。
但作者点出了一个关键短板:blouse(女式衬衫)的 Top-1 召回只有 47.8%。仅看总准确率容易忽略这种类别级的不均衡。
他们的设计思路是将输出定位为用户可纠正的建议,而不是权威标签。材质评分也仅描述外观,不代表经过验证的纤维成分。
发布内容与复现性边界
本次发布 v1.0 候选权重与推理代码,包含 ONNX、CoreML 包、safetensors 和 Python 推理实现,代码与拟合权重采用 Apache-2.0 许可。作者同时提供了本地浏览器 demo。
需要留意复现性限制:训练图像不再分发,因此无法从公开代码完全独立复现训练过程。手机端性能和部分导出对齐工作仍未完成。
ONNX 是开放的神经网络交换格式,可让模型在不同框架和硬件上运行;CoreML 是苹果的端侧推理框架,便于在 iOS/macOS 设备本地执行;safetensors 是一种安全高效的权重存储格式。三者同时发布,说明作者兼顾了跨平台部署和端侧推理需求。
Apache-2.0 是宽松开源许可,允许商用、修改和再分发,但需保留版权与许可声明。需注意许可覆盖代码与拟合权重,不覆盖训练图像,而训练数据不分发正是复现性受限的关键——没有原始数据,第三方无法重新训练出完全相同的模型。
多源信息交叉验证
来自 Gitee 的仓库镜像、Hugging Face 模型页与 Reddit 原帖三处信息相互印证:模型规模、评估数字与许可协议保持一致,作者也公开邀请针对评估设置和跨域表现的批评。
不过需要说明,“家居目录子集排名反转”这一结论目前仅来自作者单方评估,尚未看到第三方独立复现。若你的应用场景偏向电商白底图,建议先在自有数据上验证再决定是否采用。
对落地选型的启示
Pasma 的价值不在于证明小模型“打败”了大模型,而在于展示了特定部署约束下的工程取舍:5M 级参数、10MB 级模型体积,适合端侧或隐私敏感场景。
但类别召回不均衡、域偏移敏感、训练数据不可复现,都是选型时必须面对的代价。对开发者而言,更务实的做法是保留零样本模型作为备选,并在业务数据上测量小模型的实际表现。
作者也公开征集不同图像域的报告,尤其是哪些标签混淆会导致模型不适用于具体应用。这种开放态度,比一个漂亮的准确率数字更有参考价值。
相关推荐

Cursor免费版8分钟建生产级应用,却败在同一个安全细节
Cursor免费版用8分12秒构建生产级Node+Postgres应用,22项API测试与界面检查全绿,比Copilot快6分钟,但默认密钥、无法撤销的JWT会话和登录无限流三个问题暴露了AI编程工具的安全盲区。
GoHighLevel对话AI接入MCP:智能体可调用40+外部应用
GoHighLevel 对话 AI 新增 MCP 支持,智能体可在对话中调用 40+ 外部应用完成预约、付款、表格写入等操作。了解功能限制、配置方法和上线时间。
物业管理软件为何必须拥抱AI与MCP协议
物业管理软件正转向开放生态。某系统已上线MCP服务器并筹备云端连接器,支持AI智能体接入与自定义工作流。本文分析MCP、开放API为何成为物业软件选型新标准。