7.72TB假Anthropic模型被逆向拆穿

7.72TB Anthropic 泄露模型被取证证明为伪随机生成,非训练所得。
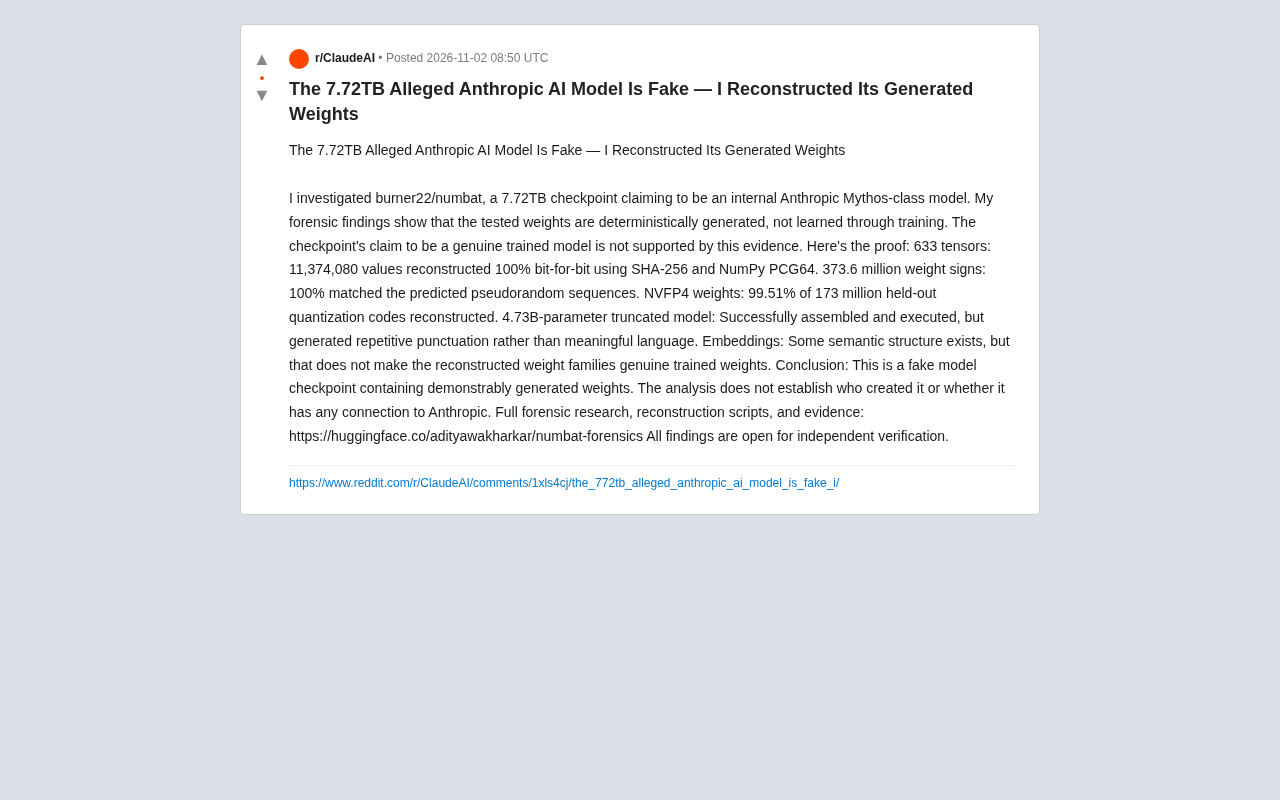
一个标注为 7.72TB、声称是 Anthropic 内部 Mythos 级模型的 checkpoint 在社区流传。研究者 adityawakharkar 用 SHA-256 与 NumPy PCG64 伪随机数生成器对权重做逆向取证,成功以 100% bit-for-bit 精度重建了 633 个张量共 11,374,080 个数值,373.6 百万个权重符号位完全匹配伪随机序列。截断至 4.73B 参数的模型虽可运行,但只输出重复标点。部分 embedding 呈现语义结构,但不足以证明权重来自真实训练。结论是 checkpoint 系伪造生成,但未确定伪造者身份,也未证明与 Anthropic 有关联,全部脚本已公开供独立验证。
一个标注为 7.72TB 的模型 checkpoint 在社区里流传,声称是 Anthropic 内部 Mythos 级模型的泄露。一位研究者对它做了取证分析,结论是:这些权重不是训练出来的,而是用伪随机数生成器"造"出来的。
事件背景:一个声称来自 Anthropic 的巨型 checkpoint
涉事仓库为 burner22/numbat,体量 7.72TB,自我描述为 Anthropic 的内部 Mythos 级模型。如此规模的 checkpoint 在开源社区极为罕见,加上"内部模型泄露"的叙事,很容易引发关注与转发。
研究者 adityawakharkar 没有停留在猜测层面,而是直接对权重做了逆向取证:用确定性的方法尝试重建这些张量,看它们是否能被算法完整复现。如果权重真的来自训练,就不可能被一个伪随机序列逐位还原。
取证方法:用生成器"复刻"权重
分析的核心思路是验证权重的可复现性。研究者的做法是用 SHA-256 与 NumPy 的 PCG64 伪随机数生成器,尝试从种子推导出 checkpoint 中的数值,再与原始权重逐位比对。
据其公布的取证结果,关键证据包括:
- 633 个张量、共 11,374,080 个数值,被以 100% bit-for-bit 的精度重建;
- 373.6 百万个权重符号位,100% 匹配预测的伪随机序列;
- NVFP4 量化权重中,1.73 亿个留出量化码有 99.51% 被重建;
- 截断到 4.73B 参数的模型可以成功组装并运行,但输出的是重复标点,而非有意义的语言。
这组数据的指向很明确:权重分布符合伪随机生成的特征,而非训练过程中梯度下降留下的统计结构。
PCG64 伪随机数生成器是 NumPy 默认的随机数引擎,属于 PCG(Permuted Congruential Generator)家族。它由一个线性同余生成器产生基础状态,再通过置换和异或移位等输出函数打乱比特,从而获得统计质量较好、周期极长(约 2^128)的随机序列。PCG64 的确定性意味着:给定相同的种子和调用顺序,它输出的比特流完全可复现。这正是取证分析能够逐位重建权重的技术前提——如果造假者用 PCG64 生成张量数值,研究者只要猜中种子和生成逻辑,就能还原出完全相同的序列。
NVFP4 是 NVIDIA 提出的一种 4 位浮点量化格式,主要用于在 Blackwell 架构 GPU 上高效存储和计算大模型权重。它用 4 个比特表示一个数值,包含 1 位符号、2 位指数和 1 位尾数,并配合块级缩放因子来扩展动态范围。相比 FP8 或 INT4,NVFP4 在精度和显存占用之间做了新的权衡。在伪造场景中,量化码同样可以由伪随机数生成,因此留出量化码的高比例重建结果,进一步佐证了权重并非来自真实训练后的量化流程。
唯一像"真"的部分:Embedding 的语义结构
分析中有一个容易被误读的细节:部分 embedding 确实呈现出一定的语义结构。这看起来像是"模型被训练过"的证据,但研究者明确指出,语义结构的存在并不足以证明这些重建出来的权重家族是真实训练所得。
一种合理的解释是,生成器在构造 embedding 时采用了带有某种结构的初始化或映射方式,使得向量空间中出现了可被观察到的聚集现象。但权重的整体可复现性才是判定真伪的决定性指标——真正训练出的权重不会以 bit-for-bit 的方式被伪随机序列还原。
Embedding 的语义结构通常指词向量空间中语义相近的 token 彼此靠近,例如"猫"和"狗"的向量夹角较小,并能支持类比运算。在真实训练的模型中,这种结构是梯度下降在大量语料上优化的副产品。但语义结构并非训练独有的标志:如果生成器在构造 embedding 时使用了带结构的初始化(如按 token 频率或哈希分桶映射),或者对随机向量做了某种线性变换,也可能在降维可视化中呈现出聚类。因此,单凭 embedding 的语义外观无法区分"训练所得"与"结构化生成",必须结合权重的整体可复现性来判断。
结论与边界:假 checkpoint,但来源仍未定
研究者的结论是:这是一个伪造的模型 checkpoint,其权重可被证明是生成而非训练所得。
同时也划清了证据边界:现有分析并未确立伪造者的身份,也没有证明该 checkpoint 与 Anthropic 存在任何关联。这一点很重要——证明"模型是假的"和证明"谁造了假"是两件事,前者已有充分证据,后者仍是开放问题。
全部取证研究、重建脚本与证据已公开在 Hugging Face 的 adityawakharkar/numbat-forensics 仓库,供独立验证。这种开放取证的做法本身值得肯定:结论可以被任何人复跑脚本检验,而不是停留在单方面的断言上。
对模型社区的提醒
这起事件暴露出大模型生态中一个被低估的风险:checkpoint 的体量和命名可以轻易制造可信度。TB 级的文件大小、内部项目的名号、加上一个看起来合理的模型架构,就足以让一部分人相信它的真实性。
对下载和使用来源不明权重的开发者来说,这个案例给出的教训是直接的:体量不等于真实性,权重文件需要可验证的来源链条。对于声称来自闭源实验室的"泄露模型",在没有独立取证的情况下,默认应当保持怀疑。
取证工具链的成熟也让这类造假更难遁形——只要权重是算法生成的,就有被逆向复现的可能。这对造假者是一种威慑,对社区则是一种保护。
相关推荐

Reddit帖子被删引发AI内容审核争议
Reddit一则帖子被平台以违反内容政策为由删除,页面仅显示移除提示。事件折射出AI内容审核系统在透明度、误判风险和申诉机制方面的普遍困境,值得内容平台与创作者关注。

DSH+Ollama本地部署大模型实战:免费对话大肥鱼
B站UP主实测DSH+Ollama本地部署大模型全流程:从Ollama安装、迅雷加速下载、魔搭GGUF模型导入,到DSH自定义API地址配置,并对比千问3.5 4B、8B、Gemma等模型在8G显存下的表现,给出本地部署与API调用的选择建议。

899元Mac Mini实测:能替代200美元AI订阅吗?
实测M4 Mac mini能否替代200美元AI订阅:16GB内存装不下大模型,速度与质量均有差距,但隐私、无上限和近零运行成本让它成为常驻智能体的理想宿主。附各配置选购建议与省钱策略。