899元Mac Mini实测:能替代200美元AI订阅吗?

Mac mini不是订阅的替代品,而是本地常驻智能体的宿主,混合架构才是正解。
文章通过一位UP主用M4 Mac mini的实测,回答900美元机器能否替代每月200美元AI订阅的问题。结论是不能简单替代,但可组成混合架构。核心瓶颈是内存:16GB机型实际只剩10到12GB,装不下主流27B模型,代理场景还需手动调大上下文。实测7B模型约每秒13 token,但长提示词预填充耗时2分20秒,云端不到3秒。前沿开源模型需约236GB内存,Mac mini顶配也装不下,追前沿需256GB Mac Studio,回本约四年且更慢更笨。本地真正的价值是隐私、无额度上限和近零运行成本。务实策略是本地小模型处理私密与计划任务,难题外包给云端,32GB内存是选购底线。
一台900美元左右的Mac mini,能否干掉每月200美元的AI订阅?这个问题看似简单,背后却涉及模型运行原理、内存限制、任务类型和成本核算的复杂权衡。一位B站UP主用他的M4 Mac mini做了详细实测,结论既不是“能”也不是“不能”,而是一套更聪明的混合策略。
为什么你会想用Mac mini替代订阅?
AI代理可以拆成两部分:身体和大脑。身体是持续运行的电脑,负责跑任务;大脑是云端的大模型,负责思考。订阅费本质上买的是三样东西:模型本身、数据中心的读取算力,以及使用额度。Mac mini理论上三样都能自己扛——它能当模型宿主、自己做读取、还没有额度上限。问题在于,它真的扛得动吗?
内存才是真正的瓶颈
任何机器跑本地模型,最重要的规格不是芯片,而是内存。整个模型必须装进RAM,装不下就跑不了。Mac的内存是共享的,16GB机型上macOS和日常应用已经占用了近14GB,留给AI模型的部分只有10到12GB。常见的27B参数模型需要16到18GB内存,根本塞不进去。
模型大小用参数量衡量,参数越多通常越聪明,但也越大。速度方面,模型每写一个token,芯片需要读一次内存,所以速度大致等于内存带宽除以模型大小。苹果官方数据称M4 Mac mini的内存读取速度为120GB/s,据此推算7GB左右的模型能达到每秒15到20个token。UP主实测用Ollama跑一个7B级别的模型总结维基百科页面,速度约为每秒13个token,但处理提示词花了2分20秒,而云端模型不到3秒就开始回答。
统一内存架构(Unified Memory) 是苹果自 M 系列芯片起采用的设计:CPU 和 GPU 共享同一块物理内存池,而不是像传统 PC 那样各有独立显存。这对本地跑模型有两面性。好处是 GPU 可以直接访问全部系统内存,无需把模型权重先复制到显存,因此一台 32GB 的 Mac 理论上能让 GPU 用上接近 32GB 来跑模型。坏处是这块内存还要同时养活 macOS、浏览器、编辑器等所有应用,实际可分配给模型的余量往往比标称值少 4 到 6GB。这也是原文强调“标称 16GB、实得 10 到 12GB”的原因,选购时应按可用余量而非标称容量估算能装多大的模型。
代理场景暴露真实差距
短问答的速度测试意义有限。代理每次向模型发送的不只是用户消息,还包括指令、记忆、可用工具列表以及完整对话历史。模型在写第一个字之前必须先读完所有这些内容,这个过程叫pre-fill。在内存小于24GB的Mac上,Ollama默认只给模型约4000个token的上下文,而代理至少需要64000,必须在设置里手动调整,否则任务跑到一半就会丢失上下文。
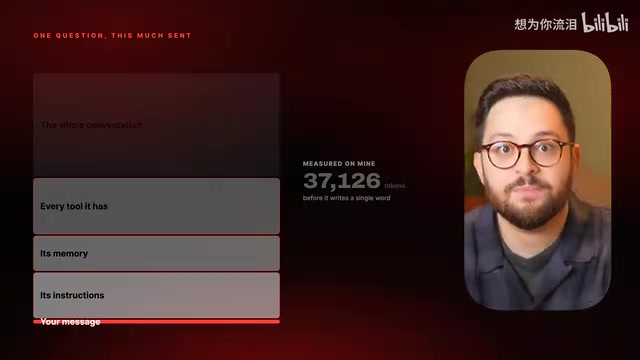
加长提示词后,本地模型的等待时间显著拉长。但UP主指出,等待本身未必是致命伤——对于睡觉时按计划跑的任务,等10分钟和等2分钟没有区别,因为人根本不在旁边。真正的限制是质量:小模型在复杂任务上会输,但在干净简单的任务上完全可用。
pre-fill(预填充)与 token 生成是两个阶段。pre-fill 指模型一次性读入整段提示词、建立注意力缓存的过程,它可以并行处理,通常比逐字生成快,但耗时随提示词长度线性甚至更快增长。token 生成则是逐字串行输出,每步都要读一遍模型权重。代理场景的提示词里包含系统指令、工具定义、历史对话和检索到的记忆,动辄数万 token,于是 pre-fill 成为主要等待来源——原文中“2 分 20 秒才开始回答”正是卡在这一步。上下文窗口则是模型一次能容纳的最大 token 数,Ollama 默认给的约 4000 token 远小于代理所需,超出部分会被截断,表现为模型“忘了”前面的指令或工具,任务因此中断。
前沿开源模型:想跑也跑不动
根据Artificial Analysis的评分图表,最好的付费模型得分在58左右,最好的开源模型大约在44到46分,差距在缩小。但整张图上最强的开源模型参数量超过1万亿,即使大幅压缩,光加载就需要约236GB内存。最顶配的Mac mini只有64GB,售价约2700美元;要装下这样的模型需要256GB内存的Mac Studio,大约9500美元。按每月200美元的订阅费计算,光回本就要约四年,而且回本之后机器仍然更慢、更笨。
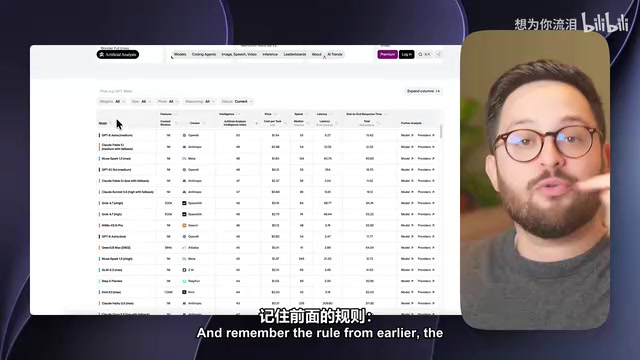
所以,在家追前沿大脑这条路,在Mac mini上走不通。这也意味着,本地跑小模型时,你替代的并不是200美元的云端大模型,而是同一个模型在线租用的成本——后者便宜到几乎可以忽略,100万token约10美分,代理跑一整天也就几美元。钱从来不是本地化的理由。
量化(Quantization) 是把模型权重从 16 位浮点压缩到 8 位、4 位甚至更低的表示,用少量精度损失换取内存和速度的大幅下降。常见格式如 GGUF 的 Q4_K_M 能把模型压到原体积的四分之一左右,这也是消费级硬件能跑 7B 到 14B 模型的关键。但量化有下限:参数规模本身的绝对值不会消失,1 万亿参数的模型即便压到 4 位仍需数百 GB,且低比特量化会明显损伤推理与工具调用能力。所以原文所说的“即使大幅压缩仍需约 236GB”并非夸张——量化能让小模型挤进 Mac mini,却无法把前沿大模型塞进 64GB 内存。
本地运行真正不可替代的三件事
订阅再贵也给不了的东西,才是Mac mini的价值所在。第一是隐私:数据永远不离开房间,收件箱、日历、文档不会被发送给任何公司。第二是没有上限:没有五小时限制,没有每周限额,全天候运行。第三是运行成本趋近于零:UP主称这台Mac mini待机功耗4瓦、满载65瓦,按荷兰每度26美分电费计算,待机一整月约74美分,即使整月满载也只有约12美元。
这三件事指向同一个定位:Mac mini不是订阅的替代品,而是常驻智能体最好的家。私密任务、重复任务、睡觉时跑的任务交给本地小模型,遇到难题再把单个任务转交给付费大脑。
混合架构在实践中通常由一个调度层来实现:代理框架根据任务属性决定走本地还是云端。私密数据(邮件、日历、本地文件)只在本地模型处理,避免外发;重复性、可排期的任务(每日摘要、文件整理)放本地夜间跑;需要强推理的难题则把脱敏后的单个子任务转发给云端 API。这样既保留了本地推理的隐私与无额度限制,又只在真正需要时消耗云端 token,成本可控。原文建议的“先观察一周用量再决定套餐”正是这一思路的简化版——先量化自己的真实需求,再决定哪部分交给本地、哪部分留给云端。
该买哪台?什么时候划算?
基础版M6 Mac mini售价约900美元,内存仍是16GB,只能跑实测过的同尺寸模型。真正改变局面的是32GB版本,约1300美元,多出的400美元相当于两个月200美元套餐的费用,但能让更大更聪明的模型装得下。M5 Pro配64GB起价约2700美元,内存带宽翻倍、运行更快,适合把本地AI当爱好的人。32GB是底线。
UP主最后给了一个零成本的省钱建议:买之前先花一周观察自己的实际使用情况,如果没碰到额度上限,就降级到20或100美元的套餐,用到的还是同样的模型,口袋里却能多留钱。Mac mini的定位不是替身,而是本地常驻智能体的宿主——它处理私密与计划任务,难题外包给云端,这才是当下最务实的混合架构。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。