Claude模型与Effort终极指南:如何省Token

同一模型不同Effort档位可致成本时间差数十倍,但清晰任务正确率几乎不变。
本文基于对8种模型与Effort组合、4个真实编码任务的系统实测,结合Anthropic官方基准数据,揭示Claude模型在不同Effort档位下的表现差异。核心发现是:Effort档位决定单次请求的Token预算,是信号而非硬限制;同一模型在low与max档位下耗时和成本可差数十倍,但正确率在清晰任务上几乎相同。32次运行中31次通过全部隐藏测试,唯一失误来自Haiku。成本方面,Opus配medium性价比最高,Fable每解决任务成本约为其5倍。文章建议日常使用medium,失败再升档,Fable与max只留给真正困难的难题,Haiku用于批量简单工作。
为什么同一个模型,快慢能差几十倍?
一位开发者用Opus在Max Effort档位修复一个bug,花了8分钟,消耗了每周限额的15倍;而改用Low档位后,同一个模型只用17秒就完成了修复,且两次修复都通过了所有隐藏测试。这说明:模型没变,变的是「Effort」——它决定了Claude在一次请求中允许花多少Token去思考、调用工具和自我检查。
本文基于一位YouTube创作者对8种模型与Effort组合、4个真实编码任务的系统实测,结合Anthropic官方基准数据,拆解每个Claude模型适合什么场景、Effort到底改变了什么,以及日常开发中怎样配置最省Token。
四个模型:从Haiku到Fable的定位与价格
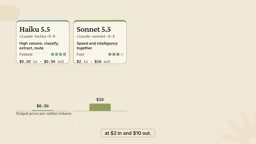
目前Claude提供四款模型,定位和定价差异明显:
- Haiku 5.5:速度最快、价格最低,输入每百万Token 10美分、输出50美分。适合分类、路由等高并发简单任务。
- Sonnet 5.5:速度快且能力依然强劲,输入$2、输出$10。
- Opus 5.5:Claude Code的默认模型,也是Anthropic官方建议的起点,输入$4、输出$20。
- Fable 5.1:面向最难的推理和长程Agent任务,输入$10、输出$50——输出成本是Haiku的100倍。
四款模型都支持100万Token上下文,真正的差异在于能力上限、响应速度和成本。
上下文窗口指模型单次能处理的最大Token数量(包括输入和输出)。本文提到四款模型都支持100万Token上下文,意味着它们可以一次性读入极长的代码库、文档或对话历史,而不需要分段截断。然而,上下文窗口大小并不直接决定推理能力或成本效率;真正影响实际表现的是模型参数规模、训练数据以及推理时的计算预算(如Effort档位)。因此,在长上下文场景中,仍需结合任务复杂度和成本来选择模型与档位,而非仅看上下文长度。
Effort档位:它不只是「思考时间」
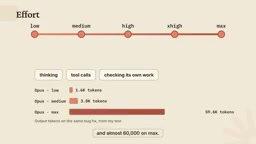
在模型之上,你还要选择Effort档位:low、medium、high、x-high、max。Effort本质上是Claude一次请求允许消耗的Token预算——包括思考过程、工具调用,以及自我验证的深度。
同一个bug案例中,Opus在low档位写了约1,500个Token,medium约4,000个,max接近60,000个。但要注意,这是一个信号而非硬性上限:即使选low,遇到真正困难的问题它依然会思考,只是思考得更少。
在Claude Code中,Haiku、Sonnet、Opus默认从medium起步,Fable默认从high起步。修改方式有三种:输入/effort调出滑块,或用/model配合左右方向键;也可以在启动会话时加claude --effort参数;还能在设置中为每个模型保存默认档位。需要注意,max档位仅在当前会话内有效。如果只想让某一个问题深入思考,在提示词里输入UltraThink,那一轮就会以x-high档位运行。
Token是大型语言模型处理文本的基本单位,可以粗略理解为单词或词片段。模型在生成回复时,输入(提示词、上下文)和输出(思考过程、工具调用、最终答案)都以Token计量,API按Token数量收费。Effort档位本质上是在单次请求中为模型设定一个Token预算,决定它最多能「花」多少Token用于内部推理、调用外部工具以及自我检查。预算越高,模型能进行的多步推理和验证就越多,但成本和延迟也随之上升。由于Token预算是软性信号而非硬性截断,模型在遇到真正困难的问题时,即使档位较低也可能超出预期地思考,只是整体倾向更节省。
实测:32次运行,31次全对
创作者设计了4个真实编码任务——带bug的版本范围解析器、损坏的缓存、需要重构的长语音函数、按规格编写cron调度器——让8种模型与Effort组合逐一执行,并用模型从未见过的隐藏测试验证结果。
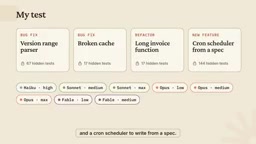
结果出人意料:32次运行中有31次通过了全部隐藏测试,唯一的失误是Haiku把一个函数写得太长。换句话说,在这类边界清晰的日常编码任务上,模型和档位的选择几乎不影响正确率——真正的差异体现在成本和时间上。
成本差距相当悬殊。在每月20美元的专业版计划下:
- Sonnet配medium,每周约可运行4,000次这类任务;
- Opus配low,约2,000次;
- Opus配max,只剩约160次,耗时超过20倍,却没有多通过任何一个测试;
- Fable虽然全部通过,但每个Token成本是Opus的2.5倍,每周只能跑约600次。
Anthropic自己的基准数据也印证了这一点。在SWE BenchPro测试中,Opus配medium解决了92.8%的任务,Fable配high解决92.3%,但Fable每解决一个任务的成本约为前者的5倍。
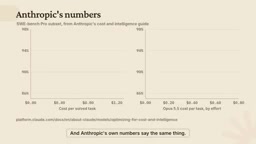
SWE BenchPro是评估AI模型解决真实软件工程问题能力的基准测试,任务通常来自开源项目的GitHub issue,要求模型生成补丁并通过隐藏测试。该基准不仅衡量正确率,还关注每个任务的解决成本,因为不同模型在推理时消耗的Token量差异巨大。本文引用SWE BenchPro数据说明,Opus配medium在正确率与成本之间取得了最佳平衡,而Fable虽然正确率接近,但单任务成本高出数倍,这为日常配置提供了客观依据。
高Effort什么时候真的有用?
在长程、困难的任务上,提高Effort确实有效:Opus从low档位的87%提升到x-high档位的97%。但代价是每个任务的成本上涨近7倍。这揭示了一个关键取舍——Effort的边际收益只在任务难度足够高时才显现,对清晰明确的日常任务则近乎为零。
实战配置建议
综合实测数据,可以给出如下配置策略:
- 日常编码、任务清晰:用Opus或Sonnet配medium,这本来就是默认设置。
- 快速任务、你会逐条检查结果:降到low。
- 反复出现的bug、边缘情况重要的场景:升到high,或对单个提示词使用UltraThink。
- 子Agent和大批量简单工作:用Haiku。
- Fable和max档位:只留给medium确实失败的问题,不要当作默认配置。
核心结论可以浓缩成一句话:先让medium跑,失败了再升档,而不是一上来就拉满。 官方基准和独立实测在这一点上高度一致,这也是本文最值得记住的多源交叉验证结论。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Caro揭秘:LBJ如何用伪装骗过种族隔离派
罗伯特·卡罗在LBJ传记中记录前参议员塔尔梅奇的采访:约翰逊初入参议院时刻意迎合南方保守派,塔尔梅奇称未察觉其民权倾向。掌权后约翰逊推动1964年民权法案与1965年投票权法案,揭示政治伪装与改革时机的关系。