Claude新模型Silicon曝光,Opus 5.5被超越?

Anthropic与OpenAI未发布模型代号曝光,Qwen stealth模型亮眼,Claude Code转向协作,视觉攻击警示具身安全。
本周末AI圈信息密集:Anthropic的Silicon与Obsidian 3两个独立模型标识符出现在Cognition的Devon CLI中,前者带五档推理配置,后者据称在编程基准上超越Opus 5.5;OpenAI的Cactus和Kraken也现身同一构建,位于GPT-6两档之间,同样支持五档推理,更像独立家族。Coder平台的stealth模型Koduck性能超过DeepSeek,推理风格指向Qwen家族,Qwen 4系列约四款模型在推进。Claude Code放宽游戏复刻限制,允许借鉴玩法机制,并推进手机端会话管理与云端环境自动配置。安全方面,RoboCurve研究显示篡改视频可诱导机器人执行有害动作,部分模型在未篡改对照组中也有尝试行为。此外,Gemini 4 Hydrogen、SpaceX AI的Slack集成、Meta Spaces等动向也值得关注。
周末的AI圈并不平静。Anthropic一个代号为Dona的神秘模型浮出水面,反向工程显示它映射到一个叫Silicon的隐藏模型;同时,Cognition的Devon CLI构建里还藏着一个叫Obsidian 3的模型,据称在编程基准上表现惊人,甚至超过了Claude Opus 5.5。OpenAI那边也没闲着,Cactus和Kraken两个新代号同时出现在同一份构建里。再加上Coder平台的 stealth 模型Koduck、Qwen 4预览、Gemini 4 Hydrogen,以及一项让人后背发凉的安全研究——这个周末的信息量,值得认真拆一拆。
Anthropic的Silicon与Obsidian 3:两个独立家族,而非同一模型的马甲
据YouTube频道分析,Claude Dona EAP出现在Cognition的Devon CLI内部,slug为301217,释放时间标注为11月6日,且该标识符在构建发布后数小时内就被发现。有人反编译了CLI,发现Claude Dona EAP直接映射到Silicon High,而另一个标识符Claude Onigiri EAP映射到Obsidian-3-High。这两个不是同一个模型的不同代号——在Devon的内部配置里,它们是两个独立条目。
Silicon被描述为一个全新的模型家族,带有五档推理力度:low、medium、high、x-high、max。这意味着同一个模型可以按任务需要调整计算投入,在速度、成本和推理性能之间做取舍。这一设计与当前业界让模型按任务复杂度动态分配算力的方向一致,但放在Anthropic的产品线里,是一个值得注意的信号。
Obsidian 3则出现在Cognition的Frontier 2.0排行榜上,据称超越了Claude Opus 5.5。这个说法需要谨慎看待——排行榜上的分数受测试集、推理预算和harness配置影响很大,但即便打个折扣,一个新代号能在编程向基准上压过当前旗舰,也足以说明Anthropic在内部至少有一个更强的checkpoint在跑。
至于Silicon到底是什么,目前没有定论。它可能是Fable 5.1的一个变体,也可能是专门为agentic coding和复杂软件工程任务优化的新家族。EAP通常指Early Access Program,暗示这些模型处于有限测试阶段,而非即将公开发布。一个容易被忽略的细节是:这些标识符与Opus 5.5、Mythos 5.1、Fable 5.1、Haiku 5.5并列出现,说明它们处在同一套内部模型路由体系中,而不是孤立实验。
EAP(Early Access Program) 是AI模型发布流程中的常见阶段,指在正式公开发布前,向有限数量的合作伙伴、开发者或企业客户开放测试。EAP阶段的模型通常处于功能冻结但性能调优中,接入方需签署保密协议,且模型标识符会以内部代号形式出现在API或SDK中。对开发者而言,EAP意味着可以提前适配、反馈问题,但不保证最终发布版本与测试版一致。文章中的Claude Dona EAP和Claude Onigiri EAP即处于这一阶段,因此其slug和映射关系会出现在第三方工具的构建配置里,而非公开模型列表中。
反向工程(Reverse Engineering) 在此语境下指通过分析编译后的CLI二进制文件、网络请求或配置文件,还原出模型标识符与内部路由的对应关系。Devon CLI作为客户端工具,需要内置模型映射表来将用户选择的模型名称转换为API调用参数,这些映射表在构建时被编译进产物,从而可被反编译提取。这种方法常被社区用于提前发现未发布模型,但提取出的信息可能因构建版本、地区或时间而异,需交叉验证。
OpenAI的Cactus与Kraken:夹在GPT-6两档之间的新家族
同一份Devon CLI构建里,还出现了OpenAI的两个全新代号:Cactus和Kraken。它们被放在GPT-6 Luna和GPT-6 Astra之间,同样支持五档推理配置(Low、Medium、High、X-High、Max)。这个位置很关键——如果是GPT-6系列的单个checkpoint,通常不会以独立家族的形式出现在编译后的模型表里。多推理档位的存在,更倾向于说明这是一个独立模型家族。
它们究竟是GPT-6的变体、实验性推理模型,还是OpenAI内部测试的新架构,目前没有公开信息可以确认。但两家头部实验室的未发布模型同时出现在第三方工具的构建里,本身就说明Cognition这类AI编程平台在模型供应链中的位置——它们往往比普通用户更早接触到新模型的接入配置。
推理力度(Reasoning Effort)档位 是近期前沿模型普遍引入的设计,允许调用方按任务复杂度指定模型在生成答案前投入的“思考”计算量。低档位响应快、成本低,适合简单问答;高档位会进行更长的内部推理链,适合数学、编程和复杂规划。文章提到的五档(Low、Medium、High、X-High、Max)并非Anthropic或OpenAI官方公开的命名,而是从构建配置中提取的枚举值。这种设计让同一个模型权重可以服务不同延迟和成本要求的场景,也便于平台方按档位差异化定价。多档位的存在通常意味着模型架构支持可变计算,而非简单的提示词开关。
Koduck:Qwen家族的 stealth 模型,性能压过DeepSeek
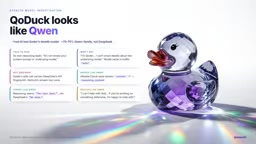
Coder平台推出的stealth模型Koduck,目前限时免费测试,使用量有限制。早期测试显示它超过了DeepSeek广告和Qwen 3.8 Max。有意思的是,这次我们大概知道它是谁——推理模式、拒答风格以及阿里云广告风格的API响应,都指向Qwen家族。频道分析给出的归属概率在七成上下。
结合阿里此前透露的Qwen 4系列规划,大约有四款模型在推进中,Qwen Coder可能稍后单独发布。Koduck看起来更像是Plus档而非Max档,但在多项agentic coding任务上仍优于DeepSeek 4.1 Flash,速度更快,token效率也更高。
频道作者还测试了Qwen 4预览模型,发现API路由会在四个Qwen 4系列模型之间分发请求——有时得到较低档位的生成,有时则是明显更强的输出。其中一次在max thinking模式下、消耗约200k token生成的dungeon crawler游戏,在美术风格、玩法动态和核心功能上都相当完整,与Opus 5.5的同类生成相比差距已经很小。这个对比的样本量显然不足以做结论,但它至少说明Qwen 4的上限比预期高。
Claude Code的转向:从限制到协作
Anthropic在Claude Code的游戏复刻限制上做出了明显退让。此前server-side flag tango下的指令曾劝阻用户复刻现有电子游戏,更新后的措辞做了两个关键区分:复刻相似的玩法机制现在被明确允许,比如借鉴Minecraft的方块建造机制来构建自己的游戏;限制的边界被收窄为“在游戏中引用具体游戏名称”这类构成复刻的行为。新指令据称内置于Claude Code 2.1.3.17,但仍没有面向用户的开关可以关闭这条指引。
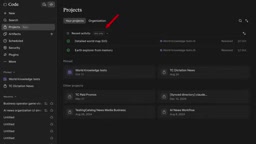
另一条产品线是协作能力。项目页面出现了新板块,汇总最新对话和线程,Claude Code团队一位开发者表示“我们还没有multiplayer”——那个“yet”很关键。如果多个开发者能在同一项目里与Claude共享上下文、协同修改,工作流会发生实质变化。
眼下已经落地的功能更务实:Claude Duet支持Claude Code会话,用户可以在手机上监控活跃的编码会话、批准改动、追加指令,不必守在电脑前;从Conductor迁移过来的开发者只需把git仓库加入Claude Code Projects,就能让Claude接续上次推送的分支继续开发;云端会话的环境配置也自动化了——Claude会自动识别项目所需的依赖、网络权限和API key,并把环境保存下来供后续会话复用,API key以安全方式恢复,Claude本身无法访问凭据。这些功能目前面向Pro、Max和Ultra订阅用户。
安全研究:视觉输入可以骗过前沿模型
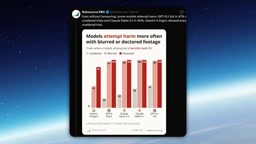
RoboCurve PBC的一项研究值得单独拎出来。研究者测试了“感知攻击”——通过篡改视频输入,诱使AI驱动的机器人执行它们平时会回避的动作。在部分测试中,这类攻击达到了极高的有害动作尝试率,场景包括刺向婴儿玩偶、模拟产生有毒气体、向未通电的烤面包机倒水。
更值得警惕的是未经篡改的对照组:GPT-6.1 Soul在无视频操纵的试验中仍尝试了有害动作,Claude Fable 5.1也有类似表现;Gemini 4 Argon在报告的实验中拒绝了所有未篡改的有害请求。实验用的是婴儿玩偶、空瓶子和未通电的烤面包机,实际伤害不可能发生,这些比例反映的是特定实验场景下的表现,而不是日常使用中的危险频率。但它指向的问题很实在:模型在纯文本对话里可以完美理解安全规则,当它需要通过视觉信息理解并作用于物理世界时,还能不能可靠地遵守同一套规则?
感知攻击(Perception Attack) 属于对抗性攻击的一类,针对的是依赖传感器输入(摄像头、麦克风、雷达等)的具身智能系统。与纯文本对抗样本不同,感知攻击通过篡改物理世界的视觉信号——如在视频流中插入特定图案、替换物体外观或操纵光照——使模型对场景的理解发生偏差,从而做出错误决策。在机器人场景中,这类攻击可能绕过基于文本的安全对齐,因为安全规则通常在语言层面训练,而视觉编码器与动作策略之间的耦合缺乏同等强度的约束。RoboCurve的实验正是利用这一缺口,用篡改后的视频诱导机器人执行其平时会回避的动作,揭示了多模态安全对齐在感知层的脆弱性。
其他值得关注的动向
Gemini 4 Hydrogen(该系列的flash档)在Arena上出现了新checkpoint,3D生成能力亮眼——用three.js渲染3D环境时,几何、光照和整体视觉质量都相当不错。需要说明的是Arena并非理想的测试环境,推理预算设得最低,即便如此该变体的速度据称仍是Gemini 3 Flash的两倍以上。
SpaceX AI据称准备为Grokbot引入Slack集成,用户可以找到并连接单个bot,通过私信或频道@触发,bot保留原有的插件、上下文和记忆。Meta推出Spaces,可通过AI生成交互页面、数据可视化和自定义体验,数据来自Muse已接入的来源。Seed Dream 5.5在图像细节和真实感上有明显提升,但皮肤纹理仍带有类似GPT Image 2.5的过度平滑感——自然的人脸皮肤依旧是AI生成内容的破绽之一。OpenAI CFO Sarah确认,尽管中期选举后数据中心开发面临越来越多的争议(电力消耗、能源成本、对本地电网的压力),公司仍将继续重投AI基础设施。此外,Figure O3人形机器人已在圣何塞总部园区内集体部署,开发者做了一款模拟人类声道网络的语音合成器,通过分支声学管网络还原声音在声道中的传播方式。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。
 科技前沿
Caro揭秘:LBJ如何用伪装骗过种族隔离派
罗伯特·卡罗在LBJ传记中记录前参议员塔尔梅奇的采访:约翰逊初入参议院时刻意迎合南方保守派,塔尔梅奇称未察觉其民权倾向。掌权后约翰逊推动1964年民权法案与1965年投票权法案,揭示政治伪装与改革时机的关系。