阿里开源QwenGyre:长任务训练不掉线,智能体边做边学
阿里开源QwenGyre破解长任务训练GPU空转,消费级硬件跑千亿模型与多家大模型提速成焦点。
本期AI动态聚焦智能体训练效率与模型部署门槛两大主线。阿里开源QwenGyre框架,通过GPU异步调度让已完成任务的单元先行训练、未完成任务带状态缓存迁移,减少GPU空转,提升长任务训练效率。社区项目Stratum将1250亿参数的Qwen 3.8 Flash Next部署到12G显存游戏电脑上,RTX 5070实测每秒94个Token,显示消费级硬件跑大模型正从可用走向好用。智谱GLM 5.3 High Speed灰度测试中每秒接近500个Token,首字延迟不到5秒;阶跃星辰Step 5 Preview上线WorkBuddy限时免费,6000亿参数激活270亿,支持100万上下文。此外,DeepSeek计划投资前腾讯科学家胡汉创办的Winverse AI,估值约4亿美元,布局机器人感知与决策。
AI智能体在长时间任务训练中频繁掉线、GPU空转等待,一直是困扰开发者的核心痛点。阿里最新开源的 QwenGyre(原文中提及的「Q1 JIR」)试图改变这一局面。据B站「Will叔每日AI动态」报道,这个框架让智能体在执行长任务的同时完成训练,GPU利用率有望大幅提升。
长任务训练的困局与QwenGyre的解法
传统Agent训练流程中,一个任务往往需要跑几个小时、数百轮交互,涉及百万级Token的处理。GPU在这个过程中面临严重的等待问题——部分计算单元早已完成自己的任务,却要等其他单元全部结束才能进入下一轮训练。
QwenGyre的核心思路是将GPU拆分为独立计算单元,谁先完成手头的任务谁就先开始训练,尚未完成的任务连同其状态和缓存一起「搬走」,等后续单元执行完毕再无缝接续。换句话说,就像项目组里有人先交卷了,就让他先复盘,其他人接着答题。这种异步调度机制减少了GPU的闲置时间,让训练和推理真正并行起来。
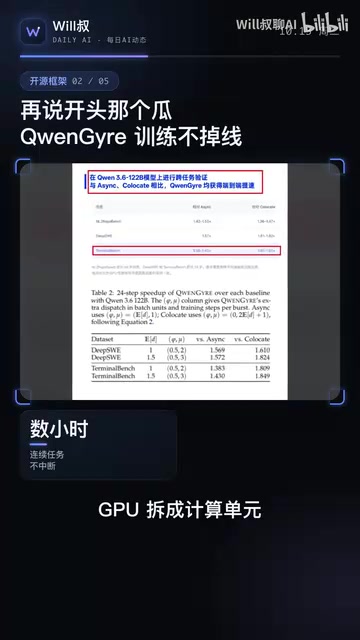
要理解GPU空转等待的问题,需要回到大模型训练的基本原理。模型训练通常以「批次」为单位推进:一个批次内的所有计算单元(如张量核心、SM流多处理器)必须全部完成前向计算和反向传播,同步更新参数后,才能进入下一个批次。在智能体长任务场景中,不同任务的计算量差异极大——有的交互只需几十个Token,有的却涉及百万级Token的推理链。这导致同一批次内快单元必须等待慢单元,GPU利用率因此大幅下滑。业界常见的缓解手段包括梯度累积、动态批处理和流水线并行,但这些方案要么牺牲时效性,要么对任务同质性要求较高。QwenGyre的异步调度思路更接近「流水线并行」与「弹性调度」的融合:通过状态与缓存迁移,让已完成的单元提前进入训练阶段,本质上是把批次同步的刚性约束转变为任务级弹性接续,这与传统数据并行训练有显著区别。
消费级硬件的新可能:1250亿参数塞进12G显存
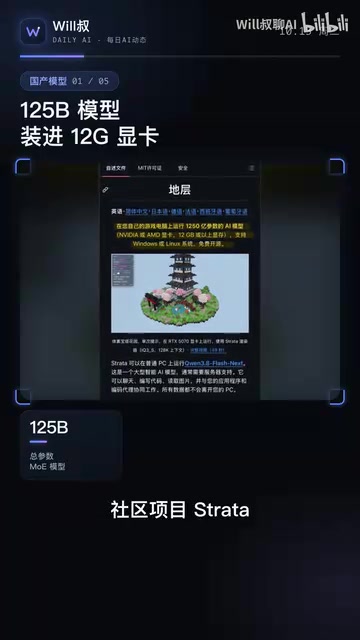
另一条值得关注的动态来自社区项目 Stratum。它将 Qwen 3.8 Flash Next 这个1250亿参数模型部署到了仅有12G显存的游戏电脑上,搭配RTX 5070实测达到每秒94个Token的输出速度。这个数字虽然无法与数据中心级方案相比,但考虑到硬件成本差距,已经足够说明消费级GPU跑大模型正在从「能不能」转向「好不好用」的阶段。
对个人开发者和中小团队来说,这意味着本地运行百亿参数级别模型的门槛在持续降低。
1250亿参数模型能跑在12G显存上,核心依赖的是模型量化与混合专家(MoE)架构。以Qwen 3.8 Flash Next为例,它很可能采用MoE结构——每次推理只激活部分专家参数,而非全部1250亿参数同时参与计算。在此基础上,社区项目通常还会采用4bit甚至更低的量化方案(如GPTQ、AWQ),将每个参数的存储压缩到原来的四分之一甚至更低。12G显存实际加载的是量化后的权重和部分激活缓存,其余参数或专家则按需从系统内存甚至SSD中动态加载。这种「显存不够、内存来凑」的策略牺牲了一定速度,但让消费级显卡跑起千亿模型成为可能。需要提醒的是,每秒94个Token的输出速度是在特定量化精度和上下文长度下测得的,实际体验会随提示词长度、并发数等因素波动。这一进展的意义在于,模型部署正从「硬件适配模型」转向「模型适配硬件」。
GLM 5.3 High Speed与Step 5 Preview:速度竞赛加速
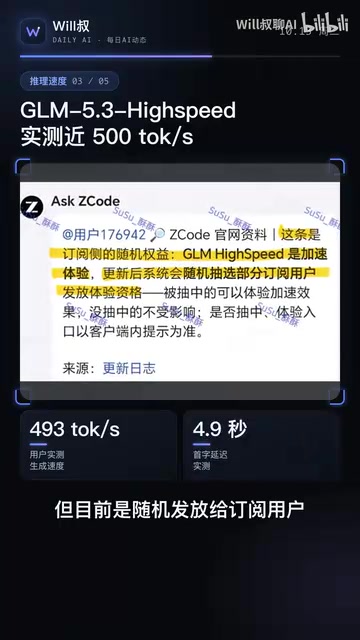
智谱的GLM 5.3 High Speed版本已启动灰度测试,用户实测每秒接近500个Token,首字延迟不到5秒。不过目前采用随机发放机制,订阅用户能否体验到存在运气成分。效率虽然惊人,但尚未全面开放。
另一家值得关注的是阶跃星辰的Step 5 Preview,已上线WorkBuddy广告平台并限时免费。6000亿参数规模、激活270亿、支持100万上下文——这组数字在当前开源模型中属于第一梯队。100万上下文的实际可用性,将是检验其工程能力的关键指标。
「首字延迟」和「每秒Token数」是衡量大模型推理体验的两个关键指标,但两者反映的能力维度不同。首字延迟(Time to First Token, TTFT)指用户发出请求到模型吐出第一个Token的时间,主要受预填充阶段影响——也就是模型处理输入提示词的耗时;上下文越长,预填充越慢,首字延迟越高。每秒Token数(Tokens per Second, TPS)则反映解码阶段的吞吐速度,即模型逐字生成答案的效率,主要受显存带宽和模型规模制约。对交互式应用来说,TTFT决定了「等待感」,TPS决定了「阅读流畅度」。GLM 5.3 High Speed声称TTFT不到5秒、TPS接近500,意味着它可能在预填充优化(如分块注意力、KV缓存复用)和解码加速(如投机采样、并行解码)上都有针对性设计。不过,这类高速版本通常以略降生成质量或限制上下文长度为代价,是否适合生产环境仍需实测验证。
DeepSeek的机器人布局
据彭博社报道,DeepSeek广告计划投资由前腾讯科学家胡汉创办的Winverse AI,投后估值约4亿美元。这家公司专攻机器人的感知、理解与决策,定位为「机器人体内的大脑」。
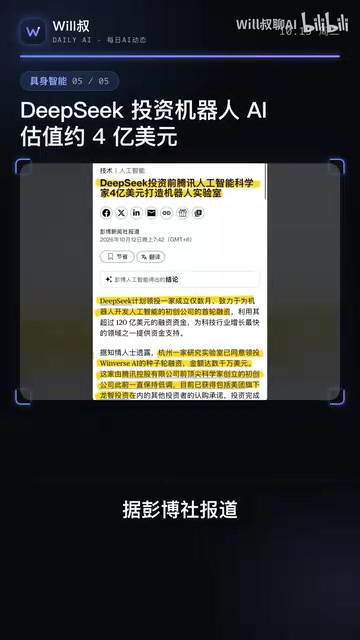
从大模型到具身智能,DeepSeek的这一步棋并不意外。算法层面的能力积累向物理世界延伸,是当前AI行业最值得关注的趋势之一。Winverse AI能否借助DeepSeek的资源和模型能力在机器人决策领域快速建立壁垒,值得持续观察。
具身智能(Embodied AI)是当前AI行业从数字世界迈向物理世界的核心方向,其目标是让机器人具备感知环境、理解任务并做出决策的能力。与纯语言模型不同,具身智能系统需要融合视觉、触觉、运动控制等多模态信息,并在真实物理约束下完成动作规划。行业通常将这类系统分为「大脑」和「小脑」两层:大脑负责高层语义理解和任务分解,小脑负责底层运动控制和实时响应。Winverse AI定位为「机器人体内的大脑」,意味着它专注于感知、理解与决策层,而非直接参与电机控制。这一领域的竞争壁垒在于真实场景数据的积累、仿真到现实的迁移能力(Sim-to-Real),以及与硬件厂商的生态绑定。DeepSeek此次投资,既可看作其多模态和推理能力向物理世界延伸的尝试,也反映出大模型公司正通过资本布局抢占具身智能入口。
相关推荐
Cursor vs Copilot vs Windsurf:2026年AI编程助手谁更强?
通过同一全栈应用的实测对比,GitHub Copilot、Cursor和Windsurf在代码质量、上下文理解和错误处理上表现迥异。Copilot产生最多技术债务,Windsurf的智能体流程可实时自我调试。了解三款AI编程助手在2026年的真实能力边界。
Elementor MCP 连接 Claude、Codex 与 Cursor 实操解析
Elementor MCP 功能实操解析:如何在 Elementor 中启用 MCP 连接 Claude、Codex、Cursor 等 AI 编程助手,自动建立连接并提升 WordPress 页面搭建效率。
REA究竟是工具还是工作流?YouTube热传"杀死软件"真相
REA(Reverse Engineer Anything)被YouTube热传为"杀死软件"的工具,拥有88,000+ GitHub stars。但真相是:它不打包Ghidra或IDA,而是把机器上已有的逆向工具接入Cloud Code等agent。本文拆解REA的工作流、Ghidra 2019年开源的事实、agent证据循环机制,以及复刻成本下降后软件护城河向何处迁移。