#大模型部署
共 16 篇相关文章

Mistral Large 4开源权重发布:1T参数模型家用硬件能跑吗
Mistral Large 4正式发布开源权重,1万亿参数MoE架构、百万上下文,但最低需要256GB内存才能运行1-bit量化。本文详解模型规格、许可证限制、厂商基准数据、显存阶梯与四条运行路径,帮你判断家用硬件是否可行。

Cerebras突破万亿参数大模型部署壁垒
Cerebras宣布成功部署万亿参数AI模型,其晶圆级芯片架构为超大模型推理提供了一条不同于GPU集群的路径。本文解析该进展的技术逻辑、部署与训练的差异,以及对AI基础设施格局的潜在影响。

Ollama与VLLM部署实战:Qwen3-0.6B本地化部署指南
从Demo到生产,大模型本地部署需要解决显存、并发与服务暴露问题。本文梳理部署四大目标,对比Ollama与VLLM的定位差异,并给出使用VLLM部署Qwen3-0.6B模型的实战路径。

20分钟基于vLLM本地部署DeepSeek-R1实战教程
手把手教程:基于vLLM在Ubuntu服务器本地部署DeepSeek-R1蒸馏模型,涵盖Miniconda环境搭建、NVIDIA驱动安装、CUDA 12.4配置、PyTorch与vLLM安装全流程,附环境版本对照和避坑要点。

70B大模型需要多少显存?推理与微调全解析
详细计算70B大模型推理与微调的显存需求:16-bit推理141GB、4-bit仅40GB,QLoRA微调50GB、全量微调1.1TB。含KV缓存公式、GPU配置推荐与自测脚本。

Ray LLM容器:EKS跨GPU节点部署大模型实战
介绍如何在 Amazon EKS 上使用 Ray LLM Deep Learning Containers 跨两个 GPU 节点部署大语言模型,通过 prefill 与 decode 节点分离架构,对外提供单一 OpenAI 兼容端点,降低多节点推理部署复杂度。

Ollama+DeepSeek+Dify本地部署搭建AI智能体全流程
手把手教程:在Windows环境下用Ollama部署DeepSeek大模型,结合开源平台Dify本地搭建企业级AI智能体与知识库,从Docker安装、模型连接到旅行助手Agent编排的完整流程与避坑指南。

本地大模型答非所问?先定位再改动的排查法
本地大模型总是答非所问、角色混乱或重复输出?本文给出一套系统排查法:先查任务和输入,再查聊天模板,最后调采样参数,一次只改一项,并用对照实验验证效果。

大模型本地部署实战:Ollama、vLLM与量化方案全解析
大模型本地部署完整指南:对比 Ollama、vLLM、LM Studio 三大工具的适用场景,以通义千问 Qwen3.8 的 27B 模型为例详解 BF16、FP8、INT4 等量化方案的显存需求与显卡选型建议。

Shopify如何用PyTorch与vLLM打造持续学习闭环,成本降96%
Shopify基于PyTorch和vLLM构建持续学习闭环,每日将生产失败压缩进模型权重,质量超越前沿模型并将服务成本削减96%。解析其训练与推理技术栈的分工与企业落地启示。
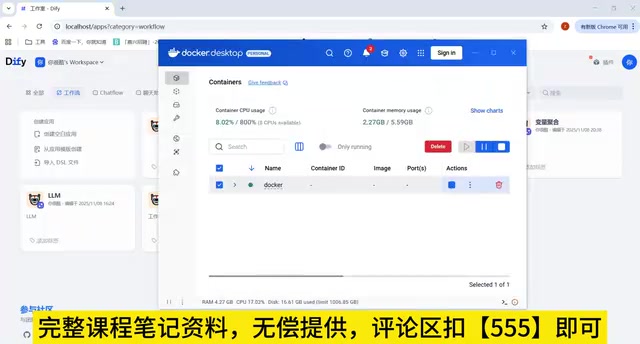
Dify本地部署实战:Docker+Ollama+RAG全流程搭建指南
Dify 本地部署实战教程解析:从 Docker 环境搭建、Ollama 本地大模型部署,到工作流设计、变量管理与 RAG 知识库应用,全流程覆盖,帮助开发者搭建私有化 AI 应用。
 行业洞察
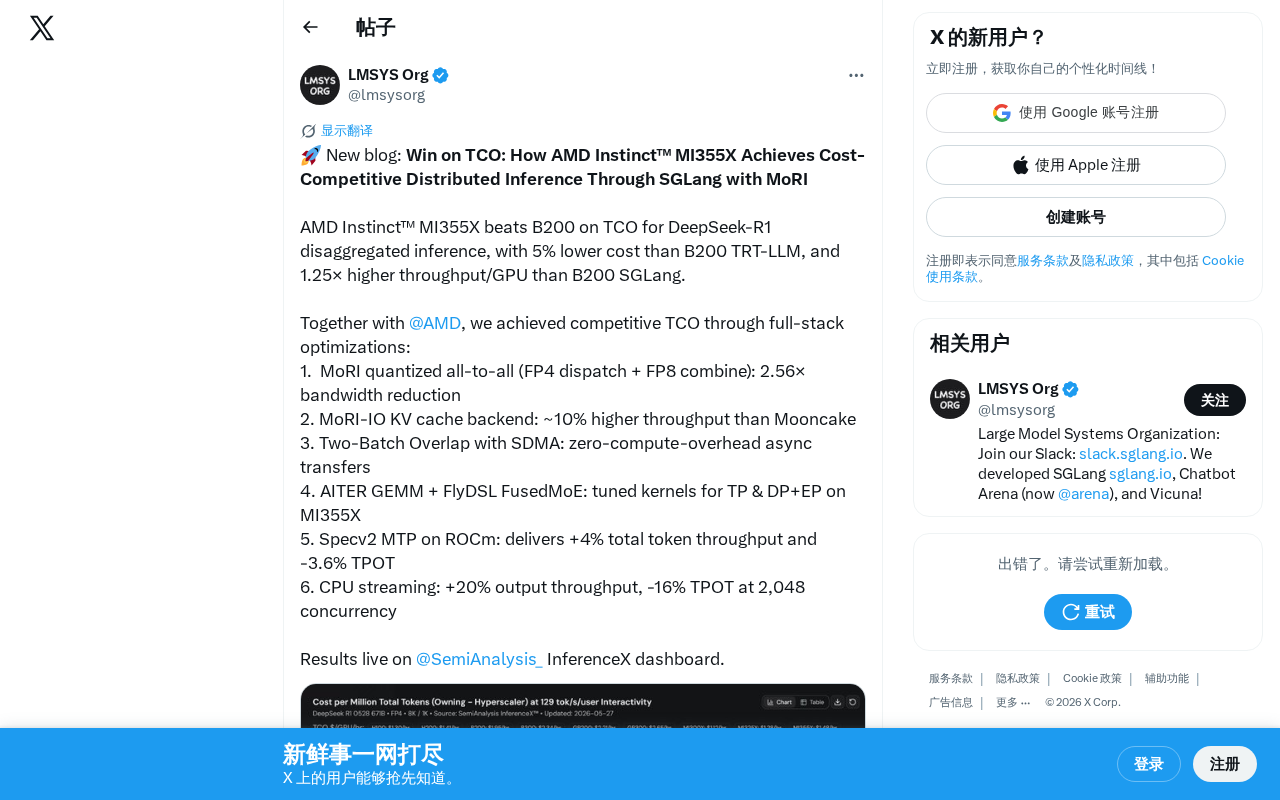
AMD MI355X击败B200:DeepSeek-R1推理TCO低5%的全栈优化解析
AMD Instinct MI355X通过SGLang+MoRI全栈优化,在DeepSeek-R1分离式推理中实现TCO比NVIDIA B200低5%,每GPU吞吐量高1.25倍。深度解析MoRI量化通信、KV Cache优化及推测解码等核心技术突破。
 教程攻略
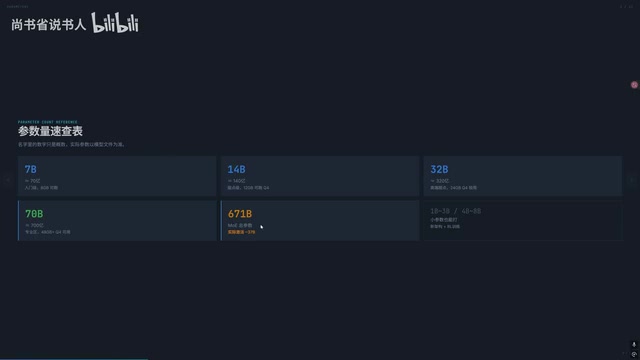
大模型命名规则解析:参数量、量化格式与显存需求速查
系统拆解大模型命名规则,解释32B参数量、AWQ/GGUF量化格式的含义,提供4-bit量化显存估算公式与速查表,涵盖MOE模型显存陷阱、IMatrix量化推荐及按显存档位的模型选择建议。
 产品体验
AI编程一体机vs在线大模型:48万年费能换4套本地方案?
深度对比AI编程一体机与在线大模型API的成本差异。以20人开发团队为例,年均Token费用高达48万元,而OnePanel AI编程一体机仅需9.9万元,两个半月即可回本。从成本、安全、延迟、合规四大维度分析本地化AI编程部署方案的实际价值。
 产品体验
三个AI Agent实测对比:电商直播数据分析谁更强?
实测三个AI Agent处理电商直播数据分析的真实表现:本地部署内存不足、海外API成本高昂、云端多模型方案如何破局?从弹幕情绪分析到高转化话术提炼,看AI Agent在直播运营中的落地效果与选型建议。
 教程攻略
多Agent协同医疗问诊系统:RAG+本地部署实战指南
详解多Agent协同医疗问诊系统的开发全流程,涵盖RAG知识库检索、多智能体协同架构设计、本地大模型部署与医疗知识库构建,附完整落地步骤与技术要点分析。