本地大模型答非所问?先定位再改动的排查法

本文给出一套本地大模型答非所问的系统排查流程:先查任务与输入,再查聊天模板,最后才用对照实验调采样参数。
本地部署大模型后,答非所问、角色混乱、无限重复等问题的根源往往不在采样参数,而在提示词、输入资料或聊天模板。文章提出一套由浅入深的五步排查法:第一步明确症状分类;第二步把提示词写到可验收——清楚说明任务、资料依据、输出格式和缺信息处理方式;第三步确认资料确实交给了模型而非只在本机;第四步核对聊天模板与模型官方格式是否匹配,避免手工叠加标记造成角色混乱;第五步在前四步排除后,才对温度、Top P、重复惩罚做固定种子的对照实验。文章同时澄清了几个常见误区:温度只影响概率分布形状而不判断事实对错,Top P 无法防止模型胡编,严谨任务也未必要将温度设为 0。核心原则是先保证任务和资料清楚,再确认模板,最后一次只改一个参数并记录结果。
本地部署大模型后,很多人会遇到一个尴尬的情况:模型能回答,却总是答不到点子上。有时漏掉要求,有时冒出奇怪的角色标记,有时陷入无休止的重复。面对这些问题,不少人第一反应就是去拉满采样参数,结果越调越乱。
正确的思路恰恰相反——先定位,再改动,一次只改一项。这篇文章梳理一套系统的排查流程:先查任务和输入,再查聊天模板,最后才动采样参数。
第一步:说清楚"不对"到底是什么
排查的前提是定义问题。模型表现不佳,具体可以分成几类:没按要求回答、角色混乱、不断重复、输出被截断。不同症状对应不同的排查方向,不能凭单一现象就断定唯一原因。
- 要求没完成 → 先看任务描述和提供的资料
- 冒出角色标记 → 检查聊天模板和模型版本
- 出现重复 → 先排除输入问题,再考虑参数
这是一个由浅入深的漏斗。把症状分清楚,才能避免南辕北辙地瞎调。
第二步:把提示词写到能"验收"
很多答非所问的根源其实在提示词本身。一个容易检查的提示词,应该写清四件事:任务是什么、依据哪段资料、输出什么格式、缺信息时怎么处理。
只说"你是专家",模型并不会自动补上这些条件。真正有效的做法是把要求写得能够验收。
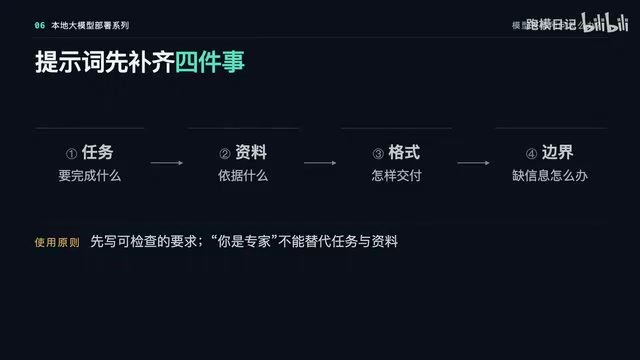
举个例子:一段虚构产品资料里写了重量,却没有写售价。如果只问"介绍一下",回答范围就会很宽,你根本无法判断模型有没有完成任务。改成"只提取重量和售价,固定输出两行,缺失就写未提供",要求立刻清晰起来。
不过要注意:提示词写清楚只是让要求可验证,模型究竟能不能遵守,还得对照原文实际核对。
第三步:确认资料真的交给了模型
这是最容易被忽略的一点。资料在你的电脑上,不代表这次请求已经把它交给了模型。历史聊天、附件是否真的发送,有没有超出可用上下文窗口,都需要逐一核对。
实用的办法是:开一个新对话,只放一小段必要资料来复现问题,排除旧指令和冗长历史的干扰。如果资料太长,先取相关片段并保留出处,不要指望靠调温度把缺失的内容"找回来"——模型没拿到的信息,再怎么调参数也变不出来。
第四步:检查聊天模板,而不是乱加标记
你在界面看到的是聊天气泡,模型实际接收的却是一段组织好的 token 序列。聊天模板负责标清谁在说话、哪里结束、下一步该由谁继续。它和提示词不是一回事:一个是"你说什么",一个是"怎么把消息交给模型"。
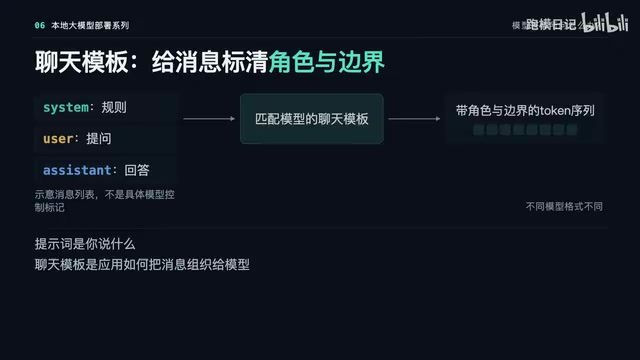
关键提醒:应用通常已经自动套好模板了。不要再手工粘一层特殊标记,否则容易重复或错配,反而制造出角色混乱的问题。
在 Ollama 里,可以用只读命令查看模型配置,它不会修改模型,只帮你找到模板、系统提示和停止设置。LM Studio 一般会从模型元数据自动配置模板,同样要先检查是否被手工覆盖。核对时务必对照这个模型的官方用法,不要从另一个模型复制整套模板。
聊天模板本质上是一套字符串格式化规则,不同模型家族的格式差异很大。以常见的几种为例:Llama 3 系列使用 <|begin_of_text|>、<|start_header_id|>user<|end_header_id|> 等特殊 token 划定角色边界;Mistral/Mixtral 则用 [INST] 和 [/INST] 包裹用户输入;ChatML 格式(被 Qwen、Phi 等多个模型采用)以 <|im_start|> 和 <|im_end|> 为标记。如果模板与模型训练时使用的格式不匹配——比如把 ChatML 标记粘贴给一个期待 Llama 3 格式的模型——这些字符就不会被识别为控制信号,而是作为普通文本出现在输入里,模型便会"看到"一堆奇怪符号,进而在回复中复现或混淆角色边界。这也是为什么排查角色混乱时,第一件事是核对当前应用实际套用的模板与模型官方说明是否一致,而不是直接叠加惩罚参数。
第五步:理解采样参数,再做对照实验
只有前面都排除了,才轮到调采样参数。这里需要先理解几个参数真正在做什么。
温度(Temperature)
模型每一步给候选 token 打分,再按规则选择下一个。降低温度,第一名的份额变大,其他候选变小;提高温度,分布更平坦。但正向的温度缩放不会把第一名变成第二名,也不会判断一个事实的真假。
温度参数作用于模型输出的 logits(每个候选 token 的原始得分):将 logits 除以温度值后再经过 softmax 转换成概率分布。温度为 1.0 时相当于不做缩放;低于 1.0 时分布向最高分集中,极端情况下趋近 0 会变成确定性的贪心解码(每步只选最高分 token);高于 1.0 时分布趋于均匀,低概率选项被选中的机会增加。需要特别说明的是,贪心解码并不等同于"正确"——如果模型的权重中本身就缺乏某项知识,或提示词指向错误方向,温度降到 0 只会让错误答案以更高的确定性反复出现,而不会让模型"想起"正确答案。
Top P
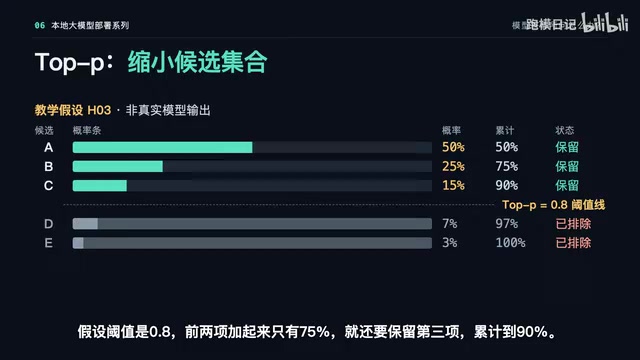
Top P 不是挑出正确答案,而是按累计概率缩小可选范围。假设阈值 0.8,前两项加起来只有 75%,就还要保留第三项直到累计到约 90%,然后在保留的候选里重新分配概率再选择。它只依据概率工作,不知道哪些词在事实层面正确,所以不能把它等同于防止胡编。
Top P(又称 Nucleus Sampling,核采样)由 Holtzman 等人在 2020 年的论文《The Curious Case of Neural Text Degeneration》中提出,初衷是解决固定 Top-K 截断的缺陷——Top-K 不管概率分布的形状,一律保留得分最高的 K 个候选,在分布极度集中时会保留大量低质选项,在分布平坦时又会遗漏合理选项。Top P 改为动态调整保留数量:按概率从高到低累加,一旦超过阈值 P 就截止,因此在分布陡峭时保留的候选较少,在分布平坦时保留较多。两个参数可以同时启用,此时模型先用 Top P 缩小候选集,再在该集合内按温度缩放后的概率做最终采样。
重复惩罚
重复惩罚能降低已出现 token 再次被选中的倾向,但不是直接删掉重复词。要注意变量名、专有名词、固定格式本来就可能需要重复,惩罚过强会伤害正常表达。不同后端的惩罚名称、公式和作用范围都不一样,不要照搬一个数字。
一个重要误区
严谨任务不等于温度必须设为 0,低随机性也不等于答案正确。例如某些官方说明会提醒:思考模式应避免贪心解码,以免性能下降或陷入重复循环。所以要先看具体模型和模式的建议,再结合自己的任务去比较。
用对照实验判断参数是否真有帮助
调参不能靠感觉。正确做法是把同一段资料和提示词固定下来,做两个只改变温度的请求(比如 0.2 和 0.7,这只是练习值而非推荐答案),并用相同的一组种子做成对比较,保存原始结果。
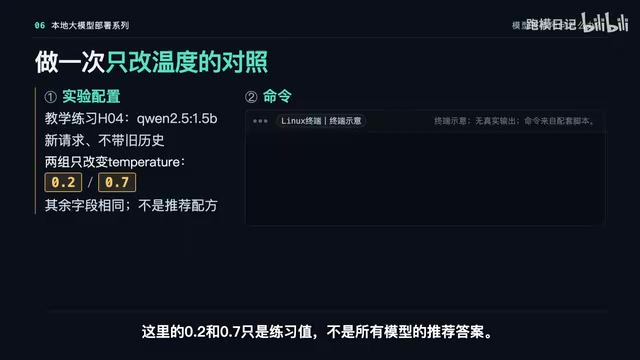
评判前要先写好人工核对标准:资料里的重量是 420 克、售价没有提供,那么每次都检查事实是否准确、格式是否符合,再看有没有重复、无关内容或输出被截断。不要因为某一次回答看着舒服,就宣布这组参数最好。两组回答完全相同也是很可能的结果。
如果反复调参都没有改善,就该回头检查资料、模板和模型本身是否适合这个任务。
排查流程速查
把整套方法浓缩成几条行动准则:
- 漏掉要求 → 先拆清任务
- 一直稳定答错 → 核对来源和模型能力
- 角色混乱或冒出特殊标记 → 优先检查模板,别只加重复惩罚
- 回答只到一半 → 看输出上限和结束原因,别一概当成胡言乱语
- 需要调采样 → 从匹配模型的基线开始,一次改一项,记录结果,随时能回退
核心逻辑始终是:先保证任务和资料清楚,再确认模板,最后才用对照实验判断参数是否有帮助。下一期将介绍如何用 Open WebUI 给本地模型接上聊天界面。
相关推荐

WorkBuddy实战指南:腾讯AI智能体如何重塑办公工作流
深度解析腾讯WorkBuddy AI智能体:它能读取本地文件、执行多步骤任务、定时运行并远程操控,与传统对话式AI有何本质区别?本文结合实战案例带你理解其核心能力与适用场景。

Codex App保姆级攻略:从安装到实战,AI帮你自动整理文件做报表
Codex App保姆级攻略:从应用商店安装、配置日常工作模式,到用真实咖啡店数据实战文件整理、Excel报表和可视化仪表板。了解计划模式和小宠物功能,一期精通Codex的AI自动化工作流。

Langfuse入门:打造财务分析智能体与评估平台
Langfuse入门教程:详解开源AI Engineer平台Langfuse的核心能力与边界,展示如何为基于Harness架构的财务分析多智能体构建企业级日志追踪、评估与可观测性平台,涵盖提示词管理、Token成本分析及与LangChain等框架的整合。