Mistral Large 4开源权重发布:1T参数模型家用硬件能跑吗

Mistral Large 4开放权重,万亿参数MoE,最低需256GB内存,建议先用API试水。
Mistral Large 4(代号LeChonc)从API预览转为开放权重下载,采用约1万亿总参数、每token激活约520亿的细粒度MoE架构,支持100万token上下文和多模态输入。许可证为修改版MIT,允许自托管和商业集成,但禁止以模型即服务方式对外提供API。厂商自报Terminal Bench 4.0得分41%、Frontier Code 2.0为19.7%,盲测仅落后Claude Opus 5.5,但均无独立复现。硬件门槛极高:1-bit动态量化需256–270GB总内存,2-bit约512GB统一内存,24GB显卡无法运行。文章给出省心桌面版、手动llama server、数据中心多卡和API四条路径,并建议先花约20美元调用API再决定是否下载数百GB权重。
欧洲的开源大模型阵营又添一员猛将——Mistral Large 4(代号LeChonc)正式从API预览转为可下载权重。发布版本经过额外三周的强化学习,在Terminal Bench 4.0上的得分从预览版的28%提升到41%。不过,随之而来的问题也很现实:你手里的设备跑得动吗?
模型规格:细粒度MoE与百万上下文
Mistral Large 4采用细粒度混合专家架构,总参数约1万亿,每token激活约520亿(计入嵌入和输出层;不计则为490亿)。内部包含128个路由专家,每token唤醒4个,另有一个始终参与投票的共享专家。上下文窗口达到100万tokens。
模型通过类Pixtrel的视觉编码器读取文本和图像,并输出超过160种语言的文本。推理努力分为低、中、高三档,默认高档,同一套权重既能应对快速对话,也能处理高难度智能体任务。
细粒度混合专家(Fine-grained MoE) 是一种在总参数量极大的模型中只激活部分参数的设计。与早期MoE(如每层2-8个大专家)不同,细粒度MoE把专家切得更小、数量更多,路由网络为每个token挑选少数几个专家参与计算。这样做的好处是:在相同激活参数量下,专家组合更灵活、专业化程度更高,训练和推理的负载也更均衡。代价是路由开销和显存占用随专家总数上升。Mistral Large 4的128个路由专家中每token只唤醒4个,再加一个共享专家,意味着绝大多数权重在处理单个token时处于“沉睡”状态,这是万亿参数模型能在约520亿激活量下运行的关键。
许可证:开源权重,但不是开源软件
Mistral为这个模型定制了“Mistral Ecosystem Open Weight License”,基于MIT修改而来。个人使用、修改、微调以及将模型集成到商业产品中都是免费的。但如果你想以模型即服务(Model-as-a-Service)的方式对外提供托管的API访问,则需要向Mistral申请单独的商用许可。
换句话说,自托管自用没问题,卖API访问不行。需要特别注意的是,这是“开放权重”(open weight),并非OSI认可的开源许可证。在公开场合称其为“完全开源”并不准确。
开放权重(Open Weight)与开源(Open Source)的区别 常被混淆。OSI的开源定义要求许可证允许任何人出于任何目的使用、修改和再分发软件,不得对使用领域设限。开放权重只保证模型参数文件可下载、可自托管,但许可证往往附加限制条款——本例中即禁止未经许可将模型作为托管API对外售卖。这类“几乎开源但带商业保护”的许可证在Llama、Gemma等模型上已有先例,业界通常合称“开放权重模型”。对开发者而言,实际差别在于:内部使用、微调和集成进产品一般自由;但若想搭建竞品推理服务,需另行谈判许可。
基准测试:厂商数据亮眼,但需独立验证
Mistral和Hugging Face公布了一系列成绩,但这些都属于厂商自报数据,尚无独立实验室完整复现。
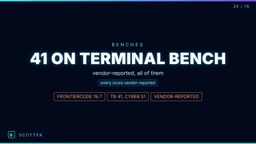
在Cognition的Frontier Code 2.0(考察维护者是否愿意合并智能体的改动)上,它以19.7%领先。Terminal Bench 4.0得分41%,比预览版提升13个百分点,同时输出token减少30%。Artificial Analysis Coding Agent Index给出48%,与领先的开源权重模型基本持平,但每任务token消耗少47%。Cyber Index为51%,恶意网络拒绝率96.6%,是所测开源模型中最高的。在Surge Code盲测中,评分者偏好它胜过所有开源对手,仅落后于Claude Opus 5.5。
这些数字很漂亮,但在社区复跑之前,最好把它们当作“声称”而非“事实”。
显存阶梯:你的设备在哪一档
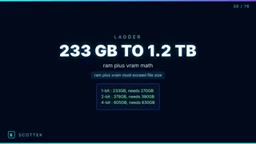
以下数据来自Unsloth的Day Zero文档。需要强调的是,这里的“总内存”指RAM与VRAM之和,并要为操作系统、KV缓存和运行时缓冲区留出余量。
- 动态1-bit量化:磁盘占用233GB,需要256–270GB总内存。1-bit保留了91%的top-1准确率,体积比FP8小80%。
- 2-bit:占用更小,保留95%准确率,体积约为FP8的三分之二。
- 3-bit:文件302–378GB,需要310–390GB内存;另一档3-bit需要435–500GB。
- 4-bit:需要630GB。
- 8-bit:需要1.2TB。
压缩效率已经相当出色,但这仍然是一台“卡车”级别的负担。
量化位数与精度保留 的关系需要理解:1-bit、2-bit等指每个权重平均占用的比特数,位数越低文件越小、显存越省,但信息损失越大。动态量化会在层与层之间分配不同精度,对敏感层保留更高位数,因此1-bit仍能保住约91%的top-1准确率。另一个关键概念是统一内存(Unified Memory):Apple Silicon等架构中CPU与GPU共享同一块内存池,模型不必在RAM和VRAM之间搬运,因此“总内存=RAM+VRAM”的口径对大内存Mac尤其适用。传统独立显卡平台上,权重必须完整驻留VRAM,超出部分靠卸载到系统内存,速度会显著下降。
四条运行路径:按硬件选门
Mistral官方给出了两条采样设置建议:temperature 1.0,top P 0.95,对所有推理档位一致。不要用老式聊天模型的低温设置,较高的温度配合top P过滤才能让推理模式保持多样性而不崩坏。推理档位按任务选择:低档替代旧的“none”模式,适合简单问题;中档是日常聊天和轻量工具的默认;高档用于编码会话、长工具链和艰难分析,也是出厂默认。
运行方式大致有四条路:
- 省心路线:Unsloth桌面版(Mac/Windows/Linux)找到模型入口,下载内存允许的量化版本,一条命令即可提供服务,支持推理努力设置。
- 折腾路线:使用Llama server配合GDK,手动控制GPUF路径、上下文大小、GPU层数和采样标志。
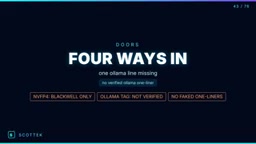
- 数据中心路线:官方FP8或NVFP4检查点,用VLLM或SGLang跨8块GPU部署,NVFP4版本仅支持Blackwell卡。
- API路线:不想下载几百GB的话,直接调用API。
需要提醒的是,目前没有经过验证的Day Zero Ollama库列表。GGUF文件存在,但Ollama标签没有,不要粘贴无法验证的命令。
推理引擎的选择 直接影响部署可行性。VLLM和SGLang是数据中心常用的高吞吐服务框架,支持张量并行(把模型切分到多块GPU上协同计算)、连续批处理和PagedAttention等优化,适合8卡级别的FP8/NVFP4部署。llama.cpp(文中“Llama server配合GDK”所指的生态)则面向单机与消费级硬件,支持GGUF格式和各种量化,能在CPU+GPU混合环境下运行,但吞吐和并发能力有限。Ollama是在llama.cpp之上的封装,提供更简单的模型拉取与运行体验,其模型库标签需官方审核,因此新模型发布初期常出现“GGUF已存在但Ollama标签未上线”的窗口期。
单机现实:没有24GB显卡的故事
坦诚地说,24GB显卡跑不动这个模型。1-bit需要256GB统一内存,意味着一台顶配Mac Studio或两台DGX Spark。2-bit需要约512GB统一内存,一台Apple Silicon Ultra级机器,速度大约每秒15个token。4-bit需要630GB,已经超出单机范畴,需要两台大型工作站或一个小型集群节点。数据中心方案则是8块H200跑FP8,或4块B200跑NVFP4。
家用实验室的选择只有三个:大统一内存Mac、RAM+VRAM池化加卸载、或者直接走API。走API不丢人。
竞争格局与API定价
与同类巨模型相比:Beam 501B采用Apache 2.0许可证且无托管限制,许可证更自由;但Mistral声称在编码和网络安全方面领先,且token效率更高。Kimmy K2是另一个约1万亿参数的MoE,社区认为其单机故事更友好。Step 5 Preview为6000亿参数,面向数据中心。Quen 3.8 Max为2.4万亿参数纯文本模型,采用定制商业许可。LeChonc的定位是中间路线:声称最好的开源编码和防御数据、单一检查点多模态输入输出、欧洲基础设施训练,以及允许自托管(但不允许做竞品API生意)的许可证。
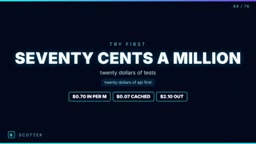
API定价为每百万输入token 70美分,缓存命中7美分,每百万输出token 2.10美元。一个周末的智能体实验成本比一顿午饭还低。Mistral的vibe code可以直接指向你的仓库,OpenRouter也提供该模型,Nvidia则提供端点加优化NIM容器,方便在自建前测试服务路径。
结论:先花20美元再决定
如果你有512GB统一内存的机器,下载2-bit动态量化,聊天用中档、智能体用高档。如果有256GB,选1-bit并保持上下文适中。如果有Blackwell集群,拉取官方NVFP4并用VLLM或SGLang服务。其余人,走API,或者等官方承诺的蒸馏小版本(目前没有时间表)。
最务实的建议:先花20美元跑API调用。如果答案值得你下载400GB,你自然会知道;如果不值得,你省下了一个周末的rsync时间。在相信任何人的截图之前——包括我的——先测量你自己的设备。
相关推荐

Claude国内使用与充值全攻略:三种方式对比及防封控指南
整理Claude国内使用与会员充值的三种方式:海外信用卡直充、苹果美区ID与安卓Google Play内购、网站自助充值,对比各自门槛、成本与封控风险,并给出固定设备、稳定IP、不共享账号等五条降低封号概率的使用习惯。

从ChatGPT内容限制到Eval、可观测性与Guardrail实战
通过电子商店订单Agent实战,讲解ChatGPT内容限制背后的工程逻辑,以及Eval评估、Observability可观测性和Guardrail护栏如何协作,避免同名用户数据泄露与提示注入风险。

LangChain4j决策模型:本地校验Java工具调用
LangChain4j社区提出决策模型方案,在本地对Java工具调用进行校验,将控制逻辑从LLM拉回应用侧,提升工具调用的可靠性与可调试性。