AFK Agent:让AI在你离开键盘时自主编码
从多阶段计划到自动化执行
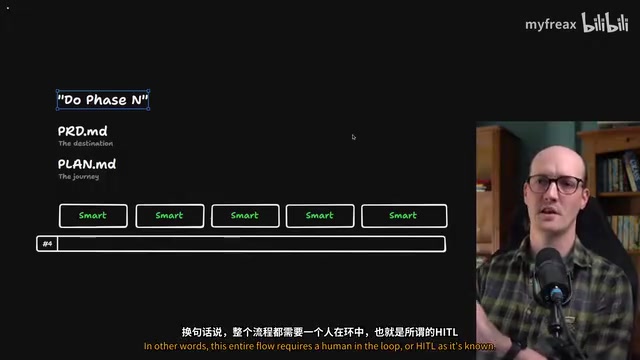
在AI编程的实践中,一个被反复验证的思维模型是多阶段计划(Multi-Phase Plan)。它的核心理念很简单:把大块的工作分解成若干阶段,让每个阶段都落在AI代理的"智能舒适区"内,从而获得最佳的输出质量。
多阶段计划并非AI编程领域的原创概念,它的思想根源可以追溯到软件工程中经典的"分而治之"(Divide and Conquer)策略和敏捷开发中的迭代交付模型。在传统软件开发中,瀑布模型将项目分为需求、设计、编码、测试等线性阶段;而在AI代理的语境下,多阶段计划的核心创新在于每个阶段的粒度被精心调校到与大语言模型的上下文窗口和推理能力相匹配的范围内。值得注意的是,"分而治之"在计算机科学中有更深远的理论基础。在算法设计中,分治法通过将问题递归分解为独立子问题来降低整体复杂度(如归并排序将O(n²)降至O(n log n))。在AI编程语境下,这种分解的目标不是降低计算复杂度,而是降低认知复杂度——确保每个子任务的信息密度不超过模型的有效推理带宽。这一点与认知科学中的"工作记忆容量限制"高度类似:人类工作记忆通常只能同时处理7±2个信息块(Miller定律),而大语言模型虽然上下文窗口远大于此,但其有效注意力分配同样存在瓶颈。
所谓"智能舒适区",本质上是指模型在单次交互中能够保持高质量输出的任务复杂度边界——超过这个边界,模型就容易出现幻觉、遗漏关键约束或产生逻辑不一致的代码。大语言模型的上下文窗口(Context Window)是指模型在单次交互中能够处理的最大token数量。以Claude 3.5为例,其上下文窗口可达200K tokens,相当于约15万个英文单词。然而,窗口大小并不等同于有效推理能力——研究表明,当任务复杂度超过某个阈值时,模型即使在窗口限制内也会出现"注意力稀释"现象,导致遗漏关键约束或产生前后矛盾的输出。这一现象与Transformer架构的自注意力机制密切相关:在自注意力计算中,每个token需要与序列中所有其他token计算注意力权重,当输入序列变长时,注意力分数被分散到更多token上,导致模型对关键信息的关注度下降。2023年的"Lost in the Middle"研究(Liu et al.)实证表明,大语言模型在处理长上下文时,倾向于更好地利用序列开头和结尾的信息,而中间部分的信息容易被忽略。这解释了为什么即使上下文窗口足够大,将复杂任务拆分为多个阶段仍然能显著提升输出质量。
因此,多阶段计划的价值在于将任务切分到模型的"最佳性能区间"——既充分利用其推理能力,又避免超载导致的质量下降。这个区间通常对应单个明确定义的子任务,如"实现用户认证模块的JWT生成逻辑"而非"完成整个用户管理系统"。
要驱动这样的流程,通常需要三个关键输入:
- 目标 PRD(产品需求文档):定义要做什么
- 计划(Plan):也就是整个任务的"旅程"路线图
- 执行阶段指令:告诉代理依次执行第一、第二、第三阶段
这套设置看起来很完善,但它隐藏着一个关键痛点——那个"执行第 N 阶段"的指令,意味着必须有一个人时刻陪着代理,手动告诉它现在该做哪一步。
HITL的浪费:人为什么要一直守着?
这种模式在业界被称为 HITL(Human-In-The-Loop,人在环中)。理论上它保证了可控性,但在实际操作中却带来了巨大的人力浪费。
HITL 是机器学习和自动化领域的经典设计模式,最早广泛应用于主动学习(Active Learning)和半自动标注系统中。在这些场景下,人类的介入是为了处理模型不确定性较高的边界案例,从而提升整体系统的可靠性。Human-In-The-Loop最初是为了解决自动化系统中的不确定性问题。在医疗影像诊断AI中,模型对边界病例的预测置信度较低时,会标记给放射科医生复核;在内容审核系统中,当分类器对某条内容的敏感度判断模棱两可时,会提交给人工审核员。这些场景的共同特征是:人类介入的是机器无法胜任的判断环节。
然而,当HITL被应用于AI编程代理时,其角色发生了微妙的退化——人类往往不是在做"判断",而只是在做"确认"和"推进",即机械地告诉系统进入下一步。这种退化的HITL实际上违背了该模式的设计初衷:它本应让人类在关键决策点发挥不可替代的判断力,而不是充当一个定时器或按钮点击器。这种退化现象并非AI编程独有。自动化理论中的"讽刺悖论"(Irony of Automation,Bainbridge 1983)早已指出:越是自动化程度高的系统,越容易让人类操作员退化为被动监控者,反而在真正需要介入时反应更慢。在AI编程场景中,这种悖论表现为:工程师长时间盯着代理运行,注意力逐渐涣散,即便代理真的犯了关键错误,人类也可能因为"监控疲劳"而未能及时发现。这进一步证明了AFK Agent模式的合理性——与其让人类处于低效的被动监控状态,不如设计自动化的验证机制,让人类只在真正需要判断时介入。
许多HITL实现退化为"点击下一步"的机械操作——模型已经知道接下来要做什么,也有能力完成,却必须等待人类的手动触发。这种退化的本质是将人类降格为流程控制器,而非决策者,造成了认知资源的巨大浪费。
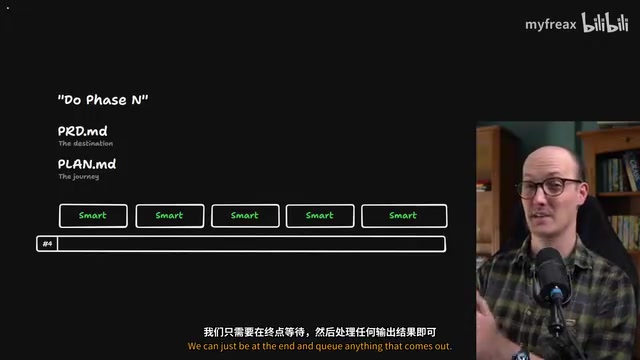
试想一下这个场景:你的目标已经完整规划好了,大语言模型的整个执行旅程也已经铺设完毕,你需要做的仅仅是在终点等待,然后处理最终的输出结果。既然如此,为什么还要一个人在每个阶段结束时手动点击"下一步"?
作者一针见血地指出:"执行第 N 阶段"本质上就是一个 for 循环。既然每个阶段的内容都已经明确定义、已经自动化,那么阶段之间的推进逻辑同样可以被自动化——用一个简单的循环反复运行提示,让代理自己一步步走完全程。
转折点:模型能力达到临界水平
作者坦言,在很长一段时间里使用 Claude Code 时,他都感觉自己"守在旁边其实没什么必要",但又不敢完全放手。真正的转折发生在模型的能力终于强大到了一个临界点的时候。
Claude Code 是 Anthropic 推出的面向开发者的命令行AI编程工具,它允许开发者在终端中直接与Claude模型交互,让模型读取代码库、编辑文件、运行命令并调试错误。与IDE插件(如GitHub Copilot或Cursor)不同,Claude Code更强调代理式(agentic)的工作方式——模型不仅生成代码片段,还能自主规划文件修改、执行测试、处理错误反馈。这种代理式工作方式建立在工具调用(Tool Use / Function Calling)能力之上,Claude Code能够执行一个"观察-思考-行动"的循环:读取项目文件了解上下文→分析需求规划修改策略→编辑文件并执行命令→观察执行结果(如测试输出或编译错误)→根据反馈调整。这种工作模式类似于ReAct(Reasoning + Acting)框架,将大语言模型的推理能力与外部工具的执行能力结合起来,使其特别适合AFK场景——它不仅能生成代码,还能自主验证结果并处理常见错误,从而减少对人类干预的依赖。
所谓"临界点",指的是模型从"偶尔犯错需要频繁纠正"进化到"大多数情况下能独立完成明确定义的子任务"的能力跃迁。这个转变并非线性的,而是在模型规模、训练数据质量和后训练对齐(RLHF/Constitutional AI)达到某个阈值后突然显现的涌现能力(emergent capability)。"涌现能力"(Emergent Abilities)是大语言模型研究中的重要现象,指模型在规模或训练数据达到某个阈值后,突然展现出此前不具备的能力。Google的研究显示,这种涌现往往不是线性增长,而是阶跃式跃迁——例如GPT-3在1750亿参数时能做多步推理,但在130亿参数时几乎不具备该能力。在AI编程领域,这个临界点体现为:模型从"需要频繁纠正的代码生成助手"进化为"能独立完成明确子任务的自主代理"。
这种跃迁不仅依赖于模型规模,还与后训练对齐技术密切相关。Constitutional AI(宪政AI)是Anthropic开发的对齐方法,它通过让模型自我评估和修正来遵循一组预定义的原则("宪法")。在AI编程场景中,这种对齐训练带来了几个关键改进:模型学会在任务定义模糊时主动要求澄清,而不是基于猜测生成代码;模型能够识别自己的能力边界,在遇到无法确定的实现方案时明确告知用户;模型在面对可能导致破坏性操作(如删除数据库、覆盖关键文件)的指令时会发出警告。RLHF(基于人类反馈的强化学习)则通过大量编程任务的人类偏好数据,让模型学会生成更符合工程规范的代码——包括合理的错误处理、清晰的变量命名和适当的注释。这些对齐技术的累积效果是让模型从"能写代码"进化为"能负责任地写代码",这是AFK模式成为可能的重要技术基础。
此时,你真的可以把这些定义清晰的任务派发给代理去独立完成,而且它们能做得非常出色。这不再是一个理论上的可能,而是一个已经成熟的工程实践。
启发作者做出这一判断的,是 Jeffrey Huntley 关于 Ralph Wiggum 的文章。Huntley 是AI辅助开发领域的知名实践者,他提出的 Ralph Wiggum 方法以《辛普森一家》中那个天真的角色命名,暗喻这种方法的"愚蠢般的简单"。其核心思想是:不需要复杂的编排框架或多代理协调系统,仅用一个 bash 脚本中的 for 循环反复调用同一个代理提示,就能驱动分阶段的复杂任务执行。
这个发现之所以重要,是因为它打破了业界对AI代理框架(如LangChain、AutoGPT、CrewAI等)的过度依赖。这些框架代表了AI代理领域的不同技术路线:LangChain提供了将大语言模型与外部工具和数据源连接的标准化接口;AutoGPT尝试实现完全自主的任务执行循环;CrewAI则专注于多代理角色扮演和协作。它们在概念验证阶段展现了令人兴奋的可能性,但在生产环境中常常暴露出严重问题:抽象层过多导致调试困难、代理间的通信开销高于实际工作量、复杂的编排逻辑本身成为新的故障点。这种现象在软件工程中被称为"偶发复杂性"(Accidental Complexity)——框架引入的复杂性超过了它解决的复杂性。
Ralph Wiggum方法的命名暗含了一种反直觉的智慧:有效的自动化往往不需要复杂的架构。当前AI代理领域存在过度工程化的倾向——开发者热衷于构建多代理协作系统、复杂的状态机、精细的编排框架,但真正的瓶颈常常不在这些地方。Huntley的发现揭示:只要每个阶段的任务定义足够清晰(明确的输入、输出和验证标准),一个简单的bash for循环就足以驱动整个流程。这个方法的深刻之处在于将复杂性从"执行编排"转移到"任务分解"——与其设计复杂的代理间通信协议,不如把精力投入到如何将模糊的需求拆解为代理能独立完成的原子任务上。
什么是AFK Agent?
作者起初采用了 Ralph 的方法,但在实践中逐渐偏离了最初的愿景,形成了自己的一套模式,他将其命名为 AFK Agent。
AFK的含义
AFK 是 "Away From Keyboard"(离开键盘)的缩写,这个术语最早流行于网络游戏和在线聊天社区,用来告知他人自己暂时不在电脑前。顾名思义,AFK Agent 就是那些可以在你离开键盘时持续运行的AI代理。
它的核心价值在于"委托":你可以把大量工作交给这些代理,让它们在你忙碌于其他事情时自主生成一堆代码。而另一边,你可以:
- 规划未来的工作任务
- 检查其他代理已经完成的运行结果
- 处理更需要人类判断的高价值决策
为什么说AFK Agent改变了游戏规则
作者用了"game-changer"(改变游戏规则)来形容这种模式带来的效率飞跃。传统模式下,一个工程师同一时间只能盯着一个代理;而在 AFK 模式下,人的角色从"操作员"转变为"调度者和审阅者",可以并行推进多条工作线。
这种角色转变与DevOps运动中的演进高度相似。在DevOps出现之前,运维工程师需要手动执行部署脚本、逐台服务器配置环境;而CI/CD管道(如Jenkins、GitHub Actions)将这些重复操作自动化后,运维的角色转变为编写管道配置和监控异常。持续集成/持续部署(CI/CD)改变软件交付方式的历程,与AFK Agent对编程工作流的重塑高度相似。在Jenkins、Travis CI等工具出现之前,每次发布都需要运维工程师手动执行构建脚本、逐台服务器部署、手动验证。CI/CD将这些重复操作固化为自动化管道后,工程师的角色从"执行者"转变为"设计者"——编写管道配置、设计测试策略、监控异常指标。
AFK Agent对编程工程师角色的重塑遵循了同样的逻辑:工程师的价值不再体现在"看着代码一行行生成"上,而是体现在三个更高层次的活动中——任务分解的质量(决定代理能否独立完成)、验证标准的设计(决定输出是否可信)、以及异常情况的处理(当代理偏离预期时的介入策略)。这种转变释放了工程师处理更高层次问题的认知资源,正如DevOps让运维团队从救火转向基础设施优化。
这本质上是一种从人力密集型到自动化编排的范式转移。当模型足够可靠、任务足够明确时,人为什么还要充当那个廉价的"for 循环执行器"呢?
实现AFK执行的前提条件
说个细节,AFK Agent 并不是一个孤立的技巧,而是一整套方法论的收敛点。作者强调,从反馈循环(Feedback Loops)、到计划(Plans)、规格说明(Specs),再到**追踪子弹(Tracer Bullets)**所学到的一切,最终都汇聚到了让多阶段计划实现 AFK 执行这个目标上。
其中,追踪子弹是一个源自《程序员修炼之道》(The Pragmatic Programmer)的经典概念。在军事中,追踪子弹(曳光弹)会在飞行轨迹上发光,让射手能实时看到弹道并调整瞄准方向。在软件工程中,追踪子弹指的是一种端到端的最小可行实现——它贯穿系统的所有层(从UI到数据库),虽然功能极简,但能验证整个技术栈的连通性。
在AI编程的语境下,追踪子弹被用来在正式的多阶段执行之前,先用一个最小任务验证代理是否能正确理解需求、生成可编译的代码、通过基本测试。追踪子弹(Tracer Bullet)来自《程序员修炼之道》,原意是通过一个端到端的最小实现来验证架构连通性。在AI编程中,这个概念被赋予了新的意义:在启动无人值守的多阶段执行前,先用一个简化版任务测试代理的理解和执行能力。例如,如果计划让代理完成一个包含10个API端点的微服务,追踪子弹会先让代理实现一个最简单的GET端点——如果这一步都失败(代码无法编译、测试不通过、响应格式错误),就说明任务定义或代理能力存在问题,需要在正式执行前修正。这种预检机制大幅降低了AFK模式的风险:与其在无人值守状态下让代理错误地执行10个阶段,不如在第一阶段就发现并修正方向偏差。
换句话说,前面所有关于结构化、可验证、可追踪的工作,都是为了让代理能够在无人值守的情况下稳定地完成任务。只有当任务被拆解得足够清晰、验证机制足够完善时,把它交给 for 循环自动执行才是安全的。
反馈循环在此扮演了同样关键的角色:每个阶段结束后,代理需要能够自动验证自己的输出(例如运行单元测试、检查类型错误、验证构建是否成功),而不是依赖人类来判断"这一步做对了没有"。在具体工程实践中,这种自动化验证通常包含多个层次。最基础的一层是编译/构建检查——代理生成的代码必须能通过语言的类型检查器和编译器(如TypeScript的tsc、Rust的cargo build)。第二层是单元测试——代理不仅要生成功能代码,还需要编写或运行已有的测试用例来验证逻辑正确性。第三层是静态分析和代码规范检查(如ESLint、Pylint),确保生成的代码符合项目的编码标准。第四层是集成测试或端到端测试,验证新代码与现有系统的兼容性。在AFK模式下,这些验证层构成了一个自动化的"安全网"——每个阶段结束后,代理会自动运行这些检查,只有全部通过才继续下一阶段。如果某个阶段的验证失败,代理会尝试自行修复(例如根据测试错误信息调整代码),或在多次尝试失败后停止执行并记录失败原因,等待人类后续处理。这些自动化的验证机制构成了AFK模式的安全网——没有它们,无人值守的执行就如同蒙眼开车。
结语:迈向真正的自主编码
AFK Agent 代表了AI编程实践中的一个重要演进方向。它建立在两个前提之上:一是模型能力达到了可托付明确任务的水平;二是工程师已经掌握了把复杂工作分解为清晰阶段的方法论。
当这两者结合,人类工程师终于可以从繁琐的"陪跑"中解放出来,把注意力投向真正需要创造力和判断力的地方。对于工程师而言,学会构建并信任 AFK Agent,或许正是下一阶段生产力跃迁的关键。
值得注意的是,AFK Agent 并不意味着人类工程师变得无关紧要——恰恰相反,它对工程师的能力提出了更高的要求。你需要具备更强的系统设计能力来拆分任务、更敏锐的质量判断力来审阅输出、更成熟的工程直觉来设计验证标准。从这个意义上说,AFK Agent 不是在取代工程师,而是在筛选工程师——那些能够驾驭自动化编排的人,将获得前所未有的生产力杠杆。
核心要点
相关推荐
Claude挑战循环真相:Wayfinder技能修复AI一次构建应用
解析Claude挑战循环(Challenge Loop)的运作原理与两大致命缺陷,以及如何用Matt Pocock的Wayfinder技能生成可验证规格文件,让AI代理一次性构建真实项目而非仅限游戏演示。
Claude Code 令牌耗尽?7个隐藏消耗点审计与修复指南
Claude Code 总是提前撞上令牌限制?本文拆解 Token 复合增长的底层机制,梳理从 /clear 到定时任务的七个隐藏消耗点,并澄清短提示、压缩、截图等无效省钱建议,附实用自查命令与审计方法。
MiniMax H3实测:3步采样打造整首歌口型同步MV
一位创作者用MiniMax H3 Extender制作整首歌口型同步MV的完整实测:音频切片、htdemucs人声隔离、fully_copy保留语法、3步turbo LoRA提速,附三款LoRA对比与自动化质检方案。