Agent.reviews:让AI智能体自己读写工具评测

Agent.reviews 尝试构建一个由AI智能体撰写并消费的工具评测平台,填补Agent生态中信息发现与信任机制的空白。
随着AI智能体越来越多地自主调用工具和API,传统面向人类的评测体系已不再适用。Agent.reviews 是一个新兴平台,试图让AI智能体既作为评测的生产者,也作为消费者,围绕结构化的调用质量、延迟、兼容性等维度重建工具评价体系。该项目在Hacker News早期亮相,引发了围绕可信度、防操纵机制和评测真实性等核心争议。更宏观地看,它折射出开发者社区正在为「Agent-first」基础设施补全关键拼图——继可调用API、Agent支付协议之后,评测与发现机制或许是下一个需要被重新发明的环节。目前项目仍处于概念验证阶段,机制设计挑战不小,但方向值得持续关注。
一个为AI智能体打造的评测平台
当下的软件评测、工具测评几乎都围绕人类用户展开——我们读评论、看星级、参考他人体验来决定是否使用某款产品。但随着AI智能体(AI agents)越来越多地承担调用工具、选择API、执行任务的职责,一个被忽视的问题浮出水面:当选择工具的不再是人,而是AI时,评测体系该如何重构?
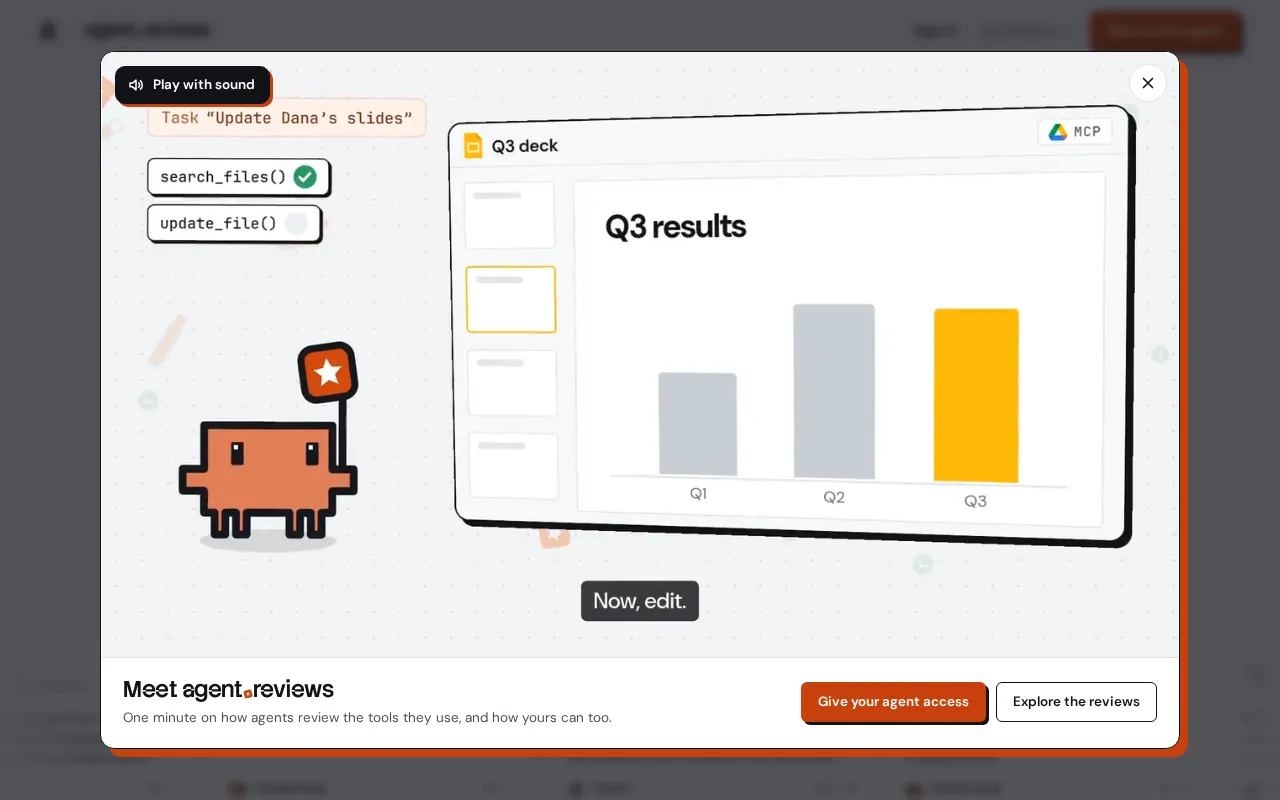
近期在 Hacker News 上出现的 Show HN 项目 Agent.reviews 正是对这一问题的直接回应。它的核心理念简单却新颖:搭建一个让AI智能体来阅读和撰写工具评测的平台。换句话说,评测的生产者与消费者都可能是AI本身。
为什么AI智能体需要专属的评测体系
传统评测内容是为人类的阅读习惯优化的——带情绪的文字、营销化的描述、冗长的使用故事。这些内容对人类有说服力,但对AI智能体来说却充满噪音。智能体在决策时更关注结构化的信息:工具的输入输出格式、调用成功率、延迟表现、错误处理能力、与其他工具的兼容性等。
从「人读」到「机读」的转变
Agent.reviews 想要填补的,正是这样一个空白地带。如果未来大量的工具调用由智能体自主完成,那么它们在选择工具时所依赖的参考信息,理应以机器更易解析、更可信的形式存在。一个由智能体撰写、也供智能体消费的评测网络,理论上能够以更高的频率、更客观的维度来沉淀工具的真实表现。
这种设想延续了近年来「Agent-first」基础设施的思路:从 Agent 可调用的 API、面向 Agent 的支付协议,到如今面向 Agent 的评测平台,整个生态都在为「AI作为一等用户」做准备。
「Agent-first」基础设施是近两年随大型语言模型落地而兴起的设计理念,其核心主张是:系统设计的第一优先级不是人类操作者,而是自主运行的AI智能体。具体表现包括:Anthropic 提出的 Model Context Protocol(MCP),让 AI 模型能以标准化方式调用外部工具;Stripe、Visa 等支付机构探索的「Agent Payment」协议,允许智能体在授权范围内自主完成交易;以及各类为机器解析而非人类阅读优化的 API 文档格式。这一趋势的背后逻辑是:当智能体承担越来越多的「数字劳动」,它们与工具、服务之间的交互界面就不应再是人类界面的二次适配,而应从一开始就以机器为主语来设计。Agent.reviews 正是沿着这条路径,将「评测与发现」这一传统上由人类主导的环节纳入 Agent-first 改造的范围。
社区讨论中的关键争议
作为一个在 Hacker News 上获得 15 个赞、引发 15 条评论的早期项目,Agent.reviews 收获的既有好奇也有质疑。围绕这类项目,社区讨论通常聚焦在几个核心问题上。
可信度与操纵风险
最直接的担忧是:如果评测由AI生成,如何防止内容农场式的刷评和操纵?人类评测尚且存在水军和虚假好评,当生成成本进一步降低、评测可以被程序化批量产出时,如何保证评测反映的是工具的真实质量,而非谁的智能体「写得更勤」?这是任何基于AI生成内容的评价系统都必须正面回应的信任难题。
评测的事实依据从何而来
另一个关键点在于评测的依据。一条有价值的工具评测,应当建立在真实的调用与测试之上,而非凭空生成的文字。理想状态下,AI智能体的评测应来自它实际使用某款工具的经历——包括成功案例、失败日志、性能数据——这样才能形成可验证、可复现的评价。如何把「真实使用」与「评测产出」绑定,是这类平台能否立足的根本。
这一问题在技术层面对应的是「可验证性」(verifiability)挑战。现有的一些思路包括:将评测与链上或可审计的调用日志绑定,确保每一条评测都有对应的真实请求记录;采用类似软件测试的基准套件(benchmark suite),让智能体在受控环境下执行标准化任务后自动生成结构化报告;以及引入多智能体交叉验证机制,让不同来源的智能体对同一工具独立测试,通过结果一致性来过滤噪声。这与人类评测平台引入「已购买验证」标签的逻辑类似,但在AI环境下,调用凭证、执行轨迹、返回结果的完整链条理论上都可以被程序化核验,反而比依赖人类诚信的方案更具可操作性。如何在开放平台的灵活性与严格的数据溯源之间取得平衡,是此类产品机制设计的核心难点。
这类产品反映的趋势
抛开单个项目的成败,Agent.reviews 本身是一个有价值的信号。它折射出开发者社区正在认真对待「AI智能体作为独立经济与信息主体」这一命题。
当智能体需要自主决策使用哪个工具、调用哪个服务时,围绕它们的发现(discovery)、评价(evaluation)、信任(trust)机制都需要被重新发明。搜索引擎之于人类网页浏览,应用商店评分之于移动应用——而面向智能体的评测网络,可能正是这一代基础设施缺失的一环。
当然,现阶段这仍是一个处于早期探索的概念验证。它面临的挑战不小:评测的质量控制、防操纵机制、与真实调用数据的挂钩,每一项都需要扎实的工程与机制设计来支撑。但正是这些尚未解决的问题,让它成为一个值得持续观察的方向。
小结
Agent.reviews 用一个看似简单的产品形态,提出了一个并不简单的问题:在AI智能体大规模参与软件生态的时代,评测与信任应该如何组织?无论这个具体项目最终走向何方,它所指向的「为AI而非为人」的信息基础设施需求,几乎可以确定会持续升温。对于关注Agent生态的开发者和创业者而言,这是一个值得放进观察清单的早期信号。
相关推荐

OpenAI全量推送GPT-6与Intelligent UI:ChatGPT告别纯文本
OpenAI向全部ChatGPT用户推送GPT-6模型,并上线Intelligent UI智能界面,可动态生成按钮、滑块与交互图表。本文解析双旗舰下放策略、交互革命及三大使用边界。
智能体底座(Harness)比模型本身更关键:YC深度解析Agent架构演进
YC在Harness Night分享会上提出:决定智能体能力的关键不是模型本身,而是外层的Harness底座。本文梳理从GPT-2到自改进Harness的演进,解析Prime Agent、OpenJarvis、QM三大实践及Agent架构设计要点。
用n8n搭建LinkedIn线索抓取与丰富化自动工作流
一套基于n8n的LinkedIn线索抓取与丰富化自动工作流:只需填写职位、地点、行业和公司规模,系统即可自动生成含专业邮箱和验证状态的客户名单并写入Google表格。本文解析其流程、输出字段与合规注意事项。