#AI基础设施
共 56 篇相关文章

英伟达Rubin让Devin吞吐提升4.8倍,但它真的更快了吗?
英伟达最新Vera Rubin服务器让Cognition的编程智能体Devin实现4.8倍token吞吐,但这到底意味着更快还是更便宜?本文拆解4.8倍的真实含义、GPU吞吐与速度的权衡,以及为何Devin任务不会同比例加速。

RLinf强化学习基础设施:社区讨论与价值分析
围绕Reddit社区对强化学习基础设施RLinf的讨论请求,分析RL基础设施的核心价值、评估维度与技术选型方法,为开发者提供参考框架。

美国民众为何开始反对数据中心?
一则 Hacker News 讨论揭示美国公众对数据中心态度的转变。在 AI 算力需求激增背景下,数据中心的电力、水资源与社区影响正引发越来越多争议。本文剖析这一趋势背后的结构性矛盾。

数字孪生+AI智能体:验证AI工厂变更的新范式
NVIDIA提出用数字孪生结合AI智能体验证AI工厂变更的新方法,在虚拟环境中预演GPU、网络等基础设施调整,降低大规模AI集群运维的生产风险。

AICR v1.0发布:开放可验证的GPU集群配置方案
NVIDIA推出AICR v1.0,为GPU加速的Kubernetes集群提供开放、稳定、可验证的配置方案,解决内核、驱动、CUDA等数十个组件的版本兼容难题,提升AI基础设施的可靠性与可审计性。

Homa协议能否终结TCP在AI集群中的统治?
Homa是斯坦福团队提出的面向AI集群的新型传输协议,试图解决TCP在数据中心的队头阻塞、尾部延迟等问题。本文解析Homa的设计思路及其能否取代TCP。

算力上太空:谷歌与Planet原型卫星成功发射意味着什么
谷歌与Planet合作的太空算力原型卫星由SpaceX成功发射。本文解析把计算搬到太空的动因、工程挑战以及商业航天生态的协同意义。

多区域路由架构解析:GLOBAL选项如何优化全球推理工作负载
解析AI推理服务的多区域路由架构:如何利用GLOBAL选项将全球工作负载放置移出推理热路径,在低延迟、系统弹性与运维便利之间取得平衡,为全球化AI基础设施设计提供参考。

Dragonfly 2.5解析:P2P如何加速AI大模型分发
Dragonfly 2.5版本深度解析:基于P2P技术如何加速AI大模型与镜像分发。涵盖Injector、Blocklist、自适应限流、OCI模型镜像打包、Snapshotter及轻量版等核心更新,助力大规模集群与AI推理训练场景。

Perplexity押注垂直整合:Vera芯片替代x86背后的Agent基建野心
Perplexity宣布垂直整合其智能体基础设施,自建沙箱并押注Vera架构替代x86,开始部署Perplexity Computer。本文解析这一战略背后的技术逻辑与行业意义。

谷歌Project Suncatcher原型卫星入轨:太空AI数据中心迈出第一步
谷歌Project Suncatcher原型卫星成功入轨,标志着太空AI数据中心构想进入技术验证阶段。本文解析其利用太空太阳能支撑AI算力的思路、工程挑战与行业意义。

亚马逊拟向投资者转让80亿美元英伟达芯片,意欲何为?
亚马逊寻求将价值80亿美元的英伟达芯片转让给投资者,背后是AI算力金融化与资本效率优化的新趋势。本文解析这一举动的战略动机、风险再分配逻辑及对云计算行业的潜在影响。

NVIDIA cuObject 与 SCADA Server SDK:加速AI存储访问新方案
NVIDIA 推出 cuObject 与 SCADA Server SDK,为AI基础设施提供高速、安全的文件与对象存储访问方案,解决GPU数据I/O瓶颈,提升大规模AI训练与推理效率。

Restate获2000万美元融资:AI智能体催热持久化基础设施赛道
AI智能体推动持久化基础设施需求激增,由Apache Flink老兵创立的初创公司Restate完成2000万美元融资,正面挑战工作流编排巨头Temporal。本文解析持久化执行为何成为AI应用落地的关键底层。
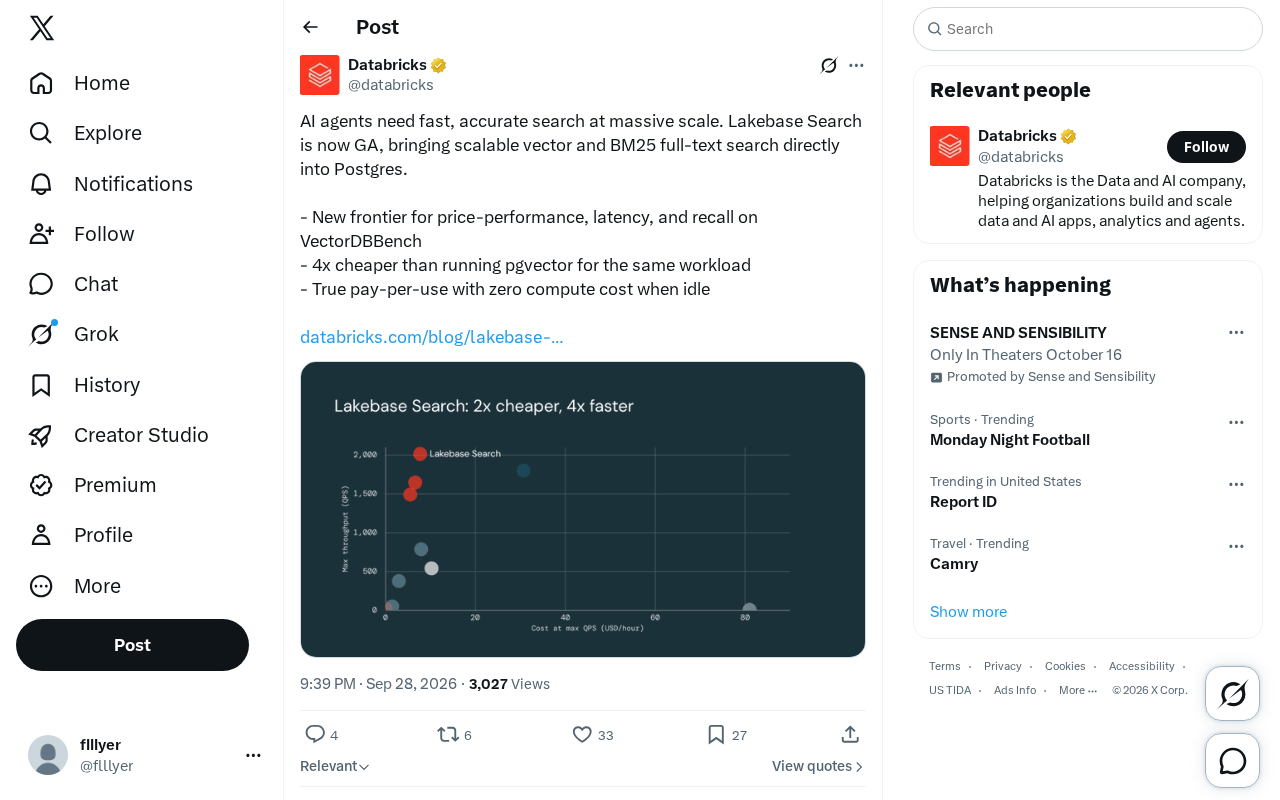
Lakebase Search 正式发布:Postgres 原生向量与全文检索
Databricks 的 Lakebase Search 正式 GA,将可扩展向量检索与 BM25 全文检索直接内建进 Postgres,官方称成本比 pgvector 便宜 4 倍并支持按量付费,为 AI 智能体提供大规模快速精准的检索能力。

Modal Labs逼近7.5亿美元融资 估值飙升至157.5亿美元
AI推理基础设施公司Modal Labs据报道接近完成约7.5亿美元融资,估值达157.5亿美元,较四个月前翻三倍。本文解析推理服务为何成为AI基建新战场及其行业意义。

NVIDIA DSX MaxLPS:如何榨干AI工厂的每一瓦性能
NVIDIA DSX MaxLPS 通过动态功率调度打破AI工厂按峰值供电的冗余困境,在既定电力预算下容纳更多GPU,最大化算力吞吐量与能效。本文解析其技术思路与经济价值。

AI数据中心是"猴子生意"?一场关于泡沫的争论
一则名为《AI Data Center Are Monkey Business》的视频引发对AI数据中心投资是否为泡沫的讨论。本文从资本开支、循环交易、能源折旧等角度剖析质疑逻辑,并提供理性判断维度。

