Agentic CUDA Kernel优化器:AI自动调优的新尝试
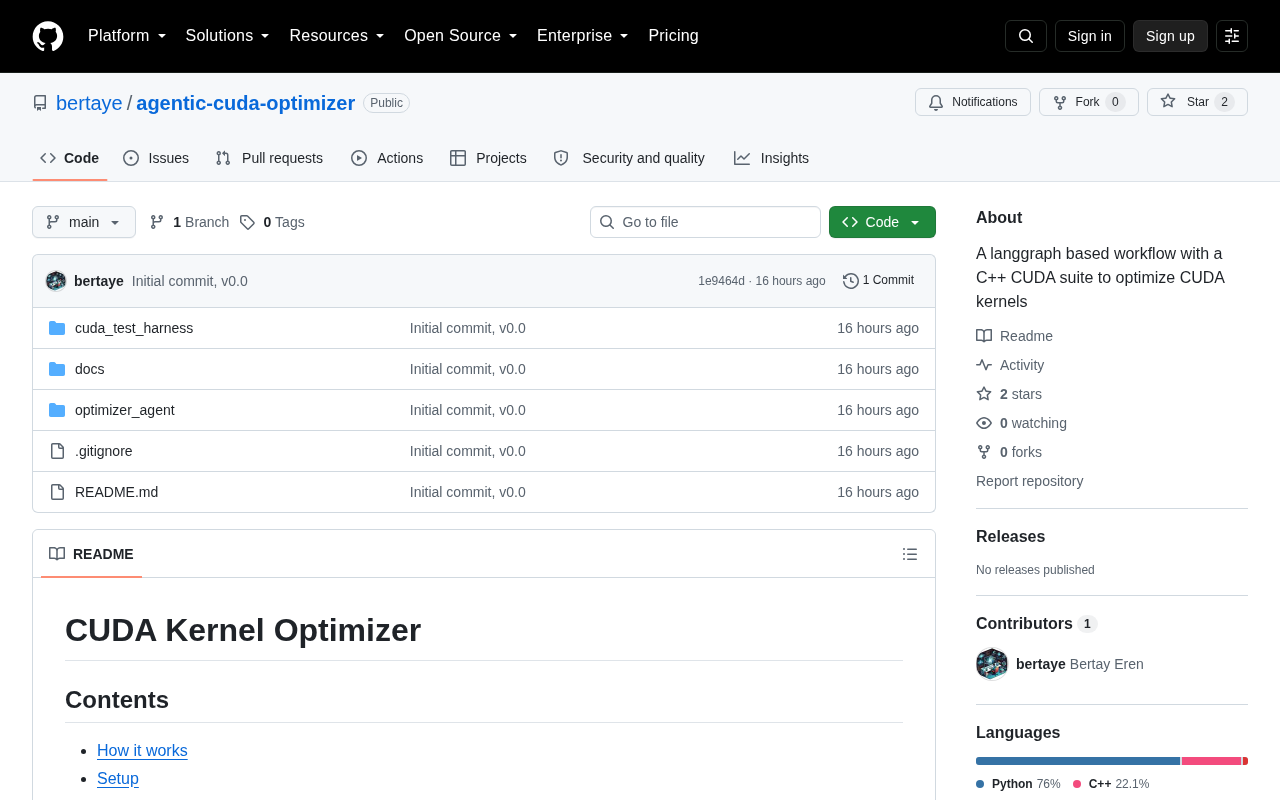
AI智能体自动迭代优化CUDA Kernel性能,让GPU底层调优从专家专属走向自动化。
Agentic CUDA Kernel Optimizer是一个尝试用AI智能体(Agent)替代人工完成GPU底层代码调优的开源项目。CUDA Kernel优化传统上需要工程师深入掌握GPU架构细节,反复经历「修改—编译—基准测试—再修改」的耗时循环。将大语言模型接入这一闭环,使其能够分析性能瓶颈、生成优化方案、自动编译并依据实测数据迭代决策,理论上可以大幅降低高性能GPU编程门槛。该场景还具备一个天然优势:执行速度是明确可量化的目标函数,能为Agent提供清晰的奖励信号。不过该项目目前仍处于早期展示阶段,缺乏实测加速比及与TVM、Triton等成熟框架的横向对比数据,实际生产价值尚待验证。
什么是Agentic CUDA Kernel优化器
近日,一个名为「Agentic CUDA Kernel Optimizer」的项目在Hacker News的Show HN板块亮相。顾名思义,这是一款尝试用AI智能体(Agent)自动优化CUDA内核(Kernel)性能的工具。虽然目前该项目在社区中的讨论尚处早期阶段(仅有少量关注、暂无评论),但它所触及的方向——让AI自动完成GPU底层代码调优——正是当下高性能计算与AI基础设施领域备受关注的痛点。
CUDA是NVIDIA推出的并行计算平台和编程模型,几乎是现代深度学习训练与推理的算力基石。而CUDA Kernel的手工优化,长期以来被视为一项高度专业且耗时的工程工作,需要工程师深入理解GPU硬件架构、内存层级、线程调度等诸多细节。将这一过程自动化,具有相当可观的实用价值。
CUDA Kernel是在GPU上并行执行的函数单元,由成千上万个线程同时运行。一个典型的深度学习模型在训练或推理时,会频繁调用矩阵乘法、卷积、归一化等算子,每个算子背后都对应一个或多个CUDA Kernel实现。Kernel的性能直接决定了整个模型的吞吐量与延迟。优化Kernel需要针对具体GPU架构(如A100的Ampere架构或H100的Hopper架构)调整计算访存比、利用Tensor Core等专用硬件单元,并规避线程束分歧(warp divergence)、内存bank冲突等常见性能陷阱。即便是经验丰富的GPU编程工程师,将一个朴素实现调优到接近硬件理论峰值,往往也需要数天乃至数周的反复实验。
为什么Kernel优化值得用Agent来做
CUDA Kernel的优化本质上是一个巨大的搜索与试错空间。工程师需要反复调整线程块大小、共享内存使用、循环展开策略、内存访问模式等参数,并在真实硬件上测量性能,才能逼近最优解。这个「修改—编译—基准测试—再修改」的循环,恰好非常契合Agent的工作范式。
所谓「Agentic」(智能体化)方法,指的是让大语言模型不只是一次性生成代码,而是具备规划、执行、观察反馈、迭代修正的闭环能力。在Kernel优化场景中,Agent可以:
- 分析现有Kernel代码,识别潜在性能瓶颈
- 生成候选优化方案并自动编译
- 运行基准测试收集实际性能数据
- 根据测量结果决定下一步优化方向
这种自主迭代的模式,理论上能够在无人干预的情况下逐步逼近专家级的优化效果,从而大幅降低高性能GPU编程的门槛。
这一方向的技术意义
将AI Agent应用于底层代码优化,是近年来一个颇具想象力的探索方向。相比通用的代码生成任务,Kernel优化有一个天然优势:它拥有明确、可量化的目标函数——执行速度。这意味着Agent的每一步决策都能获得客观的性能反馈,形成清晰的奖励信号,非常有利于自动化迭代与效果验证。
对于AI训练成本高企的当下,哪怕是Kernel层面几个百分点的性能提升,在大规模集群上累积起来也可能带来显著的成本节约。这也是为什么诸如自动Kernel生成、编译器优化、算子融合等课题持续吸引着学术界与工业界的投入。
现状与观察
需要客观指出的是,从目前公开的信息来看,该项目仍处于早期展示阶段。Hacker News上的帖子仅有7个点赞、尚无评论讨论,缺乏关于其具体实现细节、支持的硬件范围、实测加速比等关键数据。因此,对于它的实际效果,还难以做出充分评估。
对于关注该领域的开发者而言,这类Show HN项目的价值更多在于提供一个思路参照:它验证了「用Agent自动优化底层代码」这一命题正在被越来越多的独立开发者付诸实践。随着大模型编程能力的持续增强,可以预见未来会有更多针对特定优化场景的垂直Agent工具涌现。
值得持续关注的开源探索
这类工具若能开源并积累真实的性能基准数据,将对社区产生实质帮助。建议感兴趣的读者关注项目后续的迭代进展,尤其是它在真实工作负载下的加速表现,以及与手工优化、现有自动调优框架(如TVM、Triton等)的对比。这些数据才是判断一款Kernel优化工具是否具备生产价值的核心依据。
总体来看,Agentic CUDA Kernel Optimizer代表了AI辅助系统编程的一个前沿切口。尽管当前信息有限,但其所指向的自动化GPU性能优化方向,值得开发者与研究者保持长期关注。
TVM是由陈天奇等人主导开发的端到端深度学习编译器,能够将模型计算图编译到多种硬件后端,并通过AutoTVM或Ansor等自动调优模块搜索最优调度策略。Triton则是OpenAI开源的GPU编程语言与编译器,旨在以比CUDA更高的抽象层次编写高效Kernel,同时保留对关键性能参数的显式控制;PyTorch 2.0的torch.compile后端即大量采用Triton生成的Kernel。与这两个已在工业界广泛部署的框架相比,基于大语言模型的Agentic优化方法最大的差异在于:它不依赖预定义的搜索空间或调度模板,而是借助模型的代码理解与生成能力探索更开放的优化路径——这既是潜在优势,也是当前方法可靠性尚待验证的根源所在。
相关推荐
多轮对话攻破AI客服:没有恶意消息,护栏为何失效?
一次针对AI客服代理的红队测试发现:即使没有任何单条恶意消息,通过长达数十轮的缓慢对话,模型也会逐步偏离安全策略,而护栏从未触发。本文解析多轮对话越狱的机制与防御思路。
荷兰政府基于NixOS打造微软替代方案DAWO
荷兰政府推出基于NixOS的开源项目DAWO,试图替代微软办公与云生态,推进数字主权。本文解析其技术选型逻辑、摆脱供应商锁定的动因,以及社区对政府开源迁移的争议。
价格战烧到前沿模型:AI开发者本周必看动态
AI价格战首次蔓延至前沿旗舰模型层,顶级能力成本大幅下降。本文解读这一转折对开发者和构建者的成本结构、产品架构与行业竞争的深远影响。