Agentic RAG实战:从原理到代码,手把手搭建智能检索系统
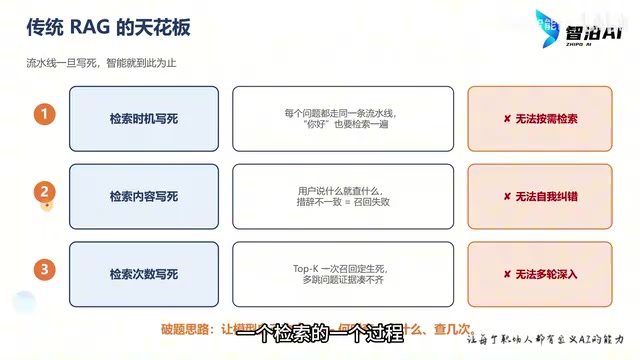
Agentic RAG把检索封装为工具交给大模型自主决策,破解传统RAG三大死穴。
文章基于B站教程拆解Agentic RAG的原理与实现。传统RAG的检索时机、内容、次数全部写死,模型无决策权,导致无效检索、答非所问和无法回答元问题。Agentic RAG将检索能力封装为模型可调用的工具,在判断阶段就引入大模型决策,实现按需检索、自我纠错与多跳查询。教程项目配备语义检索、查询目录、获取文件信息、精读原文四个工具,覆盖从粗筛到精读的完整链路;代码上通过装饰器注册工具、统一JSON返回值、设置最大轮数循环实现。作者也指出多轮调用带来延迟与Token成本,简单场景传统RAG仍更优,并给出工具单一职责、提示词约束格式等落地建议。
传统RAG系统常常陷入“答非所问”的困境——检索到的内容看似相关,注入模型后却毫无用处。更棘手的是,面对“知识库中有哪些文档”这类元问题,传统RAG直接摆烂,因为它只会机械地执行“问题→检索→拼接→生成”的固定流水线。B站UP主在最新教程中直指痛点:检索时机、检索内容、检索次数全部写死,模型毫无决策权。而Agentic RAG将检索能力封装成工具交给大模型,让模型自主决定何时查、查什么、查几次。本文基于该教程,拆解Agentic RAG的核心原理与完整代码实现,带你从零搭建一个能自我纠错、多跳查询的智能检索系统。
传统RAG的三大死穴
传统RAG的流水线架构在工程上简单直接,但UP主总结出三个无法回避的缺陷。
检索时机写死。用户无论问什么,哪怕只是一句“你好”,系统都会机械地走向量库检索一番。模型无法判断当前问题是否需要外部知识,导致大量无效检索和Token浪费。
检索内容写死。多数传统RAG直接用用户原始问题去查询,不做改写。用户表述与知识库文档之间存在语义鸿沟,检索精度大打折扣。更致命的是,模型只能被动接受检索结果,即便内容与问题无关,也只能硬着头皮生成答案,毫无自我纠错能力。
检索次数写死。每轮对话只有一次检索机会,召回K个片段后便草草收场。面对语义复杂的多跳问题,一次召回失败率极高,模型没有二次补救的机会。UP主在视频中强调:“修正这些缺点的方法很简单,就是让模型自己决定何时问、何时查、查几次。”
Agentic RAG的核心思想:检索即工具
Agentic RAG的本质变革在于将检索能力从流水线环节提升为模型可调用的工具。传统RAG中,模型只是流水线末端的“文本加工工人”;而在Agentic架构下,模型化身“指挥家”,通过多步推理自主编排工具调用。
据UP主分析,这种转变带来三个关键能力。按需检索:简单问题模型直接回答,复杂问题才触发检索。自我纠错:模型根据检索结果的质量决定是否改写查询词再次尝试。多跳查询:复杂问题被拆解为多个子查询,模型反复调用工具逐步逼近答案。
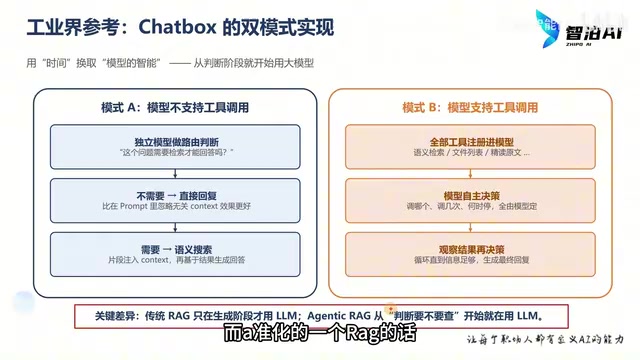
说个细节,传统RAG仅在生成阶段调用大模型,而Agentic RAG在判断阶段就已引入大模型决策。UP主对比了工业界两种实现模式:模式一由独立模型做路由判断是否需要检索,模式二则将知识库直接注册为工具,模型通过工具调用协议自主使用。后者支持更复杂的推理链路,也是本教程采用的方案。
当然,Agentic RAG并非没有代价。多轮模型调用带来更高的延迟和Token成本,UP主坦言这是“非常真实的代价”,因此工程上必须设置轮数上限兜底。对于公司员工手册问答这类简单场景,传统RAG的低延迟低成本反而更合适。
工具调用(Tool Calling / Function Calling)机制是理解Agentic RAG的技术基础。大语言模型本身只输出文本,无法直接执行检索。工具调用机制允许模型在生成时输出结构化的调用请求(通常为JSON,含工具名与参数),由外部程序代为执行,再将结果作为新消息回传给模型。模型据此继续推理,形成“思考—调用—观察”的循环。这也是ReAct(Reasoning + Acting)范式的工程化落地。模型经指令微调后能判断何时该调用哪个工具、参数如何填写,其依据正是工具函数签名与文档字符串——这也解释了后文为何强调工具说明和返回值格式必须规范。
**多跳查询(Multi-hop Query)**指答案无法从单一文本块直接获得、需要串联多个证据片段才能推理得出的问题。例如“LangChain的函数调用与Agent模块有何关系”,需先定位函数调用相关内容,再定位Agent相关内容,最后综合。传统RAG一次召回K个片段,若这些片段未同时覆盖各跳证据,模型只能凭残缺信息作答。Agentic RAG把每跳变成一次独立工具调用,模型每轮根据已获信息判断还缺什么、下一步查什么,从而把一次性的宽召回拆成多次精准召回,显著提升复杂问题的证据完整度。
四把工具打造Agentic RAG
教程项目为模型配备了四个工具,覆盖从粗筛到精读的完整检索链路。
语义检索工具是传统RAG功能的工具化封装,模型可反复调用并更换查询词,每次召回不同的文本块。查询目录工具分页列出知识库中所有文件和分块结构,让模型知道“库里有什么”——这是传统RAG永远答不上的问题。获取文件信息工具根据文件ID返回文件名和结构概要,模型在精读前先评估文档价值,避免盲目读取浪费Token。精读原文工具按文件ID和块ID直接读取指定片段,当语义检索结果不完整时,模型可借此获取前后文补齐证据。
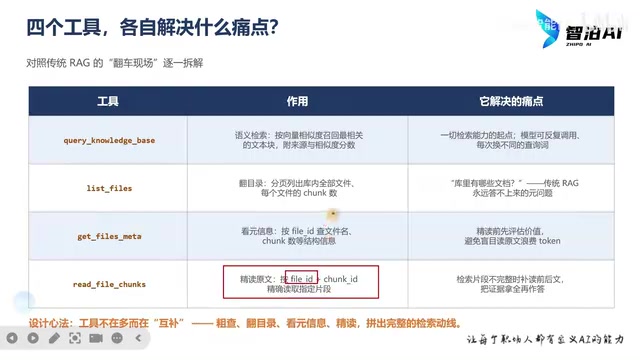
UP主在演示中展示了一轮典型调用:第一轮语义检索命中率低,模型推理后判断证据不足,改写查询词发起第二轮检索,命中率好转后第三轮调用精读工具补全细节。整个过程并非固定脚本,模型会根据需求灵活组合工具。
代码实现:从知识库构建到Agent循环
项目分为两个核心文件:知识库构建脚本和Agentic RAG主程序。
知识库构建沿用了传统RAG的离线链路。UP主使用文本分割器将文档切块,设置块大小与重叠区域,再调用阿里百炼广告的Text Embedding V3模型完成向量化,存入Chroma数据库。教程准备了四篇关于LangChain的文档作为示例数据。
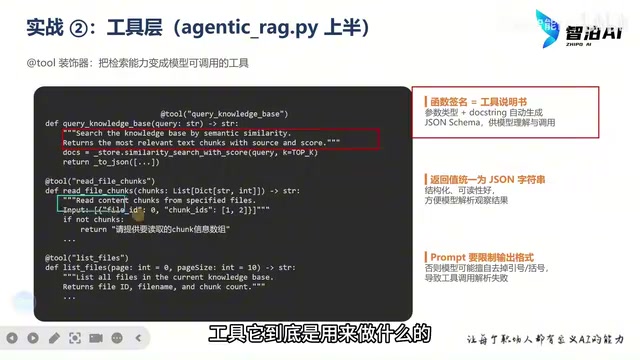
Agent主程序的上半部分定义工具层。四个Python函数通过装饰器注册为工具,函数签名和文档字符串就是给模型的“工具说明书”。UP主特别提醒,工具返回值必须统一为JSON字符串,保证结构化可读性。下半部分是Agent循环:初始化大语言模型,通过绑定工具方法挂载全部工具,设定系统提示词和用户提示词,然后进入带最大轮数限制的循环。每轮调用模型,若模型返回工具调用请求,系统代为执行并将结果回传;若模型直接给出回答,循环终止。
演示环节,UP主输入问题“LangChain中函数调用功能是如何实现的”。模型第一轮调用语义检索工具,第二轮便给出了完整回答,并严谨标注了内容来源。UP主提到,前一次运行同样的问题时模型用了三轮才完成——“这正是Agentic RAG的灵活之处,轮数不固定,按需伸缩。”
向量化与向量数据库是检索链路的底层支撑。文本分割器把长文档切成带重叠的块(chunk),每块经Embedding模型映射为高维向量,语义相近的文本在向量空间中距离更近。Chroma等向量数据库存储这些向量并建立近似最近邻索引,查询时把用户问题同样向量化,再召回距离最近的K个块。块大小与重叠区域的设置直接影响检索质量:块太大易稀释语义,太小则丢失上下文;重叠区域用于避免关键信息被切断。文中语义检索工具每次更换查询词即可召回不同块,正是因为不同查询向量在空间中指向不同邻近区域。
落地建议与边界
Agentic RAG不是传统RAG的全面替代。UP主给出的判断标准清晰:简单问答、低延迟要求的场景用传统RAG;知识密集、问题多变且复杂的场景才上Agentic RAG。工程实现时务必设置循环轮数上限,防止模型陷入死循环。工具设计要遵循“单一职责”原则,每个工具解决一类检索需求,让模型在规划时有清晰的选项边界。提示词中需明确输出格式约束,UP主指出智能性较弱的模型可能擅自增删内容导致工具调用失败,这部分需要额外加固。
相关推荐
Ollama+RAG本地知识库搭建实战:AnythingLLM喂饭教程
基于B站教程整理,详解Ollama+AnythingLLM搭建本地RAG知识库的完整流程:从通用大模型的知识局限、RAG检索增强生成原理,到文档上传、向量化入库与效果验证的实操步骤。

Ollama保姆级教程:本地免费跑大模型入门指南
Ollama是一款开源的本地大模型管理工具,支持免费下载部署DeepSeek等模型,提供命令行和Web UI,跨平台且能自动调度GPU/CPU资源,适合AI开发入门与私有化部署。
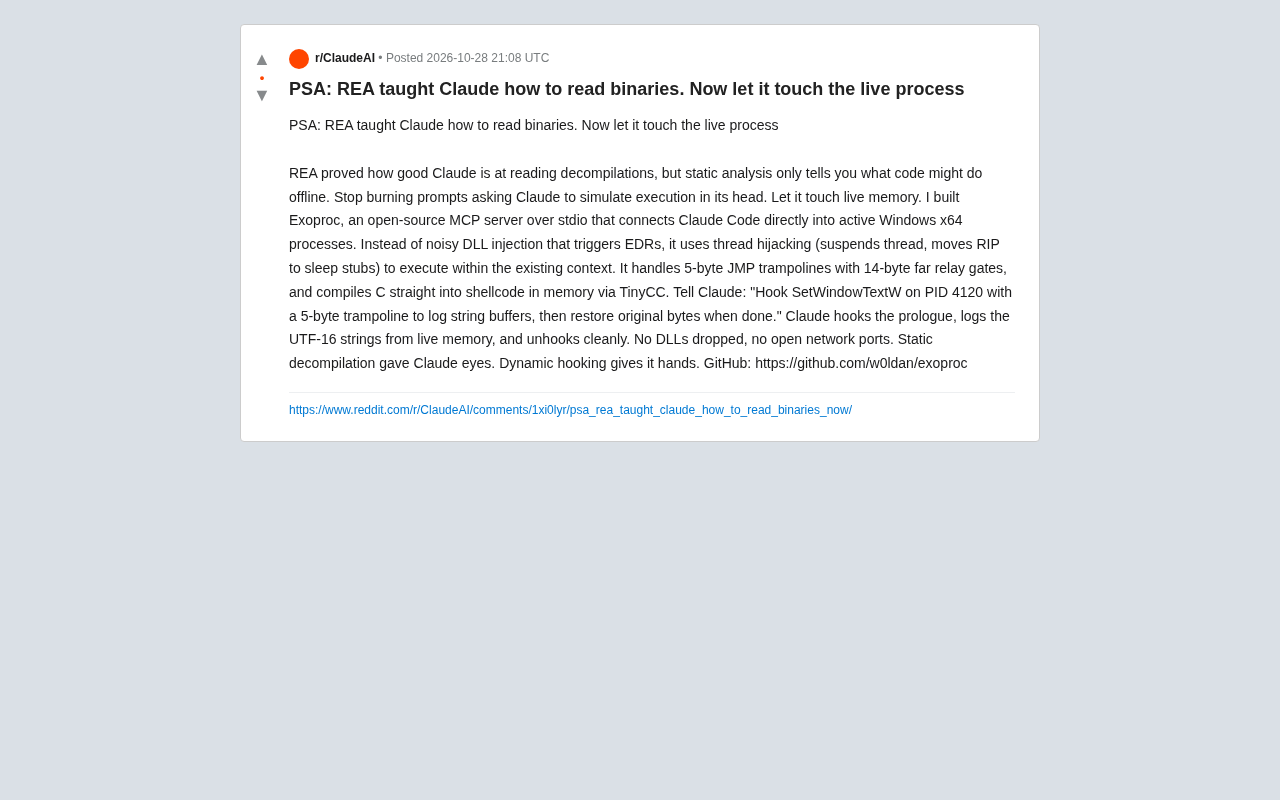
给Claude装上"手":Exoproc开源MCP服务器实现活体进程钩子
Exoproc是一个开源MCP服务器,让Claude Code通过线程劫持直接挂钩活跃Windows x64进程,绕过EDR实现动态分析。静态反编译给Claude眼睛,动态钩子给它双手。