AgentScope 2.0入门:智能体开发框架核心能力详解

AgentScope 2.0是一个面向生产环境的智能体工程化框架,覆盖ReAct构建、三层安全防线与上下文管理。
AgentScope是阿里开源的智能体开发框架,2.0版本相较1.0进行了颠覆性重构,已达到生产级别可用程度。文章围绕三个核心能力展开:第一,ReAct智能体——通过"推理→行动→观察"循环让Agent自主串联工具完成复杂任务;第二,三维一体安全防线——工具审查控制"能不能调用",人机协同保留人类对高风险操作的最终审批权,沙箱隔离确保代码在受控环境中执行;第三,系统性上下文管理——应对长任务中上下文持续膨胀导致关键信息被淹没的问题。整体思路是:Agent能力越强,自主性带来的风险和工程复杂度越高,AgentScope正是为此提供完整的工程化解决方案。新手建议直接学习2.0版本,框架同时支持Python和Java。
什么是AgentScope?从聊天机器人到智能体的跨越
理解AgentScope之前,先要分清一个关键概念:Agent(智能体)与普通聊天机器人到底有何不同。普通聊天机器人的职责很单纯——你问问题,它回答问题,仅此而已。而Agent不只是对话,它能够自主思考、调用工具、执行任务。
举个典型场景:你给Agent下达一个任务——分析今天的销售数据,生成报告,再以邮件形式发给公司经理。接到任务后,Agent会自己读取销售数据、调用Python分析功能、生成报告,最后调用邮件工具把结果发出去。整个过程它需要串联多个能力,自主完成一连串动作。
问题随之而来:当Agent能做的事情越来越多,开发者该如何构建它、控制它、保证它不乱来?出了问题又如何定位是哪一步出了错?这正是智能体开发框架要解决的核心问题,AgentScope就是其中一款。简单定义,AgentScope是一个帮助开发者构建、部署、管理、运行Agent的开发框架,本质上是用来管理Agent的工程化工具。
为什么直接学2.0而不是1.0
AgentScope此前推出过1.0版本,而2.0相较1.0做了大量重构,许多API已经弃用,改动幅度被珊珊老师形容为"毁灭级"。如果你曾学过1.0,再上手2.0会发现之前学的内容几乎白费。
结论很明确:新手不必从1.0开始,直接学2.0即可,因为2.0已经达到生产级别的可用程度。官方同时提供Python版和Java版两套文档,本课程以Python版本为主,Java开发者也可沿官方文档自学。文档支持中英文切换,自学能力强的开发者可以直接参照官网扩展知识。
核心能力一:ReAct智能体
AgentScope的第一个核心能力是ReAct智能体。注意这里的ReAct与前端框架React无关——它是**Reasoning(推理)与Action(行动)**两个单词开头字母的组合。
还是用天气的例子来理解:你让Agent查一下北京今天的天气,如果下雨就提醒你带伞。大模型本身并不知道北京今天下不下雨,所以Agent会先"思考"——要回答带不带伞,得先知道天气如何;然后"行动"——调用天气查询工具;拿到结果后再"思考"——发现有雨,应该提醒带伞;最终把答案返回给用户。
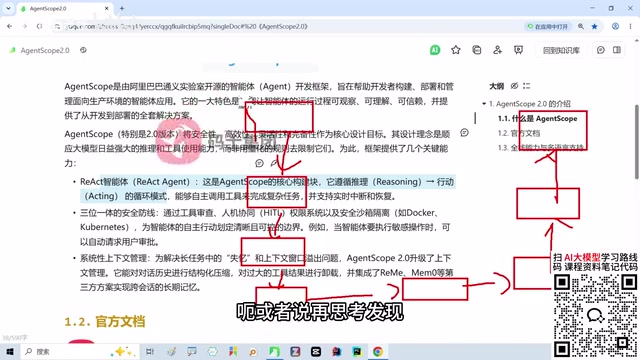
这种"思考—行动—观察结果—再思考"的循环就是ReAct模式。而且循环不是只执行一次,对于复杂任务它会反复迭代:调用工具、读取网页、执行Python代码分析数据,直到任务完成才返回最终结果。ReAct是AgentScope中非常核心的Agent构建方式,框架围绕它提供了工具调用、流式运行、中断恢复等能力,以适应复杂任务场景。
ReAct模式最早由谷歌研究团队在2022年的论文《ReAct: Synergizing Reasoning and Acting in Language Models》中提出。其核心洞察是:纯推理模型(如Chain-of-Thought)容易产生幻觉,因为它只在模型内部"想";纯行动模型又缺乏逻辑串联,容易盲目执行。ReAct将两者结合,形成"Thought → Action → Observation"的交替循环。每一次"Observation"是工具返回的真实外部信息,这些信息被写回上下文,让模型的下一步推理建立在真实数据上,从而有效抑制幻觉。在工程实现上,框架需要解析模型输出中的"行动指令",调度对应工具执行,再将结果注入上下文,这个调度机制正是AgentScope等框架的核心价值之一。
核心能力二:三维一体的安全防线
安全问题是随着Agent能力增强而凸显的。一个只会回答天气的Agent几乎没有安全风险,但当Agent拥有删除文件、执行代码、运行Shell、操作数据库、发邮件、调用公司内部系统等高权限时,你还敢让它完全自主运行吗?
设想一个场景:你让Agent清理项目里的无用文件,它判断某个文件没用就执行了rm -rf,结果删错了。Agent总会有出错概率,一旦判断失误,可能对生产环境造成致命影响。AgentScope为此设计了三道防线:
工具审查
不是所有工具都能随便调用。查天气这类普通工具可以直接执行,但如果某个工具会删除数据库内容,调用前就需要检查,以防万一。
人机协同
Agent可以自己干活,但关键步骤由人类说了算。当Agent准备执行DELETE FROM这类高风险操作时,会暂缓执行,交给管理员批准或拒绝。批准则继续,拒绝则停止或调整。这种方式不是不让Agent自主,而是在高风险动作上保留人类的最终解释权。
安全沙箱隔离
即便人机协同环节人类审批出错,还有最后一道防线。沙箱为Agent准备一个隔离的运行空间,让它在其中执行代码、处理文件,尽量不影响外部系统。这项机制在很多框架中都存在,比如deep agent也有类似设计。
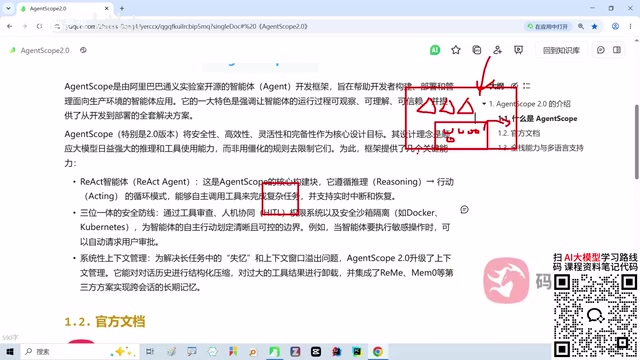
三道防线分工明确:工具审查解决"能不能做",人机协同解决"人让不让做",沙箱解决"在哪里安全地做",三者可以联合使用,应对更复杂的场景。
沙箱(Sandbox)是一种隔离执行环境的技术,其原理是限制进程的系统调用权限、文件访问路径和网络访问范围,使其无法影响宿主系统。在Agent场景中,沙箱通常基于容器化技术(如Docker)或操作系统级别的命名空间隔离实现。Agent在沙箱内执行的代码可以自由读写沙箱内的虚拟文件系统,但对宿主机的真实磁盘、数据库、网络接口则无直接访问权。一旦Agent的代码执行出错或产生破坏性操作,损害被限制在沙箱边界内,宿主环境不受影响。这种机制的代价是性能开销和配置复杂度,因此并非所有任务都需要启用,通常只在涉及代码执行、文件操作等高风险工具时才激活。
核心能力三:系统性上下文管理
设想一个Agent已经工作了两小时,中间搜索了20个网页、调用工具30次、读取了几十个文件。每次工具返回可能是五千字甚至一万字,上下文会不断累积、越来越大。
但大模型的上下文窗口并非无限,当上下文膨胀到一定程度,很多重要信息会被淹没。AgentScope因此提供系统性的上下文管理手段,这也是面向长任务场景的必备能力。
大模型的上下文窗口(Context Window)是指模型单次处理的最大文本长度,以Token数量衡量。主流模型的上下文窗口从数万到数十万Token不等,看似很大,但在长任务中仍会面临两个核心问题:一是超出窗口上限时早期信息被截断丢失;二是即便未超出上限,过长的上下文也会导致模型注意力分散,对早期关键信息的利用率显著下降——这一现象被称为"Lost in the Middle"效应。系统性上下文管理的常见策略包括:滑动窗口(保留最近N轮对话)、摘要压缩(将历史对话定期总结成简短摘要替换原文)、记忆检索(将历史信息存入向量数据库,按需检索相关片段),以及工具结果裁剪(对工具返回的超长内容只保留关键字段)。这些策略的核心目标一致:在有限的窗口内,让最相关的信息始终保持在模型的"注意力焦点"中。
总结:面向生产的Agent工程化框架
AgentScope的整体思路很清晰:当Agent能力越来越强、能自主完成复杂任务时,自主性也带来了安全风险和长上下文等一系列问题。AgentScope正是围绕这些问题,提供了一套完整的Agent工程化能力——从ReAct构建模式,到三维一体安全防线,再到系统性上下文管理,共同构成一个面向生产环境的智能应用开发框架。对于想系统学习Agent开发的开发者来说,直接从2.0版本切入是更高效的路径。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。