AI Agent 的浪费从哪来?模型调用还是编排层
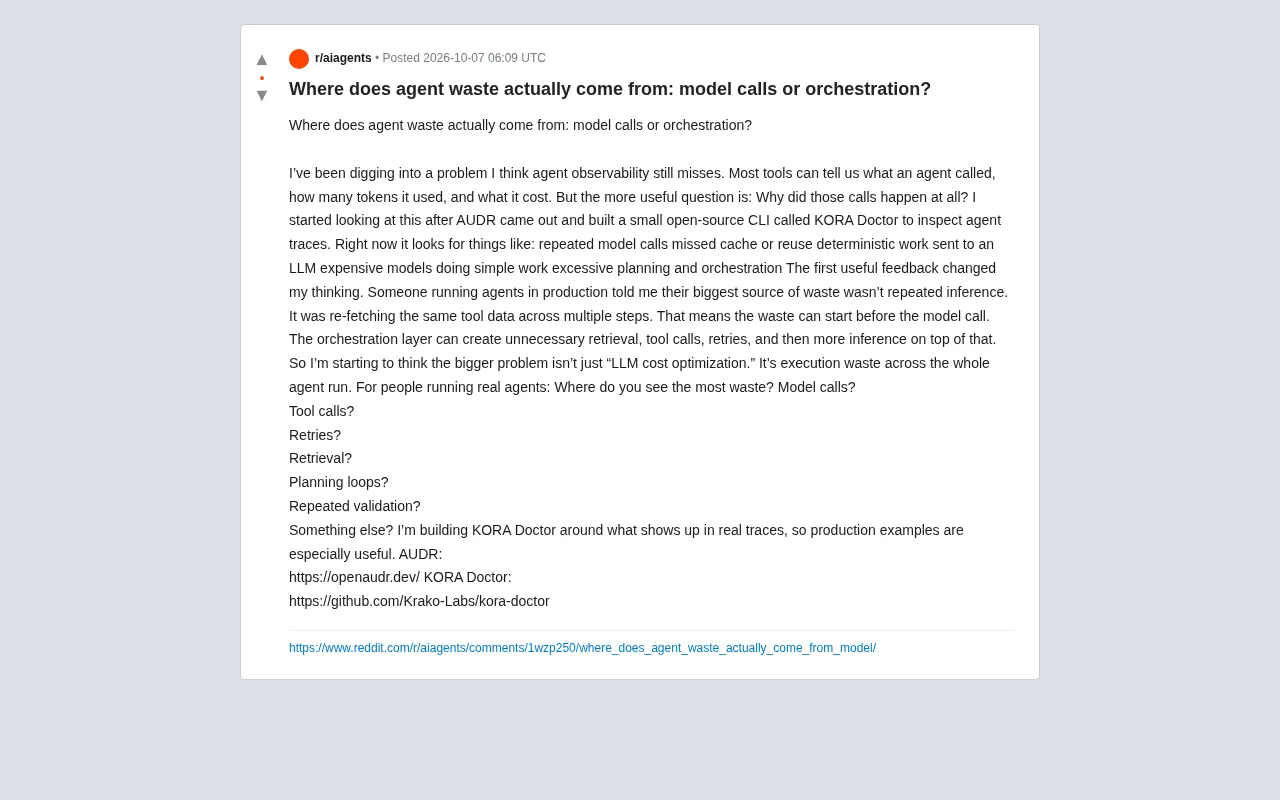
AI Agent的真实浪费不在LLM调用,而在编排层的冗余工具调用与重复数据抓取。
这篇文章围绕一个认知校正展开:当前大多数 Agent 可观测性工具只统计 token 消耗与推理成本,却无法回答"这次调用为何发生"这一更根本的问题。开发者构建的开源工具 KORA Doctor 通过分析真实执行轨迹(trace),专门检测重复调用、缓存缺失、大材小用等浪费模式。来自生产环境的关键反馈进一步揭示:最大的浪费往往不是重复推理,而是编排层在多个执行步骤间反复抓取相同工具数据——浪费在模型调用之前就已发生。文章由此主张将优化目标从"LLM成本"重新框定为覆盖检索、工具调用、重试和规划循环的"全链路执行成本",并呼吁构建生产级 Agent 的团队建立相应的全链路可观测性体系。
被忽视的问题:不是"调用了什么",而是"为什么调用"
当下大多数 AI Agent 的可观测性工具都能告诉你一件事:Agent 调用了哪些模型、消耗了多少 token、花了多少钱。但一位 Reddit 开发者在深入研究后提出了一个更本质的问题——这些调用究竟为什么会发生?
这个视角的转变很关键。知道成本只是结果,理解成本产生的根因才能真正优化。为此,这位开发者在 AUDR 发布之后,构建了一个名为 KORA Doctor 的开源 CLI 工具,专门用于检查 Agent 的执行轨迹(traces),试图从真实运行数据中找出浪费的源头。
KORA Doctor 在找什么样的浪费
KORA Doctor 目前的检测逻辑聚焦在几类典型的执行浪费上:
- 重复的模型调用:同样的推理被反复触发
- 缓存或复用缺失:本可以复用的结果被重新生成
- 确定性工作被交给 LLM:那些有固定答案、根本不需要大模型的任务也走了推理
- 大材小用:用昂贵的模型去做简单的事
- 过度的规划与编排:planning 循环消耗了大量不必要的资源
这套检测项的共同点在于,它们都不满足于"统计 token",而是尝试回答"这次调用是否本就不该发生"。这正是当前 Agent 可观测性工具普遍缺失的一层分析。
执行轨迹(Trace) 是理解这套检测逻辑的前提概念。在 Agent 系统中,trace 指的是一次完整任务执行过程中所有操作步骤的结构化记录,包括每次 LLM 调用的输入输出、工具调用的参数与返回值、中间推理状态以及时间戳与耗时信息。与传统应用的日志不同,Agent trace 需要捕捉的是非线性的、多跳的决策链条——同一个工具可能在一次任务中被调用多次,规划(planning)模块可能会反复修订目标。OpenTelemetry、LangSmith、Arize Phoenix 等工具已开始标准化 Agent trace 的采集方式,但分析层依然薄弱:大多数工具能可视化"发生了什么",却缺乏判断"这一步是否必要"的推理能力,而后者正是 KORA Doctor 试图填补的空白。
来自生产环境的反馈:浪费始于模型调用之前
真正改变作者思路的,是一条来自生产环境的反馈。一位在实际业务中运行 Agent 的用户告诉他:最大的浪费来源并不是重复推理,而是在多个执行步骤中反复抓取相同的工具数据(re-fetching tool data)。
这个发现很有启发性。它意味着浪费可能在模型调用之前就已经开始了。编排层(orchestration layer)本身会制造大量非必要的检索、工具调用和重试,而每一次多余的操作又会在其上叠加更多的推理成本。
换句话说,如果只盯着"LLM 成本优化",你很可能优化错了对象。真正的问题是贯穿整个 Agent 运行过程的执行浪费(execution waste),模型调用只是这条链条末端最显眼、但未必最昂贵的一环。
编排层(Orchestration Layer) 在多步 Agent 架构中扮演着"大脑之外的大脑"角色,负责决定何时调用哪个工具、如何传递上下文、失败时是否重试以及何时终止循环。常见的编排框架包括 LangGraph、AutoGen、CrewAI 和 Semantic Kernel 等。编排层的设计质量直接决定了整个 Agent 的效率上限:一个没有状态缓存机制的编排器,可能在同一次任务中多次向外部 API 请求完全相同的数据;一个缺乏终止条件判断的规划循环,可能在目标已达成后继续消耗资源进行验证。这类浪费发生在 LLM 推理之前,不会出现在 token 账单上,却实实在在地增加了延迟和工具调用费用,是全链路成本分析中最容易被忽略的一层。
重新理解 Agent 成本结构
这一观察把 Agent 成本从"推理成本"重新框定为"全链路执行成本"。一个典型的浪费链条可能是这样的:编排逻辑设计不当 → 重复触发工具调用与检索 → 返回冗余数据 → 再喂给 LLM 做重复处理 → 可能还伴随失败重试。在这个过程中,模型调用的费用只是最后被记账的那一笔,但驱动它的根因在更上游。
这也解释了为什么单纯的 token 统计无法指导优化——它只能看到"末端账单",看不到"上游决策"。要降低真实成本,需要审视的是编排层如何管理状态、缓存和数据复用。
开发者社区的开放提问
作者把这个工具明确定位为"围绕真实 trace 中暴露的问题来构建",因此在帖子中向运行真实 Agent 的从业者抛出了一个开放问题:你们见过的最大浪费来自哪里?
- 模型调用(Model calls)
- 工具调用(Tool calls)
- 重试(Retries)
- 检索(Retrieval)
- 规划循环(Planning loops)
- 重复校验(Repeated validation)
- 还是其他?
对于正在部署 Agent 的团队来说,这是一个值得对照自身系统反思的清单。相关资源包括 AUDR(openaudr.dev)与开源的 KORA Doctor(GitHub: Krako-Labs/kora-doctor),后者仍在根据生产案例持续演进。
结语
这篇讨论的价值不在于推荐某个工具,而在于它校正了一个认知偏差:Agent 的浪费不等于 LLM 成本。当越来越多系统从单次调用走向多步、带工具、带规划的复杂 Agent 时,真正的优化空间往往藏在编排层的冗余操作里,而不是单纯地换个更便宜的模型。对于构建生产级 Agent 的工程团队而言,建立覆盖检索、工具、重试和规划的全链路可观测性,可能比盯着 token 账单更有意义。
相关推荐
LZ4:极速压缩算法的开源标杆
探索 LZ4 极速压缩算法:了解其设计哲学、性能优势以及在 Linux 内核、数据库等领域的广泛应用。12k+ Star 的开源项目如何成为速度标杆。
Agent-Browser:AI智能体的浏览器自动化CLI
Vercel Labs 开源 agent-browser,一个用 Rust 构建、专为 AI 智能体设计的浏览器自动化 CLI 工具,GitHub 星标超 4.5 万,提供命令行优先的浏览器操控能力。
全球首家人形机器人公司Agility登陆纳斯达克,买不买?
Agility以全球首家人形机器人上市公司身份登陆纳斯达克,本文分析这一标志性事件对行业与投资者的意义,拆解纯人形机器人赛道的商业化考题与投资判断框架。