AI Agent 框架怎么选?七大主流框架生产级避坑指南

七大Agent框架逐一拆解:本地跑通≠生产就绪,护栏、持久化与观测闭环才是真正的生死线。
文章围绕「本地测试完美、上线即崩溃」这一Agent开发者的普遍痛点展开,指出根本原因是缺乏边界控制与护栏机制。作者对当前主流的七大Agent框架(LangChain、CrewAI、微软MAF、LlamaIndex Workflows、Google ADK、OpenAI Agents SDK、Mastra)逐一拆解,分析各自的适用场景与生产隐患——如Google ADK容器重启导致状态丢失、Mastra后台静默压缩推高API成本、OpenAI SDK缺乏持久化会持续烧token。文章的核心结论是:框架选型本质是工程约束问题,应按团队技术栈对号入座;而真正决定系统长期生存的,是以追踪-评估-改进-重启为核心的观测与评估闭环,框架本身只是编排层。
从本地跑通到线上崩溃:Agent 开发者的共同噩梦
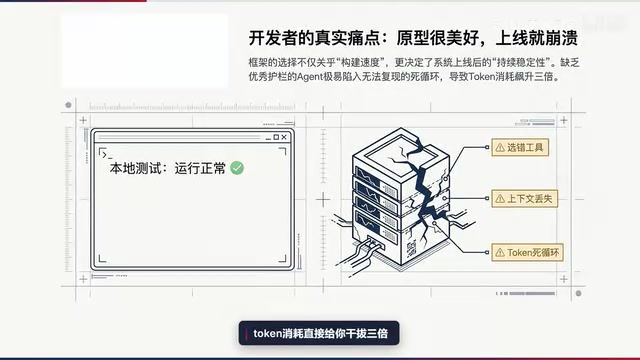
很多开发者都经历过这样的场景:屏幕上一片绿色对勾,本地测试一切正常,成就感满满。可一旦部署到服务器,系统分分钟原地崩溃——上下文莫名丢失、Agent 掉进死循环、token 消耗直接翻三倍。老板看到账单,怕是要请你去 office 喝茶。
这背后的根本原因,往往不是框架不够强,而是缺乏严格的边界控制与护栏。没有边界,Agent 就会在死循环里疯狂烧钱。这也是为什么一个「完美的本地原型」上线后会像漏风的钱包一样持续燃烧 token。
据 B 站硬核解析视频的分析,当前 Agent 框架赛道极度拥挤,从 LangChain 到 CrewAI 再到 Google ADK,堪称神仙打架。问题在于:这么多看起来高大上的新工具,到底哪个能真正达到「生产就绪」级别?
选框架前,先立一个硬标准
在被眼花缭乱的新名词绕晕之前,必须先想清楚评估维度。一个常见误区是:把「清晰的原语」和「真正的生产力」划等号。
这里要警惕过度抽象的陷阱。一旦抽象层掩盖了底层的故障模式,你调试排错的时间反而会远超当初节省的配置时间。真正的生产力,是框架能扎扎实实扛住真实负载、自带持久化执行能力,而不是靠你在外面东拼西凑挂一堆外部系统来兜底。
换句话说,评价一个 Agent 框架,核心要看它在真实流量、状态管理和故障恢复上的表现,而非它在 Demo 里跑得多漂亮。
七大主流框架逐一拆解
LangChain 生态:跨模型原型的全能选手
作为开源界的全能巨无霸,LangChain 是做跨模型原型的首选利器。但当系统开始变得复杂,需要引入 LangGraph 做多步循环和状态管理时,一定要小心管理庞杂的版本依赖,否则依赖冲突足以把人折磨到怀疑人生。
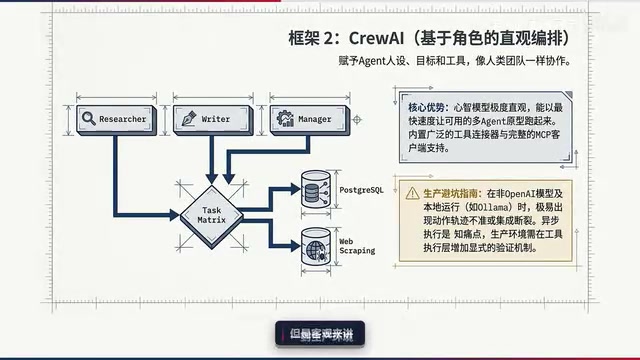
CrewAI:直观的角色映射
CrewAI 的设计思路很像开公司招人——给每个 Agent 分配角色和目标,快速跑通多 Agent 原型非常顺手。但客观来说,一旦进入生产环境,如果不用 OpenAI 而换成其他非本地模型,它的动作轨迹容易跑偏。上线前必须自己显式加上验证机制。
微软 MAF:生态大一统
MAF 是 AutoGen 和 Semantic Kernel 强强联手的融合体。如果团队重度绑定微软技术栈,它自带提示词注入防御等护栏,堪称梦中情框架。不过如果你用的不是 Azure 基础设施,可能得硬着头皮做痛苦的底层适配。
LlamaIndex Workflows:数据管道的霸主
这个框架相当硬核,直接抛弃 DSL,全部采用原生、事件驱动的方式。做文档密集型或数据处理管道时,它是当之无愧的霸主。代价是:一旦脱离 LlamaIndex 上游生态,就得手写海量样板代码,而且并发执行的已知缺陷有时相当折磨人。
事件驱动架构(Event-Driven Architecture)是 LlamaIndex Workflows 的核心设计哲学。与传统的顺序调用或 DSL(领域特定语言)编排不同,事件驱动模式下每个处理节点只响应特定类型的事件,节点之间通过异步消息传递解耦。这意味着文档解析、向量检索、摘要生成等步骤可以真正并行触发,而不是串行等待。但这种自由度也带来了调试复杂性——当并发执行出现竞态条件或事件丢失时,排查链路比传统同步调用困难得多。DSL 的缺失意味着没有可视化的流程图或声明式配置,开发者必须用纯 Python 手写所有状态流转逻辑,上手门槛和维护成本显著更高。
Google ADK:云原生开箱即用
GCP 原生、开箱即用、自带调试,听起来很爽。但避坑重点在于:如果部署在 Cloud Run 上,容器一旦重启,内存状态会瞬间蒸发。上线前若没配置外置持久化存储,就等于埋了个随时会炸的定时炸弹。
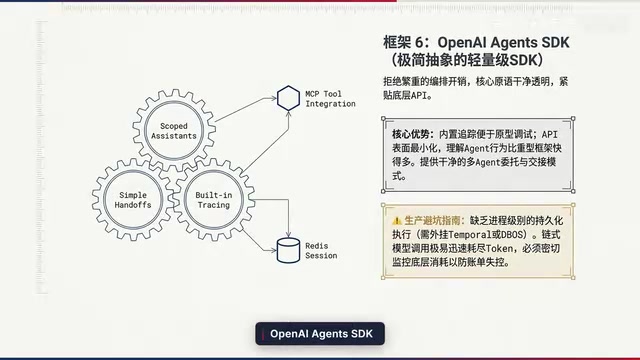
OpenAI Agents SDK:极简透明
它主打极简、干净、高度透明,让你对底层 API 一目了然。但如果缺乏进程级持久化执行工具(比如 Temporal),链式模型调用会像抽水机一样吸干 token 额度,必须死盯账单严防预算失控。
Temporal 是一个开源的工作流编排引擎,专门解决分布式系统中的进程级持久化执行问题。它的核心能力是「工作流即代码」——开发者用普通函数描述业务逻辑,Temporal 自动将执行状态持久化到存储后端,即使进程崩溃、服务器重启或网络中断,工作流也能从断点处精确恢复,而不是从头重跑。在 LLM Agent 场景下,这意味着一条需要调用十几次模型的长链任务,中途失败后不必重新消耗所有 token,极大降低了重试成本。缺乏类似持久化机制的框架,在网络抖动或服务器异常时会面临「任务丢失且账单已扣」的双重打击。
Mastra:TypeScript 团队的生产级权杖
为 TS 团队量身定制,前端连接器开箱即用,TS 体验是一等公民。但它有个隐秘的「刺客属性」:如果没用它的默认内存设置,一旦对话量增大,它会在后台悄悄触发模型压缩,API 成本会在暗处直线飙升。
决策矩阵:框架选型是工程约束问题
拆完七大框架,结论很清晰——工具再神,也得契合团队基因。可以按这份决策清单对号入座:
- 重度依赖微软:选 MAF
- 玩 GCP 云原生:选 Google ADK
- 前端 TS 团队:选 Mastra
- 天天搞数据处理:选 LlamaIndex
- 需要直观角色映射:选 CrewAI
- 喜欢极简底层控制:选 OpenAI Agents SDK
- 要做跨模型多面手:选 LangChain
框架选型本质上是一个工程约束问题,而不是比拼人气的选秀节目。只有基因对上,开发才能事半功倍。
真正决定生死的,是观测与评估闭环
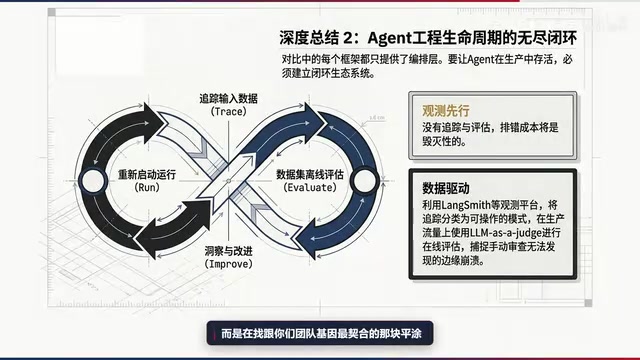
必须记住一点:无论选了多高大上的框架,它们本质上只是提供一个编排层。真正让 Agent 在残酷生产环境里活下来的,是一套严苛的工程闭环:
- 追踪输入数据
- 执行离线评估
- 提取洞察、改进边界情况
- 重新启动运行
这是一个永无止境的循环。在 Agent 开发里,观测必须先行。如果没有类似 LangSmith 这样的平台在背后追踪数据、用大模型做在线评估当裁判,当你面对海量且不可控的真实流量时,排错成本将是灾难级的。
最后一句硬核忠告:别再被本地完美的假象骗了,尽快拥抱 MCP 这类开放标准,把精力砸在流程编排和状态持久化上。没有这块稳固地基,一切都是空中楼阁。
你选择的框架决定了今天构建系统的速度,而你的观测与评估体系,决定了系统明天能走多远。
LangSmith 是 LangChain 团队推出的 LLM 应用可观测性平台,专门用于追踪、调试和评估基于大模型的应用。它能自动记录每次 LLM 调用的输入输出、延迟、token 消耗和中间推理链路,形成可回溯的完整追踪树。在 Agent 场景下,这一点尤为关键——当一个多步 Agent 出现幻觉或执行偏差时,LangSmith 可以精确定位是哪一步的 prompt、哪次工具调用出了问题,而不是只看到最终的错误输出。MCP(Model Context Protocol)则是 Anthropic 主导推进的开放协议标准,旨在统一 LLM 与外部工具、数据源之间的接口规范,让不同框架构建的 Agent 能通过标准协议互通工具调用,避免每个框架各造一套私有连接器的碎片化局面。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。