AI Agent 实战:从零打造带记忆的智能聊天助手

用Python与DeepSeek API构建具备跨会话长期记忆的AI聊天智能体,由模型自主判断信息的存取。
本文介绍了一个以「长期记忆机制」为核心的AI聊天智能体入门项目。大语言模型天生无状态、跨会话遗忘,该项目通过让模型自主判断何时写入、何时读取持久化记忆来解决这一痛点,而非依赖硬编码规则。技术栈涵盖Python后端、DeepSeek API、文件存储与原生HTML/CSS/JS前端,架构轻量、学习曲线平缓。实际运行时,左侧展示历史会话,右侧呈现模型生成的记忆内容,完整演示了「存→取→生成回复」的闭环。对于希望入门Agent工程开发、补齐简历深度的开发者,该项目提供了一个麻雀虽小、五脏俱全的实践范本。
为什么 Agent 需要记忆机制
大语言模型天生是「健忘」的——每次对话结束、页面刷新之后,上一轮的信息就会丢失。对于一个真正可用的 AI 智能体来说,这是致命短板。想象一下,你告诉助手某个项目的技术选型和关键决策,结果第二天它完全不记得,只能重新从头解释一遍,体验会大打折扣。
这也是本项目要解决的核心问题:给 AI 聊天智能体加上一套长期记忆(Memory)机制。它让模型能够在多轮、跨会话的场景下,自动判断哪些信息值得保存,并在需要时主动读取,从而实现真正意义上的「记住你说过的话」。
记忆机制是当前 Agent 开发中的关键组件之一。相比简单的对话历史拼接,本项目强调的是模型自主判断存储与读取,这更接近实际生产环境中智能体的工作方式。
从技术层面来看,大语言模型的「健忘」源于其无状态(stateless)的推理架构——每次调用 API 时,模型仅处理当前请求中传入的 token 序列,不保留任何跨请求的内部状态。目前主流的应对方式大致分为三类:一是将历史对话直接拼接进上下文窗口(Context Window),简单但受 token 上限约束;二是使用向量数据库(如 Pinecone、Chroma)将记忆编码为嵌入向量后检索,适合大规模语义搜索;三是让模型自主判断哪些信息值得写入持久化存储,再按需读取。本项目采用的是第三种思路,最接近人类「主动记忆」的认知模式,也是当前 LangChain、AutoGPT 等主流 Agent 框架中记忆模块的设计方向。
项目实现的核心思路
整个项目的记忆逻辑可以拆解为两个动作:写入与读取。
在对话过程中,如果用户提到诸如项目背景、技术要点、关键决定这类信息,模型会自行判断是否需要将其存储下来。这一步是「写入」,它不是无差别地记录所有内容,而是由模型评估信息的重要性后决定。
当用户新建会话或重新打开页面后,若再次提及相关内容,系统会触发「读取记忆」功能,调用内部方法把已存储的记忆取出来,与当前这句话一起发送给大模型。模型拿到完整上下文后,就能给出连贯、有记忆的回复。
简单来说,这套流程的关键在于:记忆的存与取都交由模型判断,而不是硬编码规则。这也是它比传统 session 缓存更「智能」的地方。
技术栈拆解
这个项目的技术选型非常适合入门者,覆盖了前后端全链路,同时又不至于过于复杂。
后端部分
- Python:作为项目主语言,负责核心逻辑
- Web 框架:搭建服务端接口,处理请求
- DeepSeek广告 API:调用大模型能力,完成对话与判断
- 文件读取:用于持久化存储记忆内容
前端部分
- HTML / CSS / JavaScript:构建交互页面
- 原生 Fetch 请求:负责前后端通信,不依赖额外框架
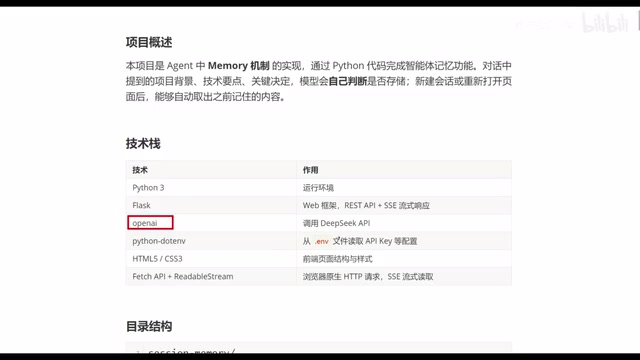
这套组合的好处在于:没有引入重型框架,学习曲线平缓,新手可以清晰地看到每一层是如何协作的。用文件读取来实现记忆存储,虽然不是生产级的向量数据库方案,但对于理解记忆机制的原理已经足够,也降低了环境配置门槛。
这里提到的「文件读取」用于持久化记忆,本质上是将模型提炼出的关键信息以文本形式写入本地文件(如 JSON 或纯文本),下次需要时再读出拼入提示词。这种方案与向量数据库的核心区别在于检索方式:文件存储通常是全量读取后交由模型筛选,而向量数据库则先通过语义相似度计算缩小候选集,再传给模型,在记忆条目量大时效率更高。对于入门项目而言,文件方案的优势显而易见——零额外依赖、调试透明、便于直接查看存储内容——是理解记忆机制原理的最低成本路径。DeepSeek API 在此承担两个角色:既作为对话生成引擎,也作为「记忆价值评估器」,判断当前对话片段是否值得持久化。
实际运行效果
打开浏览器页面后,界面被分为两栏:左侧是历史会话记录,右侧则展示实验效果——也就是大模型根据自身判断生成的长期记忆内容。
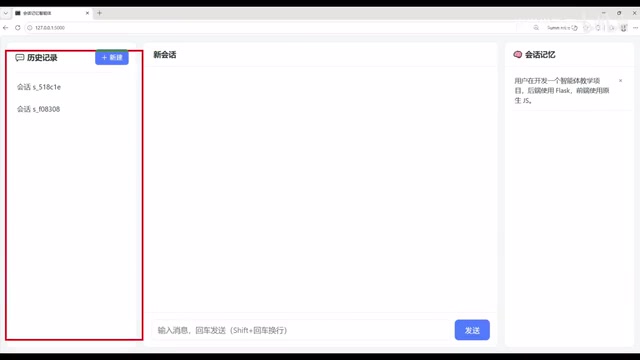
演示流程大致如下:先向智能体发送一句「你好」,等待模型回复;回复完成后,再提问它有哪些历史消息。此时页面会出现一个「读取记忆」的提示,说明系统正在调用内部方法取出已存储的记忆。
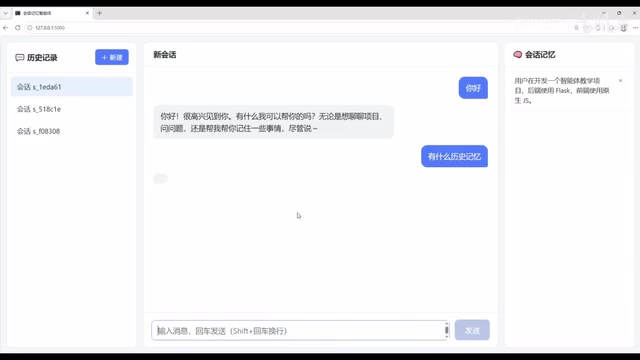
读取完成后,模型会把记忆内容和当前提问一起处理,最终给出对应的回复。整个过程直观地展示了记忆机制从「存」到「取」再到「生成回复」的完整闭环。
对开发者的价值
对于想入门 AI Agent 开发的人来说,这类项目的意义不仅在于跑通一个 Demo,更在于理解记忆机制的底层逻辑。
记忆是 Agent 从「一问一答的工具」进化为「有连续性的助手」的关键一步。掌握了「模型自主判断存储 + 按需读取」这套思路,后续无论是接入向量数据库、还是构建更复杂的多智能体系统,都能触类旁通。
从简历角度看,一个能跑通、逻辑清晰、覆盖前后端的完整 Agent 项目,确实比停留在调用 API 的层面更有说服力。它证明了你不仅会用大模型,还理解如何围绕模型构建工程能力。
向量数据库是进阶 Agent 记忆系统的核心基础设施。它将文本片段通过嵌入模型(Embedding Model)转化为高维向量,存储后可按语义相似度而非关键词进行检索——例如用户问「上次我们讨论的框架选型」,系统能定位到内容相关的历史记忆,而不依赖精确措辞匹配。常见方案包括本地可用的 Chroma、FAISS,以及云服务 Pinecone、Weaviate。理解了本项目「文件存储 + 全量读取」的基础逻辑之后,迁移到向量数据库只需替换存储与检索层,核心的「模型判断写入、按需触发读取」思路保持不变,学习曲线因此大幅降低。
小结
这个「带记忆的 AI 聊天智能体」项目虽然技术栈朴素,但麻雀虽小五脏俱全:Python 后端、DeepSeek API、文件存储、原生前端,配合模型自主判断的记忆读写逻辑,完整演示了 Agent 记忆机制的核心原理。对于希望动手实践、补齐 Agent 工程能力的开发者,是一个值得跟做的入门项目。
相关推荐

M&M's斥资数百万换掉人工蓝色素,为什么这么难?
玛氏公司投入数百万美元,试图用螺旋藻天然色素替代M&M豆中的人工蓝色素,却因物料浓稠堵塞管道、残留物引发霉菌风险而被迫改造整条产线。本文解析这场配方迁移背后的工程难题、消费者与监管推力,以及"无人工色素不等于健康"的清醒判断。

Meta全球AI开发者黑客松组队需求:计算机视觉与医疗AI方向
Reddit开发者发帖为Meta Global AI Developer Hackathon招募队友,方向聚焦计算机视觉与医疗AI。本文分析这一组队信号背后的赛道逻辑、技能互补需求与黑客松选题策略。

Claude 多个模型报错:Fable 5.1、Sonnet 5.5、Haiku 5.5 故障复盘
Claude Fable 5.1、Sonnet 5.5、Haiku 5.5 及 Opus 5.5 fast mode 出现错误率升高,官方 17 分钟内完成定位与恢复。本文梳理故障时间线、多模型连带故障的技术原因,以及对开发者重试与降级策略的实际启示。