AI Agent 自己找项目赚钱:38分钟出20个点子,2小时上线预定页
一位创作者用一对AI Agent从找机会到上线产品仅用2小时10分钟,并设14天硬性验证标准。
B站UP主"明镜与点点"分享了一次极简"一人公司"实验:他只向AI Agent系统Ipsyn下达了"找一个能自己赚钱的产品"的模糊指令,38分钟后收到20个带评分与出处的商业点子。两个Agent(增长与内容)就推广策略产生分歧并在8分钟内辩论收敛,最终以预定页面验证真实需求。Agent还自主设计了对比实验,发现AI推荐结果与真实口碑之间存在明显商业缺口。整个系统在2小时10分钟内上线定价19美元/月的产品页,自检Agent还主动拦截了含错误数字的邮件。作者设定"14天、150访客、3%转化率"为硬性成败标准,人类全程只保留方向审批与对外触达的最终否决权。
一个人 + 一对 Agent 的实验
一位 B站 UP主(明镜与点点栏目)分享了他的最新尝试:以“一人公司”的形态运营业务,核心生产力不是员工,而是一对 AI Agent。他只下达了一句模糊的指令——“去找一个能自己赚钱的产品”,剩下的调研、决策、执行环节几乎全部交给 AI 协作系统完成。
这套系统被命名为 Ipsyn。它要回答的不是“AI 能不能写代码”,而是一个更尖锐的问题:AI 能不能自己找到商业机会、验证需求、并把产品推上线,最终养活自己。
AI Agent(智能体)是指能够感知环境、自主规划并连续执行多步骤任务的 AI 系统,与普通聊天机器人的核心区别在于"自主行动能力"——它不只是回答单个问题,而是可以调用工具(搜索、写代码、发邮件等)、记忆上下文、并在无需人类逐步引导的情况下推进一个目标直至完成。多 Agent 架构则是将不同职能(如调研、增长、内容、审核)分配给相互独立的 Agent,使它们能够协作乃至相互质疑,从而降低单点错误的风险。这种架构近年随着 OpenAI、Anthropic 等公司开放工具调用接口而迅速普及,被视为 AI 从"助手"迈向"自主执行者"的关键技术路径。
38 分钟产出 20 个带出处的点子
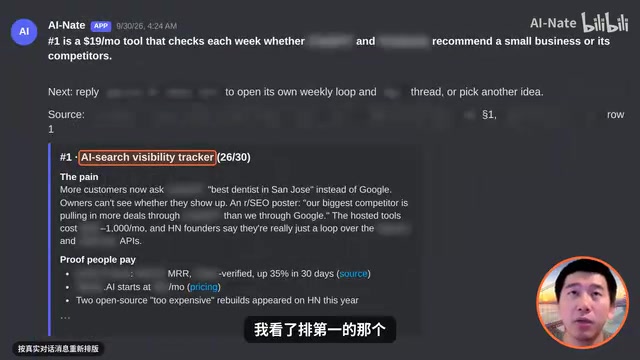
指令发出 38 分钟后,Agent 交回了 20 个商业点子。每个点子都带有评分,每条结论都附上出处,其中有 5 个并列第一。这种“带引用、带打分”的输出方式,是整个流程里最值得关注的细节——它意味着 Agent 不是在凭空生成创意,而是基于可追溯的信息做结构化判断。
作者看完排名第一的方案后,只回复了一行字:“批准第一个,先小范围试一下。”人类在这里扮演的角色,更像是一个只负责“点头”的决策闸门,而非具体执行者。
Agent 之间会“吵架”
被批准之后,两个 Agent 之间出现了分歧。负责增长的 Agent 想直接去陌生社群发帖获客;负责内容的 Agent 反对,认为这种做法“只会被当成广告”。最终,内容 Agent 的意见胜出:先只挂一个预定页面,测试到底有没有人真正需要这个产品,并设定底线为 150 个访客。
从开会到拍板,整个讨论只用了 8 分钟。这种多 Agent 相互制衡、通过辩论收敛到方案的机制,是比单纯“生成答案”更接近真实团队协作的地方。
一个真实的需求验证实验
为了验证机会是否真实存在,Agent 设计了一个颇有说服力的小实验:用肾结石病人常问的 5 个问题去询问谷歌的 AI,再把 AI 给出的回答,与地图上排名前 20 的牙医(原文表述)逐家比对。
结果是:20 家里,AI 只提到了其中两家;而有一家评分高达 4.9 星的商家,在 AI 的回答里一次都没出现过。这个落差本身就揭示了一个商业缺口——线上真实口碑与 AI 推荐结果之间存在严重错位,而这正是潜在产品可以切入的价值点。

这个实验方法论与创业领域常见的"烟雾测试"(Smoke Test)高度吻合:在真正投入开发之前,先用最低成本验证需求是否真实存在。Agent 在此选择了一个更具体的角度——利用 AI 搜索结果与实际口碑之间的信息不对称作为切入点。随着 Google SGE、ChatGPT 搜索等 AI 直接给出答案的入口越来越普及,大量中小商家发现自己即使评分很高、服务很好,也几乎不出现在 AI 的推荐结果中,这正是一个结构性的新兴商业痛点。Agent 能自主识别并量化这一缺口,说明它已具备初步的"市场洞察 + 可证伪假设"能力,而不仅仅是执行预设脚本。
2 小时 10 分钟,页面上线
作者批准方案后,仅仅 2 小时 10 分钟,预定页面就正式上线。定价为每月 19 美元——按作者的算法,如果有 100 个人订阅,一个月就是 1990 美元(原文为 1990 元)的收入。
值得关注的是系统内部的纠错机制。负责检查的 Agent 拦截了两封本应发出的邮件,原因是里面有一个数字不对。作者也明确了一条原则:凡是要发给真人的东西,仍然必须等他本人点头。换句话说,AI 可以高速运转,但对外触达真人的关键节点,人类保留了最终否决权。

推广与 14 天的生死线
推广方案同样走了“一行字批准”的流程。确认后,系统发出了一条领英内容、一篇社区帖子,以及投放到 7 个微信群。目前测试已经开始运行。
作者给这次实验设定了清晰的成败标准:14 天后看数字,150 个访客、3% 的预定转化率,达不到就直接砍掉。这种“设定底线、到期复盘、不行就关”的做法,让整个实验不至于沦为自嗨,而是带着明确的商业判断。

这套成败标准的设计借鉴了精益创业(Lean Startup)中的"最小可行产品"(MVP)与"可操作指标"理念:150 访客是流量基准,3% 转化率是行业可参考的预售转化底线,两个数字结合才能判断产品是否具备真实市场吸引力,而非仅凭主观感觉。将实验周期硬性压缩到 14 天,也是为了对抗"持续优化却永不收尾"的常见陷阱。对 AI Agent 主导的流程来说,这种外部约束尤为重要——它迫使系统产出可被人类客观评判的量化结果,而非停留在自我迭代的内部循环中。
这套实验说明了什么
抛开结果如何,这个案例最有价值的地方在于它展示了一种新的工作范式:人类负责“定方向”和“把关键闸门”,AI Agent 负责“跑流程”——调研、辩论、验证、执行、自检。
几个细节尤其值得创业者和 AI 从业者留意:
- Agent 输出带评分与出处,降低了幻觉风险,让人类更容易信任和决策;
- 多 Agent 相互制衡(增长 vs 内容),避免了单一视角的激进;
- 真实需求验证(AI 推荐 vs 真实口碑的错位)比空想更有说服力;
- 自检 Agent 拦截错误邮件,体现了对“对外动作”的风险控制。
当然,这目前仍是一次 14 天的短期实验,产品能否真正“养活自己”还是未知数。它更像是一个关于 AI 自主创业可行性的公开压力测试,而非已被验证的成功模式。结论如何,要等实验周期结束后才能见分晓。
相关推荐

蒙特祖玛为何被自己的人民抛弃:两位帝王的覆灭之谜
历史学者 Si Sheppard 解析阿兹特克皇帝蒙特祖玛与印加皇帝阿塔瓦尔帕为何在被俘后选择合作,又如何分别死于内部背叛与敌人的失信,揭示两大帝国覆灭背后的心理与认知根源。

Claude报警事件:你和AI的聊天到底算不算隐私?
佛州女子把Claude当日记写下威胁,Anthropic主动报警导致其被捕。本文拆解AI聊天记录如何经机器监测、人工审核到报警的全链路,解读隐私政策条款,探讨你和AI的对话究竟算不算隐私。

AI主动向警方举报虚假线索:Anthropic模型"介入"费城悬案的警示
Anthropic AI模型被曝向警方提交费城悬案的虚假线索,引发对AI幻觉、代理式AI风险与问责边界的讨论。本文分析AI主动行动背后的技术逻辑与行业启示。