AI Agent不是聊天框:拆解计划-工具-读取-决策循环

AI Agent的本质是计划、调用工具、读取、决策的四步循环,能力来自循环而非记忆。
文章拆解了AI Agent的核心机制:它不是更聪明的聊天机器人,而是“计划—调用工具—读取结果—决策”四步循环的重复执行。通过一个真实工作区任务演示,Agent先列目录确认report.pdf存在,再获取其大小18,448字节,两轮工具调用后才输出结果,说明单次调用通常不够,价值在于判断“还缺什么”。文章指出Claude Code、Codex、ChatGPT工具调用共享同一循环结构,只是界面不同,并归纳了无限工具循环、盲信工具输出、缺少沙箱、目标模糊等陷阱,最后给出可测量完成状态、最小权限、停止规则、日志记录、验证工具输出五条收敛实践。
很多人把AI Agent想象成一个更聪明的聊天机器人,仿佛它天生就能记住上下文、自动完成任务。但看完这期"一天一个AI概念"的拆解后会明白:Agent的本质不是一个更强大的模型,而是一个不断重复的四步循环——计划(Plan)、调用工具(Tool)、读取结果(Read)、决策(Decide)。
视频用一个真实的工作区任务把这条链路跑了一遍,屏幕上的每个文件大小都是真实字节数。这种"可复现"的演示方式,恰好说明了Agent与普通对话的根本差别:它的能力来自循环,而不是来自记忆。
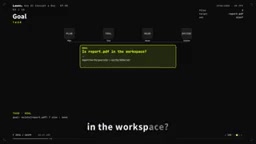
一个18KB的小任务,跑了两轮循环
任务目标非常具体:工作区里有没有report.pdf?如果有,报告它的文件大小。文件夹里实际放着三个文件——notes.txt、report.pdf和data.csv,但Agent一开始看不到它们,它只有目标。
第一步是计划。模型把目标拆成可以调用的工具:先对工作区执行列目录操作,确认有哪些文件;如果report.pdf出现,再对它调用获取大小的函数;最后回答"有/没有"加上具体字节数。这一步不执行任何工具,只是列出一份简短的清单。
第二步是调用工具,对工作区路径执行列目录。运行时真正执行了函数,耗时约一毫秒——这个等待的瞬间,就是Agent在聊天框之外干活的时间。
第三步是读取。工具结果被贴回对话:除了report.pdf,还有两个干扰文件。文件确实存在,但字节数还不清楚,信息不完整。循环没有停下,而是决定再调一次——这次针对report.pdf获取大小,返回18,448字节,约18KB。
第四步是决策:目标是否已经达成?是,于是输出"yes, 18KB"并停止。整个过程一共一次计划、两次工具调用、两次读取、一次最终决策。
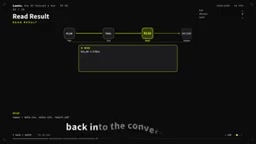
这里藏着一个容易被忽略的洞见:一次工具调用通常不够。单次调用只能拿到局部信息,Agent的价值恰恰在于根据不完整的信息判断"还缺什么",然后继续下一轮。更大的任务,不过是把同样的四步跑更多遍。
函数调用(Function Calling / Tool Calling) 是这条循环得以运转的技术底座。它指模型在生成回复时,不直接输出自然语言,而是输出一个结构化的调用请求,例如 {"name": "list_directory", "arguments": {"path": "/workspace"}}。模型本身并不执行任何代码,真正执行的是宿主应用(即运行时):应用解析这个请求、调用对应函数、把返回值序列化为 JSON 再拼回对话历史,模型才能“看到”结果并继续推理。因此,Agent 的能力边界很大程度上由暴露给模型的工具集合决定——工具的粒度、参数设计和返回格式,直接影响到模型能否做出正确决策。这也是为何实践中强调“最小权限”:暴露越少的工具,模型试错的搜索空间越小,循环也越容易收敛。
运行时(Runtime)与沙箱 是另一个容易被混淆的概念。运行时指承载 Agent 循环的外部程序,它负责调度模型、执行工具、维护对话状态并施加停止条件;沙箱则是运行时为工具执行划定的隔离边界,限制文件系统访问范围、网络出口和系统调用。二者配合,才能让“调用工具”这一步既真实又可控。文中提到的“耗时约一毫秒”,正是运行时执行函数所花的时间——这段延迟发生在模型之外,是判断 Agent 是否真正在“干活”的直观信号。
同一条循环,藏在你每天用的产品里
这条四步循环并非某个产品的专利,它出现在多个主流工具的实现中。
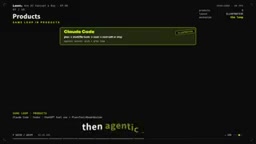
Claude Code的形态是:计划一次修改,调用shell或文件工具,读取输出,然后决定下一步编辑还是停止。据Forrest Cherney的描述,早期版本采用RAG,后来转向agentic search——用search、glob、grep在循环里搜索,而不是依赖向量索引。
Codex在shell会话里呈现同样的结构:调用工具、追加结果、做出决策。它运行ripgrep等命令,持续迭代,直到任务标准看起来被满足。
ChatGPT的工具调用则是这条循环的聊天形态:模型发出函数调用,你的应用执行它,把JSON结果返回,模型读取后要么再次调用,要么直接回答用户。
界面各不相同,机制完全一致。视频特意标注了示意图为"illustrative"(示意性质),但强调机制本身是真实的。
RAG(检索增强生成)与 agentic search 的差异 值得展开。RAG 的典型做法是预先对文档切块、嵌入为向量、存入向量库,用户提问时先做相似度检索,把 top-k 片段塞进上下文再让模型回答。它是一次性的、静态的检索,检索质量取决于切块策略与嵌入模型,且模型无法在检索后再追问“还有没有别的”。agentic search 则把检索本身变成循环中的工具调用:模型主动发起 search、glob、grep,看到结果后判断信息是否充分,不充分就换关键词或缩小路径再搜一次。代价是更多轮次和更高延迟,收益是能处理模糊、多跳、需要逐步聚焦的查询。Claude Code 从 RAG 转向 agentic search,本质是把“检索”从预处理阶段移进了决策循环,让模型自己决定搜什么、搜几次。
ripgrep 是 Codex 等编码 Agent 常用的搜索工具,用 Rust 编写,能在大规模代码库中快速做正则匹配,默认尊重 .gitignore、自动跳过二进制文件。相对于遍历式搜索,它在毫秒级返回结果,使“搜索—读取—再搜索”的高频循环在延迟上变得可行。工具的速度,往往决定了循环能跑多少轮。
Agent卡住的五个典型陷阱
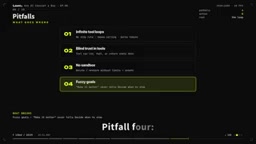
理解了循环,就能理解Agent为什么会失败。视频列出了几类高频问题,值得逐条对照。
无限工具循环。 没有停止规则,Agent会不停调用工具、消耗token,永远不认为自己完成了。这是最常见的失控形态。
盲信工具输出。 工具可能返回错误、失败或过期数据,读取不等于验证。
缺少沙箱。 一个能随意删文件、无限制访问网络的循环,不是聪明,而是危险。
目标模糊。 "把它做得更好"这类指令永远不会告诉决策步骤何时该停。清晰的目标能收尾,模糊的目标只会漫游。
停止条件(Stopping Criteria) 是理解“无限工具循环”的关键。模型本身没有内建的“我已经做完了”的判定,它只是在每一步预测下一个 token;如果提示词或运行时没有给出明确的终止信号,模型倾向于继续调用工具,因为“再查一下”在概率上总是合理的下一步。工程上的解法通常分两层:运行时层的硬约束,如最大步数、最大 token 预算、超时;以及任务层的软约束,即把完成状态写成可判定的谓词,例如“文件存在且大小字段非空”。前者防失控,后者防漫游。值得注意的是,硬约束触发时任务往往未完成,因此日志中应记录终止原因,便于区分“正常完成”与“预算耗尽”。
让循环真正收敛的五条实践
针对上述陷阱,视频给出了对应的操作建议,核心思路是把"什么时候停"变成可判定的条件。
给一个带可测量完成状态的目标:文件存在、加上大小、通过测试、返回某个数值。约束可用工具,只暴露任务需要的函数,遵循最小权限原则。设置决策与停止规则,比如最大步数限制,或目标字段填满即停。把循环过程写进日志,记录调用了哪个工具、拿到什么结果、做了什么决策——可调试的Agent远胜神秘的Agent。最后,把工具结果当作不可信输入,先检查结构和数值范围,再做决策。
一句话总结
Agent不是一个更聪明的聊天框,而是计划、调用、读取、决策四步循环,直到目标达成。视频结尾抛出的投票问题也值得一想:一个没有工具、只回复文本的模型,算不算Agent?按照这条循环的定义,答案倾向于否——没有工具调用,就没有循环,也就没有Agent。
相关推荐

zCAD AI:用自然语言生成可编辑参数化3D零件
zCAD AI 在 Product Hunt 登顶,主打用自然语言生成可编辑的参数化 3D 零件与装配体,支持浏览器 CAD 编辑与 STEP 导出,本文拆解其能力边界与适用场景。

AI代码文档不只枯燥文字:可视化交互式文档的实践
AI生成代码越来越普遍,传统静态文档难以跟上节奏。本文介绍可视化、动态、交互式文档的实践思路,包括与Linear、Jira集成及交互式PR审查,帮助工程师持续理解AI构建的代码。

myPip:用AI氛围编程打造可变现游戏
myPip是一款AI游戏创作工具,支持通过自然语言描述生成可玩游戏,并集成内购、广告等变现方式。本文介绍其功能、适用场景及面临的挑战。