AI Agent能力分级:用自动驾驶L1-L5看懂AI替你干活的边界
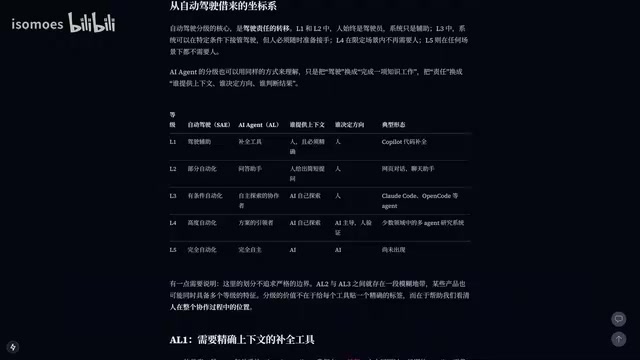
借用自动驾驶L0-L5框架,将AI编程工具从补全到多Agent协作划分为AIL1至AIL5五个能力级别,厘清人机协作的当前边界与未来冲击。
一位B站UP主将自动驾驶的L0-L5分级框架引入AI领域,提出AIL1到AIL5的能力坐标系,用以衡量AI自主程度与人类介入比例。AIL1对应Copilot式精确补全,AIL2是ChatGPT带来的自由对话,当前主流处于AIL3——Agent能自主探索执行路径,任务成功率已达70%-80%。但L3的天花板在于倾向复现训练数据中最常见的方案,创新性受限,领域专家通过提供针对性子方向才能释放AI潜力。AIL4意味着AI方案系统性超越人类,已在数学证明等窄域出现,但AI生成速度远超人类理解速度,带来知识可用性的深层矛盾。对就业冲击而言,L3主要替代新手可标准化的任务,L4普及将大幅压缩研究者数量,L5则意味着该领域不再需要人类参与。
自动驾驶用L0到L5描述了机器从辅助到全自动的能力光谱,如今这套分级框架被借用来理解AI Agent的进化阶段。一位B站UP主提出用「AIL1到AIL5」重新审视当下的AI编程工具与研究能力,把从Copilot补全到多Agent协作的技术路线,统一装进一个可对照的框架里。这种类比不只是概念游戏,它清晰地回答了一个现实问题:AI现在到底能替你干多少活,又在哪些环节仍然离不开人。
从Copilot到多Agent:技术路线需要一个统一坐标系
过去几年AI编程工具层出不穷——2021年GitHub Copilot的自动补全、后来Claude Code与OpenCode等Agent的登场、再到近几个月的多Agent动态工作流(Dynamic Workflow)以及Codex的并发模式。这些看似各自独立的技术方案,其实可以被放进同一条能力曲线上比较。
UP主的核心观点是:借用自动驾驶的L0-L5分级,能够把这些技术「廊阔起来」,看清每种技术究竟在哪个能力级别里起关键作用。这套框架的价值在于,它不纠缠于模型原理,而是从「AI能自主到什么程度、人需要介入多少」这个使用视角切入,更贴近开发者的日常体验。
AIL1到AIL2:从精确补全到自由对话
AIL1对应自动驾驶里的「辅助」级别,典型代表就是Copilot式的代码补全。它的特点是必须由人提供精确的上下文——你写好for循环的开头、给出明确的函数名和变量名,它才能补全相关片段。这类能力在十几年、二十几年前就已初具雏形。
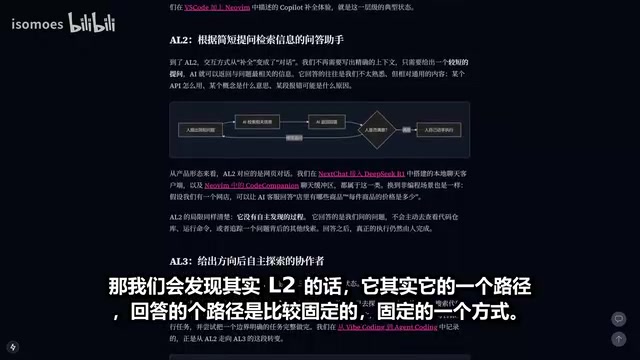
AIL2以2023年ChatGPT走红为标志。人给出简短的提示词,AI就能回答相关内容,甚至解答你不熟悉领域的通识性问题。刚出现时准确度有限,但后来幻觉率越来越低。当下主流的网页版AI聊天、电商客服机器人都停留在这一级别——它们的回答路径相对固定,是一问一答的模式,也不会主动去探索上下文。
AIL3:Agent Coding的自主探索与它的天花板
2025年被UP主视为Agent元年,OpenCode、Claude Code、Codex等项目相继落地,AIL3由此成型。与前一级最大的区别在于自主性明显增强:给定一个方向后,Agent能自己探索路径、调用已有工具,遇到工具缺失或修改出错时会主动调整策略,直到抵达目标。这就是从「vibe coding」到「agent coding」的跨越——人给方向,中间的执行路径交给Agent。
据这位UP主的实践观察,在人把任务边界(哪些能做、哪些不能做)和目标都描述清楚的前提下,用当前公开可用的最好模型,这类任务的成功率已经达到70%到80%以上,远不止50%。多Agent运行、动态工作流等手段的意义,正是让Agent能探索更多路径,从而更快更准地逼近目标。
但AIL3有一个关键局限。当只给一个大目标时,Agent在拆解子任务时会倾向于选择训练数据中最常见、最成熟的技术方案。对工程任务而言这是优点——稳妥可靠;但对研究性、探索性任务,这反而拉低了创新性,因为它走的永远是「最多人走过的那条路」,也就是最平庸的方案。
这引出了一个反直觉的结论:拥有AI,并不等于拥有AI的能力。普通用户只提一个宽泛的问题,得到的是AI在「均质状态」下的常规输出;只有领域专家能给出更有针对性的子方向和子目标,才能把AI的潜力真正释放出来,产出比别人更好的结果。所以在L3阶段,AI始终是「协作者」而非「leader」,方案由谁来提、由谁来定,仍然掌握在人手里。
「Vibe coding」是由OpenAI联合创始人Andrej Karpathy在2025年初提出的概念,指用户以自然语言描述意图、不关心底层代码实现细节,完全凭感觉(vibe)驱动AI生成代码的工作方式。它与「Agent coding」的关键区别在于执行主体的自主程度:vibe coding中用户仍需逐步确认AI的输出并提供下一步指令,本质上是增强版的问答;而agent coding中AI能自主制定执行计划、调用工具链、验证中间结果并循环修正,整个过程人只需在起点给出目标、在终点做验收。动态工作流(Dynamic Workflow)进一步扩展了这种自主性——与预先固定步骤的静态流程不同,Agent能在运行时根据当前状态动态决定下一步调用哪个子Agent或工具,使整体任务路径可以随上下文变化而实时调整,从而在搜索空间更大的任务上取得更高成功率。
AIL4:AI给出的方案比人更好
AIL4与L3的分水岭,在于方案的主导权发生了转移——AI给出的方案比人类能想到的所有方案都要好。最典型的例子是AI4Math领域的新闻:AI在一些千禧年级别的难题上取得推进,甚至写出人类都难以理解、难以自行完成的证明。这时AI的优势才真正凸显。
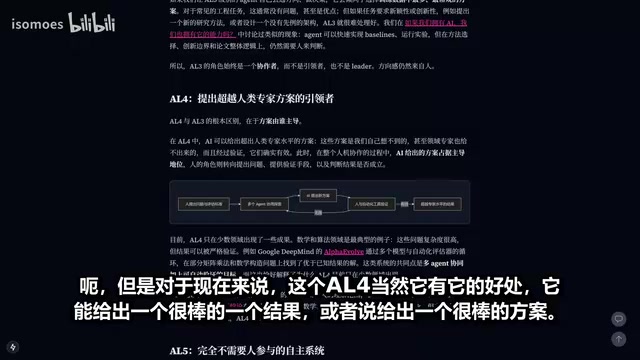
但AIL4目前只在少数领域、少数任务上实现,且门槛极高。它需要大量Agent并发运行,需要结果能被AI自我验证证明,从而形成完整的「探索—验证」闭环,前置约束众多,使用成本高昂。
更深层的矛盾在于:AI的生成速度已经远远超过人类的理解速度。L4产出的新方案,人类要转化成可传播的知识需要花费大量时间去梳理理解;有些内容甚至只有同样达到L4的AI才能接着使用,对人来说处于「不可用」状态。UP主提到,数学界近期已有声音呼吁放缓AI解题的步伐,理由是数学的更多价值在于产生人也能理解的知识,而非堆积人类难以消化的成果。
AI4Math(AI for Mathematics)是近年学术界与工业界共同关注的前沿方向,目标是让AI系统能够自主进行数学推理、猜想生成与定理证明。2024年前后,DeepMind的AlphaProof与AlphaGeometry系统在国际数学奥林匹克(IMO)级别的题目上取得显著进展;与此同时,也有研究团队宣称在部分希尔伯特问题(20世纪初由数学家希尔伯特提出的23个经典难题,其中多个至今未解)相关子问题上获得AI辅助推进。这类系统通常依赖「形式化证明验证器」(如Lean、Coq)作为自我验证的闭环工具——AI生成的证明步骤必须通过严格的形式化检验才算成立,这为AI4Math构建起可靠的「探索—验证」回路,也正是AIL4能在数学领域率先显现的结构性原因:结果的正确性可被机器自动判定,不依赖人类的主观评估。
AIL5与自进化:理想中的完全无人化
AIL5是这套分级的理想终点——整个系统的解决与维护完全剔除人的参与。与之相关的是当下颇火的「自进化」方向:AI能自主迭代自身,V1版本模型开发出V2,V2再开发V3,自己定位问题、修补问题。不过UP主坦言,目前还没有看到具有明显冲击性的相关事件或报道。
值得强调的是,从AIL1到AIL5的每一次跃迁,中间都会冒出新的问题,需要新的技术手段去解决。这不是一条平滑的直线。
分级背后的就业冲击:新手最先受影响
这套框架最现实的价值,是帮我们看清AI对不同人群的差异化冲击。
- AIL3阶段(当下):主要冲击刚入行的新手。对在某行业深耕十几二十年、有深厚知识储备的专家而言,L3只是「加速器」而非「替代者」。
- AIL2能力:新手日常能解决的任务大多停留在这里,而L2的成功率已经很高,这正是新手处境不友好的原因。
- AIL4普及后:如果AI给的方案能超过大部分专家,某个领域的研究者数量将大幅减少。
- AIL5全面实现后:那个领域就可以「不存在了」,完全不需要人参与。
UP主的结论略带感慨:日常大家能达到的一般是L3级别,而如果L4真的到来,「那个方向感觉基本上就完蛋了」。对想要入行某个领域的新手来说,当下的AI能力已经足够不友好;而提升自己驾驭L3的能力,或许是现阶段最务实的应对方式。
这种梯度冲击与劳动经济学中的「任务替代」框架高度吻合:技术替代的并非整个职业,而是职业中可被分解、可被标准化描述的具体任务。新手工程师或初级研究人员的工作内容,往往集中于执行明确规范的子任务——代码补全、文献检索、格式转换、常见错误排查——这些恰好是AIL2与AIL3已能高可靠完成的部分。而高级专家的核心价值在于问题定义、方案取舍与跨领域判断,这些能力目前仍需要大量隐性知识与领域经验支撑,短期内难以被当前AI替代。因此「提升自己驾驭L3的能力」在实践层面意味着:将自身工作重心从可被AI执行的标准化任务迁移至任务分解、方向判断与结果评估,也就是持续向「给AI提出好的子方向」这个角色靠拢。
结语
用自动驾驶的L1-L5来理解AI Agent,最大的启发不是「AI有多强」,而是让我们看清人机协作的边界正在哪一层移动。当前主流停留在L3——人给方向、AI执行,AI是强力的协作者但仍非决策者。真正的转折点在L4:一旦AI的方案系统性超越人类,整个领域的知识生产逻辑都会被改写。在那一天到来之前,能否给AI提出好的子方向,仍是拉开人与人差距的关键。
相关推荐
AI智能体信任危机:Markdown注入攻击已从实验室走向现实
安全研究者记录到一起在野Markdown注入攻击:恶意文档内容被AI智能体误判为可信指令,以完整凭证执行未经批准的工具调用。本文解析攻击机制、环境信任症结,以及生产环境中信任边界的防御思路。
开源鲁棒性测试框架SIRFEX:失败驱动的PPO重训为何拖累正常性能?
开源框架SIRFEX用失败场景微调PPO,却导致标称性能下降。本文解析其实验数据、负结果原因,并探讨鲁棒性提升与标称性能保持的平衡之道。
AI Gateway推出虚拟模型:集中管理模型配置,无需重新部署
AI Gateway 推出虚拟模型功能,用自定义模型 ID 集中管理模型选择与参数配置,支持编程 Agent 设置注入、供应商路由与零数据保留合规、花费归属标签,修改配置无需重新部署应用。