AI机器学习数学基础:四大核心知识与学习路径指南

引言:数学是AI/ML绕不开的基石
在Reddit的机器学习社区中,一个经久不衰的问题反复出现:"学习AI/ML到底需要多少数学?"、"某个视频教程能否覆盖AI所需的全部数学知识?"。这类问题背后,反映的是无数初学者在踏入人工智能领域时共同面临的困惑与焦虑。
本文将结合社区讨论,系统梳理AI/ML所需的数学知识体系,并给出一条切实可行的学习路径。无论你是准备转行的开发者,还是希望深入理解模型原理的从业者,都能从中找到方向。
AI/ML究竟需要哪些数学知识?
很多初学者误以为AI需要掌握高深的纯数学,实际上,AI/ML所依赖的数学更偏向"应用数学",主要集中在四大领域。值得一提的是,这四大领域之间并非孤立存在,而是高度交织——线性代数提供数据表达的语言,微积分驱动参数优化,概率统计建模不确定性,优化理论将三者整合为可执行的算法。理解它们之间的关联,比孤立学习每个分支更为重要。
线性代数:数据表达的核心语言
线性代数是机器学习中最核心的数学工具。神经网络中的每一层运算,本质上都是矩阵乘法与向量变换。你需要熟悉以下概念:
- 向量、矩阵及其运算
- 矩阵乘法、转置、求逆
- 特征值与特征向量
- 奇异值分解(SVD)
- 张量(Tensor)的基本概念
理解这些内容,能帮助你真正看懂PyTorch或TensorFlow中数据流动的本质,而不是把框架当作黑箱使用。
线性代数之所以在AI/ML中占据核心地位,是因为现代深度学习的所有计算本质上都可以归结为大规模的线性代数运算。例如,一个全连接神经网络的前向传播可以表示为 y = σ(Wx + b),其中W是权重矩阵,x是输入向量,b是偏置向量,σ是激活函数。GPU之所以能加速深度学习训练,正是因为GPU的架构天然适合并行执行大量矩阵运算——一块现代GPU可以同时执行数千次浮点乘加操作,这让原本需要数周的训练缩短到数小时。奇异值分解(SVD)不仅是理论工具,在推荐系统(如Netflix的协同过滤)、自然语言处理中的潜在语义分析(LSA)等场景中都有直接应用。而张量(Tensor)作为向量和矩阵的高维推广,是深度学习框架中数据存储与计算的基本单元——PyTorch和TensorFlow的名字本身就体现了张量的核心地位。
微积分:模型优化的核心引擎
模型训练的核心是"优化",而优化离不开微积分。反向传播算法(Backpropagation)本质上就是链式求导的大规模应用。关键知识点包括:
- 导数与偏导数
- 梯度(Gradient)与梯度下降
- 链式法则
- 多元函数的极值问题
当你理解了梯度下降如何一步步逼近损失函数的最小值,就能真正明白模型"学习"的含义。
反向传播算法(Backpropagation)由Rumelhart、Hinton和Williams在1986年正式推广,它本质上是微积分中链式法则在计算图上的高效应用。在一个包含数百万甚至数十亿参数的深度网络中,手动对每个参数计算偏导数几乎不可能,但通过计算图的反向遍历,可以在一次前向传播和一次反向传播中高效地计算所有参数的梯度。这就是所谓的自动微分(Automatic Differentiation)技术,PyTorch的autograd模块正是基于这一原理实现的。梯度下降的变体极为丰富:批量梯度下降(Batch GD)每次使用全部数据,计算精确但速度慢;随机梯度下降(SGD)每次只用一个样本,速度快但噪声大;小批量梯度下降(Mini-batch GD)是两者的折衷,也是实践中最常用的方式。理解这些变体之间的权衡,是从"会调API"到"懂训练"的关键跨越。
概率论与统计:不确定性的数学建模
机器学习本质上是在处理不确定性。从朴素贝叶斯到深度学习中的Dropout,从损失函数到生成模型,概率统计无处不在。需要掌握:
- 概率分布(正态分布、伯努利分布等)
- 贝叶斯定理
- 期望、方差与协方差
- 最大似然估计(MLE)
- 假设检验的基本思想
概率统计在AI/ML中的应用远比初学者想象的更加深入和广泛。贝叶斯定理不仅是朴素贝叶斯分类器的理论基础,更是整个贝叶斯深度学习(Bayesian Deep Learning)的基石——它允许模型不仅给出预测结果,还能量化预测的不确定性,这在医疗诊断、自动驾驶等高风险场景中至关重要。Dropout技术看似简单(训练时随机丢弃一部分神经元),但其背后有着严格的概率解释——Yarin Gal在2016年证明了Dropout训练等价于一种近似贝叶斯推断。当前最火热的生成式AI模型——扩散模型(Diffusion Models,如DALL-E、Stable Diffusion背后的技术)和变分自编码器(VAE),其核心理论框架完全建立在概率分布的变换和推断之上。而最大似然估计(MLE)则是训练绝大多数机器学习模型时所使用的参数估计方法,我们熟悉的交叉熵损失函数本质上就是负对数似然。
优化理论:连接数学理论与工程实践
在掌握微积分基础后,进一步了解凸优化、随机梯度下降(SGD)、动量法、Adam等优化算法,能让你在调参和模型设计时更有底气。
优化理论是连接数学理论与AI工程实践的桥梁。凸优化问题有全局最优解的保证,但深度学习面对的几乎都是非凸优化问题,这意味着存在大量局部极小值和鞍点。有趣的是,近年来的研究表明,在高维参数空间中,鞍点(梯度为零但既非极大也非极小的点)比局部极小值更常见,也更难以逃脱。Adam优化器(2014年由Kingma和Ba提出)通过同时维护梯度的一阶矩(均值)和二阶矩(未中心化方差)的指数移动平均,实现了自适应学习率调整,已成为深度学习中最广泛使用的优化器之一。此外,学习率调度(Learning Rate Scheduling)、梯度裁剪(Gradient Clipping)、权重衰减(Weight Decay)等常见的工程技巧,背后都有扎实的优化理论支撑。理解这些原理,能让从业者在模型训练不收敛时做出有针对性的诊断和调整,而非盲目试错。
看一个视频能学完AI所需的数学吗?
回到Reddit网友的原始提问:一个视频能否完成AI/ML所需的数学学习?
答案是:单个视频远远不够,但可以作为很好的起点。
视频教程的优势在于直观、易于入门,能帮你快速建立整体框架和直觉。但数学是一门需要"动手"的学科,仅仅观看而不做练习,知识很难真正内化。认知科学研究也表明,被动观看与主动练习在记忆留存率上存在巨大差距——被动学习的知识在24小时后可能只留存不到20%,而通过实践和教授他人,留存率可以提升到75%以上。社区中经验丰富的用户普遍建议:
-
视频用于建立直觉:优先选择像3Blue1Brown这样以可视化见长的资源,理解概念背后的几何意义。3Blue1Brown是由Grant Sanderson创办的数学教育YouTube频道,以其独特的可视化教学方式在全球数学和AI学习社区中享有极高声誉。其使用的动画引擎Manim(Mathematical Animation Engine)是Sanderson自行开发的开源工具,已被全球众多数学教育者采用。该频道的《线性代数的本质》系列通过几何直觉解释矩阵变换、特征值等概念,让抽象的代数运算变得可触可感——例如,它将矩阵乘法解释为空间的线性变换,将行列式解释为变换对面积/体积的缩放因子,这种直觉对于理解深度学习中的权重矩阵极有帮助。
-
配合系统性教材:如《Mathematics for Machine Learning》(免费开源)提供了完整而严谨的知识体系。这本书由Marc Peter Deisenroth、A. Aldo Faisal和Cheng Soon Ong合著,由剑桥大学出版社出版,全书PDF免费开放下载。该书的独特之处在于,它不是孤立地教授数学知识,而是始终以机器学习的应用为导向。全书分为两大部分:第一部分涵盖线性代数、解析几何、矩阵分解、向量微积分、概率与分布以及连续优化等基础数学工具;第二部分则展示如何将这些工具应用于线性回归、主成分分析(PCA)、高斯混合模型和支持向量机(SVM)等核心机器学习算法。这种"从数学到应用"的组织方式,特别适合有一定数学基础但希望建立数学与ML之间桥梁的学习者。
-
通过编程实践巩固:用NumPy手动实现矩阵运算、用Python实现一次梯度下降,比看十遍视频更有效。当你亲手用代码写出一个线性回归的梯度下降过程——初始化参数、计算预测值、求损失、计算梯度、更新参数——你会对整个数学流程产生完全不同于纯阅读的深刻理解。
推荐的AI数学学习路径
阶段一:建立数学直觉(1-2个月)
观看3Blue1Brown的《线性代数的本质》和《微积分的本质》系列,配合Khan Academy的基础课程,建立对核心概念的直观理解。这个阶段的目标不是严谨证明,而是在大脑中建立起"矩阵是空间变换"、"导数是瞬时变化率"、"梯度指向最快上升方向"等直觉性的心智模型。Khan Academy提供了从基础算术到线性代数、多元微积分和统计学的完整免费课程体系,其自适应练习系统能够根据你的掌握程度自动调节难度,非常适合查漏补缺。
阶段二:系统深入学习(2-3个月)
研读《Mathematics for Machine Learning》一书,或学习吴恩达的机器学习课程中的数学部分,系统补齐知识短板。吴恩达(Andrew Ng)是斯坦福大学教授、Google Brain联合创始人、Coursera联合创始人,他在Coursera上开设的机器学习课程自2012年上线以来已有超过数百万学习者注册,被广泛认为是AI/ML领域最经典的入门课程之一。他的课程特别擅长在数学推导和直觉解释之间取得平衡,对于数学基础薄弱的学习者尤为友好。在这个阶段,建议准备一个笔记本,亲手推导关键公式——比如从零推导逻辑回归的损失函数、推导反向传播中某一层的梯度更新规则,这些"笔头功夫"是建立深层理解的必经之路。
阶段三:项目实践应用(持续进行)
在实际项目中应用数学知识,遇到不懂的概念再回头查漏补缺。这种"以战代练"的方式,往往比孤立地学数学更高效,也更能保持学习动力。具体来说,你可以从以下项目入手:从零实现一个线性回归模型(涉及矩阵运算和梯度下降)、手写一个简单的两层神经网络(涉及反向传播和链式法则)、实现一个朴素贝叶斯文本分类器(涉及条件概率和贝叶斯定理)。每完成一个项目,你对相关数学概念的理解都会跃升一个层次。随着项目复杂度的提升,你自然会触及更高级的数学工具,形成良性的学习循环。
克服数学焦虑:一个重要的心态提醒
许多初学者陷入"数学焦虑",认为必须掌握全部数学才能开始学AI。这其实是一个误区。你不需要成为数学家,只需要成为能够理解和应用数学工具的工程师。
实际上,采用"自顶向下"的学习方式——先动手做项目,遇到不理解的数学再深入学习——往往比"自底向上"啃完所有数学再开始更符合大多数人的认知规律,也更容易坚持下去。这种方法在教育学中被称为"即时学习"(Just-in-Time Learning),其核心理念是:当知识有了明确的应用场景和使用动机时,学习效率和知识留存率都会显著提升。
值得注意的是,即使是AI领域的顶尖研究者,也并非在所有数学分支上都同样精通。许多优秀的机器学习工程师坦言,他们的数学知识是在多年的项目实践中逐步积累起来的。关键在于保持好奇心和学习的持续性,而不是追求一步到位的完美准备。正如Andrej Karpathy(前Tesla AI总监、OpenAI创始成员之一)所建议的:理解你在使用的东西,但不要让"完美主义"阻止你开始行动。
结语
AI/ML的数学学习是一场马拉松,而非短跑。单个视频可以是很好的起跑点,但真正的掌握来自于持续的学习、实践与思考。与其纠结"哪个视频最全",不如现在就打开一个教程,拿起纸笔,开始你的第一次矩阵运算。
对于Reddit上那位提问的网友,最好的建议或许是:先看那个视频,然后动手实践,缺什么再补什么。学习AI从来不是等万事俱备,而是在路上不断成长。数学能力与AI能力的提升是一个相互促进的螺旋上升过程——你学的每一点数学都会让你更好地理解模型,而每一次模型实践都会让你更深刻地理解数学。
相关推荐
LTX2.5开源本地部署实测:AMD显卡最低8G显存跑视频生成
开源视频生成模型 LTX2.5 本地部署实测:AMD 7900XTX 显卡在 Windows 11 环境下最低 8G 显存可运行,2 分钟生成 5 秒视频。附五套工作流对比与整合包、手动部署教程。
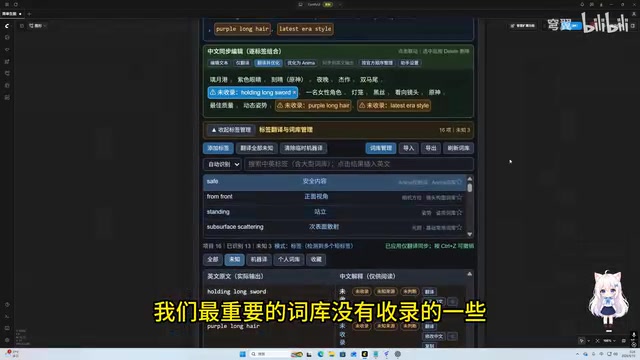
ComfyUI双语提示词节点实测:不懂英文也能玩转标签
一位B站UP主借助GPT打造的ComfyUI双语标签提示词拓展节点实测:中英标签双向联动、30万词库支持、未知标签一键翻译沉淀,让不懂英文的小白也能玩转提示词,目前适配anima本地部署模型。
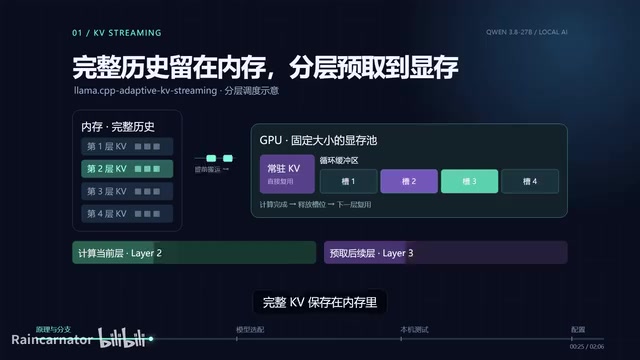
16G显存跑Qwen3 27B:192K上下文+视觉实测
在16G显存显卡上部署Qwen3 27B模型,通过llama.cpp Adaptive KV Streaming实现192K超长上下文与视觉能力。本文详解KV缓存瓶颈原理、量化版本选择及RTX 5080实测速度与任务能力。