AI-Native 时代:让大模型用 DFS 思维自己拆解需求
用DFS深度优先搜索让大模型逐层追问,以交互式树状对话替代一次性提示词,获得更精准的输出方案。
文章介绍了一种「AI-Native」的大模型使用思路:抛弃一次性写完所有需求的传统提示词方式,转而借用算法中的DFS(深度优先搜索)概念,用自然语言指令让模型充当主动追问者。具体做法是:模型从根需求出发生成四个问题分支,用户通过多选工具勾选相关选项、裁剪无关路径,再在保留的分支上继续追问,最多展开四层后收敛并输出方案。以「做自媒体月入两万」为例,模型通过逐层询问战略路径、时间投入、启动资金、已有资源等,最终生成比一句话提问精准得多的个性化方案。这套DFS提示词模板可迁移至Claude Code、TreeWalk等支持工具调用的Agent,但具体参数(四分支、四层)属于演示设定而非严格验证的最优值。
从传统提示词到 AI-Native 的思维转变
大多数人使用大模型时仍停留在传统思维里:写一大段详尽的提示词,把自己想让模型做的事情事无巨细地交代清楚。但受限于个人表达能力,很多时候我们根本写不出高质量的需求描述,只能一轮又一轮地反复修改,效率低下。
这位 B 站 UP 主提出的核心观点是:大模型比我们想象的更智能,我们应该抛弃过去的老思维,转向 AI-Native(原生) 的用法。所谓 AI-Native,类比云原生(Cloud Native)——很多能力是模型本身就具备、不需要我们额外开发程序去实现的。你只要用一句话调用,它就会用。
关键的转变在于:与其费尽心思一次性把需求写全,不如让大模型通过追问的方式替我们思考。你回答它抛出的问题,这些问答会不断堆积在上下文(context)中。当上下文积累的信息足够丰富时,模型最终生成的方案才会靠谱。信息不足时,模型的输出往往是「跑偏」的。
「云原生(Cloud Native)」最初是软件架构领域的概念,指专门为云计算环境设计、能充分利用云平台弹性与分布式能力的应用程序,而非把传统本地应用简单搬到云上。类比到大模型:AI-Native 意味着从一开始就围绕模型的原生能力来设计交互方式,而不是用操控传统软件的思维(写脚本、填表单、罗列规则)去「驯服」它。大模型原生就具备逻辑推理、结构化分析、问题分解等能力,调用这些能力只需一句自然语言指令,无需额外编程实现。这种思维转变的核心是:把模型当作「会思考的协作者」而非「听话的执行工具」。
DFS 深度优先搜索:让模型逐层追问
UP 主演示的核心方法是借用算法里的 DFS(深度优先搜索树) 概念。这里的 DFS 并不需要你去写代码实现,而是直接用自然语言告诉大模型:请用 DFS 的方式来分析我的需求。
整个流程的设计逻辑是这样的:
- 从根节点出发:针对你的原始需求,模型抛出四个问题分支
- 用户选择与裁剪:模型通过工具(如 multi-select 多选)弹窗让你勾选。你选中的分支保留,没选的直接裁剪掉——因为有些问题跟你真正的目标无关
- 逐层展开:每一层的问题都来自上一层的回答,你选一个分支它就在这个分支下继续追问四个新问题
- 收敛终止:最多展开四层后停止,此时上下文已经足够丰富
这套方法之所以有效,是因为一棵树随着填充会越来越丰富,你的上下文信息也随之越来越完整。相比一次性丢给模型一句话让它直接输出,这种交互式的树状追问能采集到更多信息,模型的判断也会更精准。
DFS(Depth-First Search,深度优先搜索)是计算机科学中经典的图/树遍历算法:从根节点出发,沿某条路径一直向深处探索,直到无法继续才回溯,再探索下一条路径。与之对应的是 BFS(广度优先搜索),后者先把同一层的所有节点都访问完再向下一层推进。在需求澄清场景中选择 DFS 的逻辑在于:用户一次只需关注当前分支,不会被所有可能性同时淹没;通过「选择保留、裁剪无关」的剪枝操作,对话会沿着最贴近用户真实目标的路径持续深入,最终到达足够具体的叶节点时,上下文信息已相当完整,模型可以据此生成有针对性的方案,而非泛泛而谈的通用建议。
实战演示:从「想做自媒体月入两万」到落地方案
UP 主用了一个很接地气的例子来演示:需求是「我想做自媒体,月入两万」。
如果直接把这句话丢给模型,它会一次性生成一堆「该怎么办」的通用建议——因为它是生成式模型,缺少你的个人信息,只能给泛泛而谈的答案。
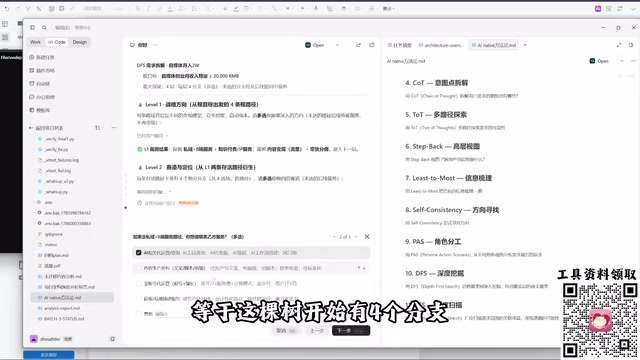
但加上 DFS 追问的前置指令后,模式就变了:
- 第一层:模型给出从根目标出发的四条战略路径(比如通过哪类自媒体切入),用户选择了「付费」相关的两条——例如私域加付费服务
- 第二层:从保留的两条路径各自衍生新问题,裁剪掉无关选项,用户再各留一个分支
- 第三层:模型细化到具体约束条件——每周投入时间(选「小于 10 小时」)、启动资金(选「大于 2 万」)、是否有账号、是否有专业技能等
- 收敛:最终跑完约定的层数,产出一个基于全程采集信息的具体方案(如抖音、小红书结合付费培训的路径)
这个过程的价值不在于方案本身,而在于方案是模型通过一连串针对性提问、结合你的真实回答后生成的,因此比只发一条指令要精准得多。
两种思路:写得详细 vs. 让模型替你问
UP 主最后总结了让大模型输出更准确方案的两条路径:
第一种是传统方式——在最开始就把需求写得极其详细:我没有账号、我想做私域加服务、每周只能投入多少时间……如果你有能力想清楚所有问题并一次性表达清楚,这条路也行得通。
第二种是「偷懒但更聪明」的方式——当你自己都想不清楚该考虑哪些问题时,就用追问的方式让大模型替你思考。它问、你答,这个过程会自动堆积起完整的上下文,最后再让它出方案。
值得关注的是,UP 主提到这套 DFS 指令模板可以直接复制到任何 Agent 上使用,无论是 Claude Code 还是他演示用的 TreeWalk,方法本身是通用的。文中还提到网上有一个类似思路的 skill 叫「BornMe」,同样是用追问积攒上下文的方式来提升输出质量。
方法论的意义与局限
这套 DFS/目标树的方法论,本质上是把结构化思考的责任部分转移给了大模型。它的巧妙之处在于把算法思维(深度优先搜索、树的剪枝)用自然语言「翻译」给模型,而模型天然就理解这些概念——这正是 AI-Native 能力的体现。
不过需要清醒看待的是,本次内容主要是单一来源的演示与经验分享,DFS 树的「四个分支、四层收敛」等具体参数更多是演示设定,并非严格验证的最优配置。其效果也高度依赖模型对工具调用(如 multi-select)的支持能力。对于想尝试的用户,建议把它当作一个可迁移的提示词框架,而非固定公式,根据自己的实际需求灵活调整分支数与层数。
工具调用(Tool Use / Function Calling)是指大模型在对话过程中能够调用外部预定义工具(如弹出多选框、执行搜索、写入文件等)并将结果纳入后续推理的能力。文中演示的 multi-select 多选弹窗就依赖这一机制——模型生成结构化的工具调用请求,前端或 Agent 框架据此渲染交互组件,用户的选择结果再以文本形式回传给模型。并非所有模型或平台都支持自定义工具调用;在不支持的环境中,同样的 DFS 逻辑可以退化为纯文本交互:让模型以编号列表形式提问,用户直接回复数字选择,效果会略逊但核心思路依然可用。
相关推荐

AI能直接读懂神经网络权重:模型能力已超出预期?
Reddit开发者实验显示,语言模型能直接阅读神经网络权重并推断其功能。Astra、Opus 5.5和Muse Spark 1.3均通过测试,引发对模型泛化能力与训练来源的讨论。

印度微短剧市场爆发:EloElo获NBCUniversal 8000万美元投资
印度社交娱乐平台EloElo获NBCUniversal 8000万美元投资,加码微短剧平台StoryTV。StoryTV月活超3300万,印度微短剧市场正吸引全球资本关注。

多旋翼无人机声学检测:融合手工特征与预训练嵌入
研究揭示无人机声学检测中随机划分导致数据泄漏,提出源不相交评估协议下融合手工声学特征与YAMNet嵌入的堆叠集成方法,准确率达95.29%,为低成本无人机探测提供可靠基准。