AI编程Agent最难的不是写代码,而是知道何时该动手

编程Agent最难的是判断何时动手、何时询问、何时不碰。
一位开发者在Reddit分享构建编程Agent的经验,指出真正耗心力的是让Agent"有分寸",而非提升模型聪明度。他将Agent的失败模式归为两类:过度热情造成变更扩散,畏首畏尾把决策成本推回人类,两者本质都是缺乏任务边界判断力。作者采用基于上下文的行动三分法——直接动手、主动询问、绝对不碰,并配合沙箱自检闭环、模型路由和多模态能力,让"动手"变得安全。该Agent在SWE-bench Verified上以官方harness取得82%得分,补丁公开、产品免费。作者认为行为约束与验证机制的组合比单纯提升benchmark分数更值得投入。
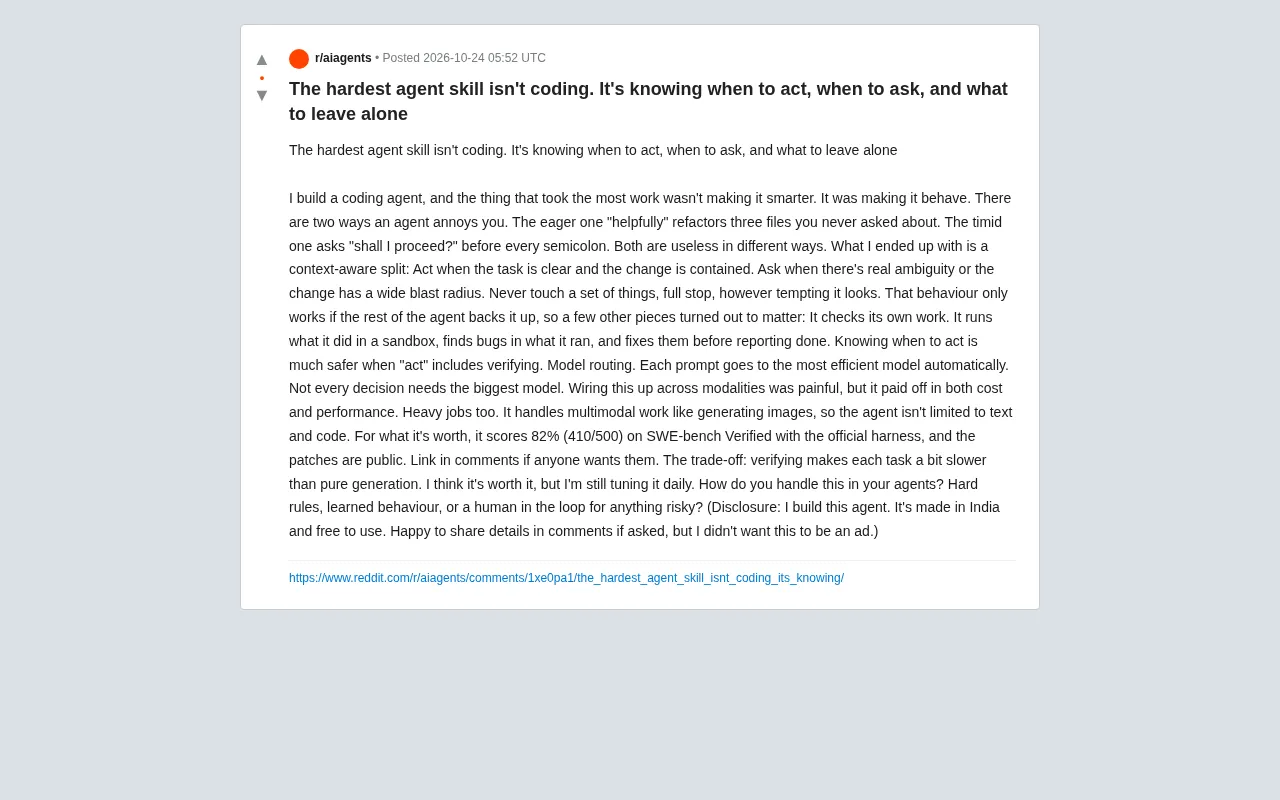
一位开发者在Reddit上分享了自己构建编程Agent的经验,结论出人意料:真正耗费心力的环节不是让模型更聪明,而是让它"有分寸"。这个观察戳中了很多Agent产品落地时的痛点——能力上去了,体验却崩了。
两种令人抓狂的Agent
作者把Agent的烦人方式归为两类。一类是"过度热情型":你只让它改一个函数,它顺手把三个你没提过的文件重构了一遍。另一类是"畏首畏尾型":每写一个分号都要问一句"可以继续吗"。
这两种表现看似相反,本质相同——Agent缺乏对任务边界的判断力。前者造成不可控的变更扩散,后者则把决策成本全部推回给人类。在真实开发流程里,两者都会让协作效率大打折扣。
上下文感知的三分法
作者最终采用的方案是一套基于上下文的行动分类:
- 直接动手:任务描述清晰、变更范围可控时,不打断用户
- 主动询问:存在实质性歧义,或改动的影响面较大时,先确认
- 绝对不碰:有一批东西无论看起来多"值得改",都不触碰
这套规则的价值在于它把"判断"从模型能力问题转化为策略设计问题。Agent不需要变得更聪明才能判断边界,而是需要一套明确的行动准则加上对上下文的准确评估。
让"动手"变得安全的配套机制
光有行为准则不够,作者强调几个支撑模块缺一不可。
自检闭环
Agent会在沙箱里运行自己的改动,发现bug后自行修复,然后才报告完成。这个设计让"直接动手"的风险大幅下降——因为"动手"的定义里已经包含了验证环节。代价是每个任务比纯生成慢一些,作者认为这个交换是划算的。
模型路由
每个请求自动分配给最合适的模型,不是所有决策都需要最大的那个。跨模态的路由集成过程相当痛苦,但在成本和性能两端都有回报。这其实是工程实践中容易被忽视的一环:用大模型做简单判断,既浪费钱也未必更准。
模型路由(Model Routing) 指在请求进入时,根据任务类型、难度、上下文长度或成本预算等信号,动态选择不同规模或专长的模型来处理。其依据是:简单判断用小模型即可完成,且延迟更低、成本更低;只有真正困难的推理才值得调用最强模型。工程上的难点在于路由判据的设计——判错会导致简单任务被过度消耗,或复杂任务被草率处理,因此常见做法是先用轻量分类器或规则打分,再配合回退机制。跨模态路由还需处理不同模型输入输出格式的差异,这也是作者称集成过程痛苦的原因。
多模态能力
Agent不止处理文本和代码,还能生成图像等多模态内容,扩展了适用场景。
SWE-bench Verified 是衡量编程 Agent 能力的主流基准之一。它从真实开源仓库的 issue 与对应 PR 中筛选出 500 个经过人工验证、描述清晰且可复现的样本,要求 Agent 在隔离环境中自主定位问题并生成补丁,最终以单元测试是否通过作为判定标准。由于题目来自真实工程场景、评分客观且防作弊设计较严,它常被用作编程 Agent 的横向对比基准。需要说明的是,得分高低受 harness(评测脚手架)影响较大,不同实现方式下的结果不一定可直接比较,因此作者特别注明使用了官方 harness,以保证结果的可对照性。
成绩与开放态度
作者提到该Agent在SWE-bench Verified上使用官方harness拿到82%(410/500),补丁公开可查。文末明确披露了自己的开发者身份,说明产品在印度开发、免费使用,同时表示不想把帖子写成广告。
值得玩味的是帖子结尾的提问:你们的Agent是怎么处理这个问题的——硬规则、学习行为,还是对高风险操作保留人工介入?这个问题本身说明,Agent的行为边界设计还没有公认答案。
为什么这个视角值得重视
当前关于Agent的讨论大多集中在能力上限:能不能完成更复杂的任务、能不能调用更多工具。但落到实际使用中,用户感知最强的往往是"它有没有在该停的时候停下来"。一个总在越界修改的Agent,能力再强也不敢放进生产环境;一个事事请示的Agent,则退化成了需要人盯着的高级自动补全。
作者的实践给出的启示是:Agent的可靠性来自行为约束与验证机制的组合,而不仅仅是模型本身的推理能力。对于正在构建Agent产品的团队,"何时动手、何时询问、何时不碰"这套判断逻辑,或许比再提升几个点的benchmark分数更值得投入。
相关推荐

别再往CLAUDE.md塞两万行:10个技能砍掉上下文成本
与其往CLAUDE.md塞两万行规则,不如用渐进式披露的技能体系。本文拆解10个Claude Code技能:Addy Osmani Agent Skills、Graphify语义知识图谱、Superpowers子代理编排、LSP插件等,教你削减token成本并提升代码质量。

苹果iPhone Duo折叠屏开箱:万元级新物种值不值?
苹果首款折叠屏iPhone Duo开箱上手:顶配近5000加元,哑光内屏成最大亮点,折痕控制出色,护照式宽矮比例引领新形态。本文梳理屏幕、铰链、手感和价格的完整体验。
开源智能体消息网络:让Claude Code与其他AI助手直接对话
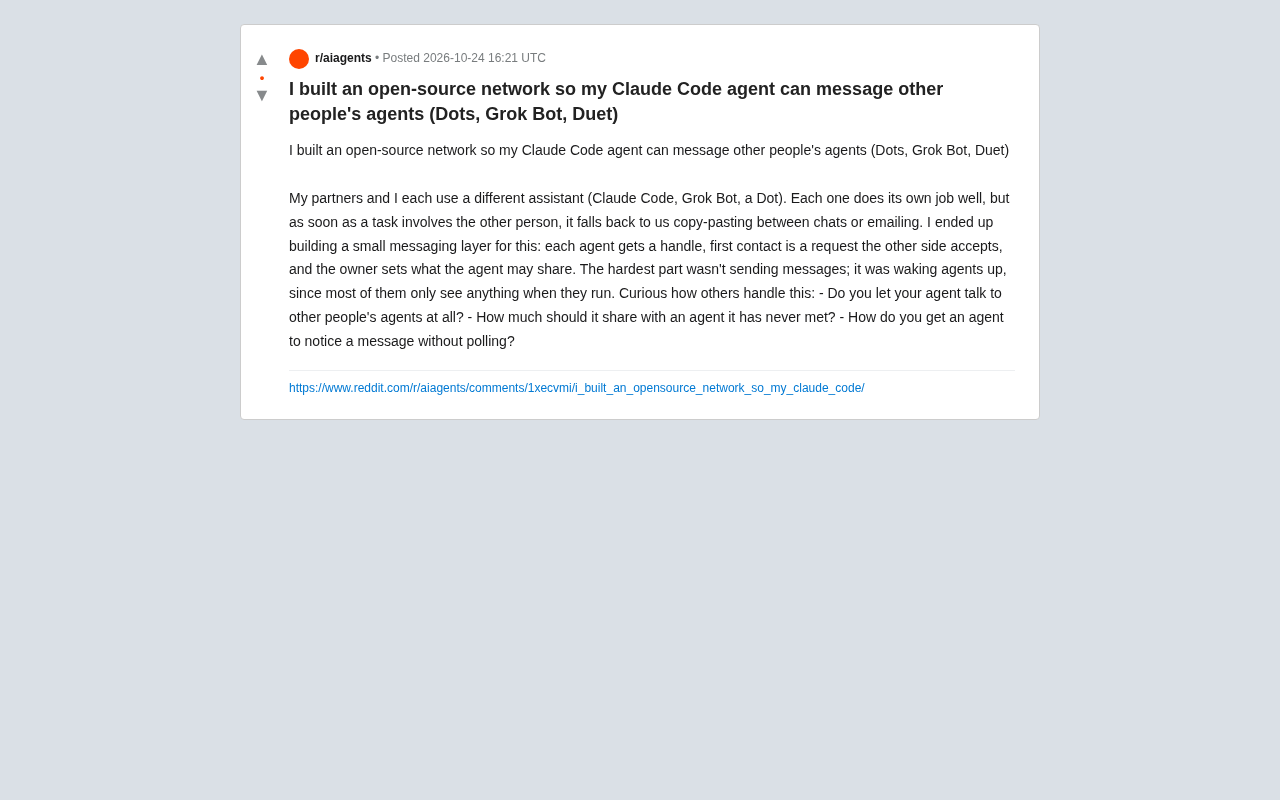
开发者构建开源消息层,让Claude Code、Grok Bot等AI智能体直接通信。项目采用句柄与握手机制控制权限,但唤醒休眠智能体成为最大技术挑战。探讨智能体互操作性的未来与信任边界。