AI编程token告急?混搭开源模型省下4倍成本实测
AI编程瓶颈已从模型能力转为token配额,「强模型规划、小模型实现」的分层策略可将成本压低75%。
随着Claude、GPT等前沿模型的速率限制持续收紧,AI编程的核心瓶颈已从「模型够不够聪明」转变为「还有多少token可用」。一位海外博主通过系统测试发现,在规划→实现→验证→评审的标准工作流中,规划环节对模型能力要求最高,而代码实现环节(最耗token)完全可以由更小、更便宜的开源模型承担。他的混搭方案——用GPT-6 Astra做规划和评审,用GLM 5.3 Flash写所有代码——成本仅为纯Claude方案的四分之一,但产出质量几乎持平,在多款应用上均得到验证。他通过开源工具Archon和Neon AI gateway搭建多模型协作工作流,并认为在额度日益紧张的现实下,探索开源模型已从可选项变为必修课。
前沿:AI编程的真正瓶颈已从能力变成token
一位海外AI编程博主最近发现,即便工作量没怎么增加,自己的Claude Code每月200美元Max套餐额度却比以往任何时候都更快耗尽——更糟的是,另一个200美元/月的Codex Pro订阅额度也几乎见底,两者要三四天后才能重置。他的结论是:这不是个人问题,而是整个行业趋势。
他指出,过去一整年速率限制(rate limit)都在恶化,如今已到了「单靠提升token使用效率也无济于事」的临界点。当团队开始进入 harness engineering、loop engineering、software factory 这类规模化的AI编程工作流时,产出的最大限制因素已经不再是模型能力,而是能花掉的token数量。
这也把「用开源模型省钱」从一项实验,变成了他日常工作流中不可或缺的核心环节。
速率限制(Rate Limit) 是API服务商对单个用户或账号在特定时间窗口内可消耗资源量设置的上限,通常以token数、请求次数或两者组合来衡量。对于Claude、GPT等前沿大模型,即便用户购买了月付订阅套餐,也会同时受到「总token配额」和「每分钟/每小时请求数」的双重约束。当工作流从「人工逐条提问」升级为自动化循环(loop)或多agent并发调用时,token消耗速度可达人工使用的数十倍,导致高价套餐在数天内耗尽。这也是为什么速率限制在 harness engineering 和 software factory 场景下会成为比模型能力更紧迫的瓶颈——工作流的吞吐量不再受「模型是否聪明」限制,而是受「还剩多少token可用」限制。
核心思路:贵的模型做规划,便宜的模型写代码
博主本周深入测试,围绕一个传统AI编程工作流的四个阶段——规划(planning)、实现(implementing)、验证(validating)、评审(reviewing)——寻找答案:哪里必须用最强的大模型,哪里可以换成更小、更快、更便宜的模型而质量几乎不掉。
他的核心发现是:规划步骤是整个工作流中最关键的一环。只要有一份写得足够好的计划,负责实现的模型即便能力平庸,也能得到接近最优的结果。而实现(写代码)恰恰是整个流程中最消耗token的部分——把这一步换成小模型,正是避免速率限制被快速击穿的关键。
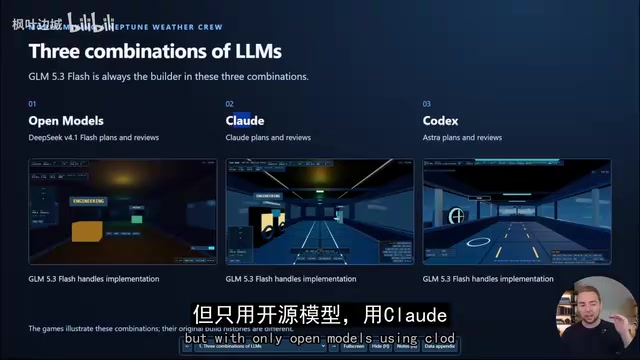
他把测试对象分成三大阵营,各取当前最强的一个:
- 开源模型:规划/评审用 DeepSeek广告 v4.1 Flash,实现用 GLM 5.3 Flash
- Claude:Fable 5.1 Max Effort
- Codex:GPT-6 Astra Max Effort
无论哪个组合,规律都一致——规划和评审用更强的模型,实现用更小的模型。
他目前最偏爱的组合是:用 GPT-6 Astra 做规划和评审,用 GLM 5.3 Flash 做又快又便宜的实现。这套组合已经是他 software factory 中所有工作的默认流程。
实测:三个版本的同款游戏对比
为了直观呈现结果,博主用同一份需求文档(PRD),跑出了三个版本的「海王星风暴追逐游戏」(多人在线、可分工操控各站点)。
纯开源版本(DeepSeek 规划、GLM 实现)画面糟糕,几乎看不出移动效果,只有零星几朵云,作为游戏起点都算不上合格。
纯 Claude 版本(全程 Fable 5.1)明显更好,导航能正常工作,飞向云层时云会逐渐靠近,作为概念验证相当不错。但为了控制token消耗,他也没能做得特别精美。
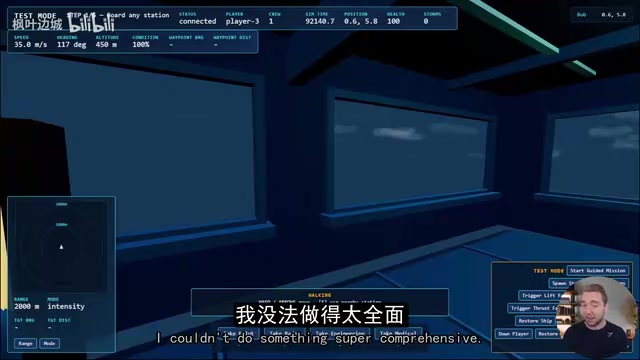
混搭版本(GPT-6 Astra 规划评审 + GLM 5.3 Flash 写全部代码)最让他惊讶:这一版的成本/token消耗大约只有纯 Claude 版的四分之一,但表现几乎持平——移动甚至更顺滑。他认为这一版实际上更好,尽管每一行代码都由开源模型写出。
他强调,这个结果在他测试的几乎所有应用上都成立。参考 LiveBench 基准,Claude Fable 5.1 与 GPT-6 Astra 能力接近,所以混搭组合能做出不逊于纯 Claude 的效果——这正是「不必每一步都用最强模型」的有力证据。
如何搭建多模型协作工作流
对于想自己复现这套流程的开发者,博主给出了几种落地方式:
最简单的手动方式
让每个coding agent输出一份「交接文档」(handoff document),手动喂给下一个模型或agent,逐个开新会话推进。虽然原始,但门槛最低。
使用 harness 工具
市面上有 Omnigent 这类 harness,能方便地跨模型、跨供应商协作。而博主自己用的是他开源的 harness 构建工具 Archon,本周数百次测试都基于它运行。
每次测试的工作流形状都一样:以一个描述需求的 GitHub Issue 为输入 → 最强模型(如 GPT-6 Astra)做规划 → 计划自动传入下一节点,由 GLM 5.3 Flash 实现 → 评审 → 发现问题回传 GLM 修正(带最大重试次数的循环)→ 最后跑测试、确保构建通过再合并。这是一个非常传统的AI编程工作流形状。
MCP(Model Context Protocol) 是Anthropic于2024年底推出的开放协议,旨在为AI模型与外部工具、数据源之间提供标准化的接口规范。通过MCP,开发者可以将代码仓库、文件系统、API服务等封装成「MCP Server」,让Claude Code等AI编程工具能够以统一方式读取diff、调用外部服务或触发自动化任务,而无需为每个工具单独编写适配代码。文中博主通过「一条命令」将Claude Code连接到Scrimba,即是利用MCP实现的低摩擦集成。MCP目前已获得包括OpenAI、Google在内的多家主要AI厂商支持,正在成为AI agent工具调用的事实标准之一。
访问开源模型的方式
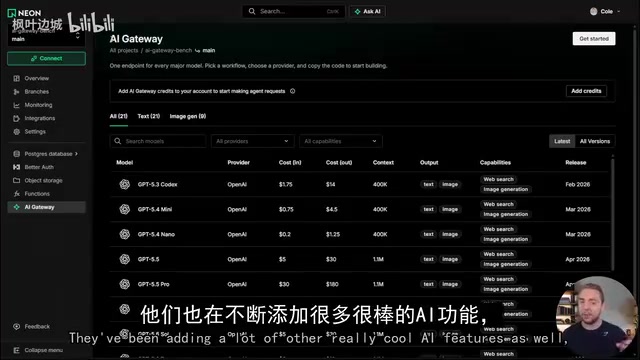
博主推荐通过 Neon 的 AI gateway 来访问开源模型,可以按成本价、可靠地调用 Kimi K3、GLM 5.3 Flash 等几乎所有主流开源模型。他强调 Archon 是免费开源的,但工具并非重点——核心是不要图省事只用 Astra 或 Fable 跑所有步骤,任何工具都能实现这套分层策略。
Harness(测试/编排框架) 在AI编程语境中,指一套用于驱动、编排和管理多个AI agent或模型调用的自动化脚手架。类比软件测试中的「test harness」,它负责定义各步骤的输入输出格式、控制调用顺序、处理重试逻辑、在不同模型或供应商之间传递上下文。Loop engineering 则是指在工作流中设计带条件判断和最大重试次数的自动循环——例如「实现→评审→发现问题→回传修正」这一闭环,让agent在无人干预的情况下自主迭代直到满足验收标准。Software factory 是更宏观的概念,指将整个软件开发流程(从需求到上线)流水线化、自动化,使AI agent像工厂流水线一样批量生产代码。这三个概念共同描述了AI编程从「对话辅助」向「全自动生产」演进的架构路径。
一个值得关注的辅助工具:Scrimba Explain
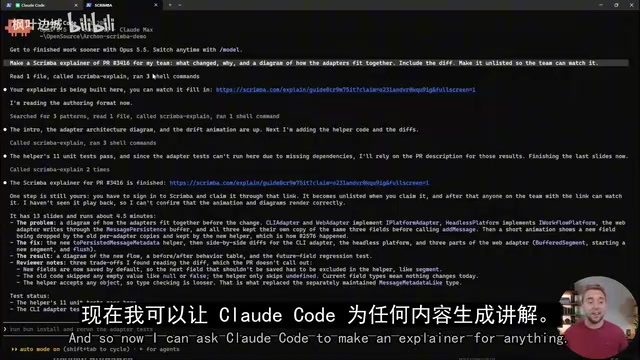
视频中还演示了赞助商 Scrimba 新推出的 Explain 功能:提问后 2-3 秒内生成一段全程语音讲解的视频课程,边看边实时构建,并能直接接入 Codex 和 Claude Code。博主用一条命令通过 MCP 连接后,让 Claude Code 为其开源项目 Archon 的一个复杂 PR 生成讲解视频——Claude 读取 diff、构建课程、逐张幻灯片流式输出到 Scrimba。他坦言最终成品「真的让我印象深刻」。该功能也支持 ChatGPT 及作为 Chrome 扩展解析任意文章。
结语:探索开源模型已是必修课
这位博主的核心观点很明确:随着前沿模型速率限制持续收紧,「所有活都交给最强模型」的时代正在结束。真正需要做的,是理解自己的AI编程工作流,搞清楚哪些环节非顶级模型不可、哪些环节完全可以用更廉价的开源模型替代。
对于个人开发者和团队而言,这套「规划用强模型、实现用小模型」的分层策略,既能显著压低成本与token消耗,又能保持产出质量。在当前额度日益紧张的现实下,认真探索开源模型,已经不再是可选项,而是必修课。
相关推荐
Cursor新手保姆级教程:用AI从零打造Python项目
Cursor 保姆级新手教程:从下载安装、三种对话模式、大模型选择,到用 AI 从零开发一个 Python 学生管理系统的完整实战流程,附环境配置与调试要点。
DeepSeek Harness 实测:八步装机教程与三大避坑指南
DeepSeek 开源工作台 Harness 发布当天获三万星。本文实测整理八步装机全流程与三大避坑指南:Node 版本、0.1 接口变动、第三方插件源码审查,并解析「一切皆插件」的架构设计。
从DeepSeek看基模创业:颠覆式创新为何独立发生?
对话栾宇深度解析DeepSeek等基础模型创业的成功逻辑:为何颠覆式创新独立发生、懂技术的领导者为何关键、战略定力与决绝投入如何决定成败。