AI大模型零基础学习路线图:四阶段从入门到就业

一套四阶段结构化路线,帮助零基础或转型者系统入门AI大模型应用开发。
这篇文章介绍了一门面向大模型应用开发的系统课程,目标人群涵盖零基础入行者、有经验的转型开发者和ChatGPT重度用户。课程针对市面上教程「要么太学术、要么太浅」的两极问题,设计了四个递进阶段:认知建立→核心技术(Prompt工程、RAG、Agent)→项目落地(微调与私有化部署)→求职实战。其方法论的核心是「先搭框架再填技能点」的自顶向下学习路径,强调先理解大模型的能力边界,避免在错误场景硬用技术导致项目失败。微调与RAG的技术选型是课程重点强调的关键判断能力,也是初学者最易混淆的核心考点。
对于想入行AI大模型的人来说,最大的困境往往不是缺教程,而是信息太杂、无从下手——今天看到Transformer的解析,明天又冒出一个新框架,学了两周还是没搭起完整的知识框架。一份B站高播放量的系统课程,试图用四个阶段的结构化路线,解决这个「学了却不会用」的普遍问题。
这门课到底适合谁
课程作者明确圈定了三类目标人群,这三类人恰好覆盖了当前想切入大模型领域的主流群体。
第一类是零基础想入行的人。他们面对的是「网上信息太杂」的困境,缺乏一张能照着走的学习地图。第二类是有开发经验的转型者——写了三五年代码的前端、Java、测试、运维工程师,技术底子有,但一被问到微调、RAG、Agent这类大模型专属概念就卡壳。第三类则是ChatGPT、Kimi的重度用户,提示词写了一堆,但离真正「会用大模型做应用」还差得远。
课程的核心价值主张在于:跟着学完,对大模型的认知会从「听说过挺火的」变成「一张能照着走的路线图」。这个定位其实点破了很多学习者的真实状态——热度知道,边界不清。
市面课程的两个极端问题
作者对现有大模型教程的批评相当直接,指出市面上的课往往走向两个极端。
一种太学术,一上来就推公式、啃论文,听完还是不会用。这类内容对科班或研究方向的人或许有价值,但对以落地应用为目标的学习者来说门槛过高、回报太慢。
另一种则太浅,教几句「咒语式提问」的技巧,看似能立刻上手,实际离真正的大模型应用差着十万八千里。这种内容制造了「我会了」的错觉,一旦进入真实项目就原形毕露。
课程的定位是卡在中间——原理认知足够让你不被新名词唬住,动手能力足够让你真做出东西。这个平衡点确实是当下应用型学习最稀缺的部分。据作者说,整套大纲不是拍脑袋想的,而是从零学起、在公司落地项目踩坑后总结出来的。
四阶段学习路径拆解
课程的骨架是四个递进的阶段,从认知到就业形成闭环。
第一阶段:认知建立
先搞清楚大模型到底是什么、和传统程序有什么本质区别、为什么它能「听懂人话」。更关键的是吃透它的能力边界——什么能做、什么做不了、什么看着能做其实做不好。作者强调,搞不清这个,后面的方案设计全是空中楼阁,一上手就翻车。这个判断很务实:大量项目失败不是技术不够,而是把不适合大模型的场景硬塞给它。
第二阶段:核心技术三块硬功夫
这一阶段聚焦三个当前大模型岗位面试的核心考点,也是日常干活的基本功:
- Prompt工程:从「会写」到「写得好」,差距在哪
- RAG(检索增强生成):从原理到落地,知识库准确率为什么上不去、检索策略怎么调
- Agent开发:多步任务怎么自动跑起来、工具怎么接、链路怎么搭
这三样构成了应用层开发者的能力底座,也是简历上最能体现实战水平的部分。
RAG(Retrieval-Augmented Generation,检索增强生成) 是目前企业落地大模型最常用的技术路线之一。其核心思路是:大模型的参数知识是训练时冻结的,无法感知实时或私有数据;RAG通过在推理时先从外部知识库检索相关片段,再将其拼入提示词,让模型「看着资料回答」,从而弥补知识盲区、降低幻觉。典型应用场景包括企业内部文档问答、客服知识库、合规审查等。RAG工程的难点不在调用API,而在检索质量——文档切片策略、向量化模型选择、相似度阈值调优、重排序(Rerank)机制共同决定最终准确率,这也是课程单独拆解「检索策略怎么调」的原因。
Agent 则是让大模型从「回答者」变成「执行者」的关键范式。通过给模型配备工具调用(Tool Use)能力,模型可以自主规划多步任务、调用搜索、代码执行、数据库查询等外部工具,完成单次对话无法处理的复杂目标。主流框架包括LangChain、LlamaIndex和AutoGen等,面试中常被问到的ReAct(Reasoning + Acting)是Agent最基础的运作模式。
第三阶段:项目落地
有了认知和技能,接下来要变成拿得出手的东西。路径从调用API起步,到搭建完整的知识库问答系统,再到微调和私有化部署。作者特别提到一个关键判断问题:为什么有的场景要微调、有的场景RAG就够?成本怎么算、效果怎么验证?
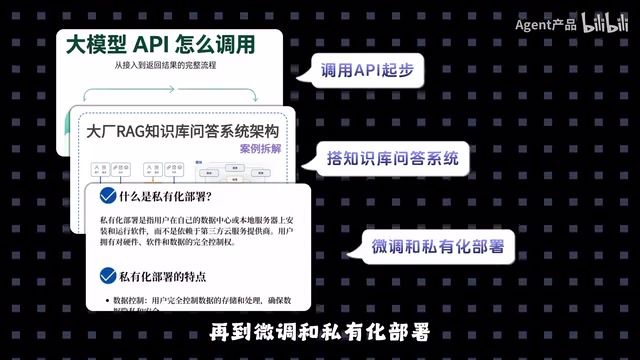
这个「微调 vs RAG」的技术选型问题,恰恰是很多初学者最容易搞混的地方。做完这一阶段,简历上写的才是「真项目」,而不是「调用过API」那种含金量存疑的经历。
微调(Fine-tuning)与RAG的选型逻辑值得单独说明。RAG适合知识频繁更新、需要引用来源、或数据量庞大的场景,优势是无需改动模型权重、成本低、知识可随时替换。微调则适合需要改变模型输出风格、掌握特定领域语言规范(如法律术语、医疗规范)、或提升某类固定任务准确率的场景,代价是需要标注数据、算力成本和迭代周期。当前主流微调方式以 LoRA(Low-Rank Adaptation) 为主,通过只训练少量低秩矩阵大幅降低显存需求,使得在消费级GPU上微调7B参数模型成为可能。私有化部署方面,Ollama、vLLM是目前最常见的本地推理框架,前者上手极简,后者吞吐量更高,适合生产环境。理解这些选型背后的成本与效果权衡,是区分「会调API」和「能设计方案」的核心分水岭。
第四阶段:求职实战
最后落到就业:简历怎么写、项目经验怎么讲、面试高频问题怎么答,从准备到拿offer的一条龙兜底。对于以转型或入行为目标的学习者,这个环节直接决定学习是否能转化为职业回报。
「先框架后填充」的学习逻辑
这门课最值得借鉴的不是具体内容,而是它的方法论。很多人学大模型上来就啃论文、背架构图,学了两周啥也没学会就放弃了。
课程的逻辑刚好相反:先搭框架,让你知道这门技术的全貌长什么样,再往里一个一个填技能点。每一步你都清楚自己在学什么、为什么学、学完能干什么。
这种「自顶向下」的学习方式,对信息过载时代的技术入门尤其有效。它解决的不是「有没有资料」的问题——资料到处都是——而是「知道该学什么、以及学习顺序」的问题。对于任何想系统进入AI大模型领域的人,这套四阶段路线图都提供了一个可参考的坐标系。
相关推荐

开源多Agent模拟经营项目实战评测
基于B站UP主开源的多Agent沙盘经营项目实测,拆解其规划、记忆、多Agent通信、HITL与评估机制,对比大模型自主决策与固定规则引擎在不同场景下的收益差异,为Agent开发者提供选型与工程实践参考。
AI工程化实战:Claude Code与Agent Skill开发全流程
B站实战课解析AI工程化:用Claude Code、Codex、WorkBuddy开发企业级Agent Skill,涵盖公众号报文、量化分析、小红书自动发布等案例,讲透Skill驱动开发的范式转移与工具选型。
LangChain零基础入门:结构化输出与Agent实战指南
从LangChain零基础讲起,厘清低代码平台与大模型应用开发的本质区别,覆盖结构化输出、工具调用、Agent实战与多租户RAG企业项目落地四大模块,适合有开发基础想转型AI应用开发的工程师。