开源多Agent模拟经营项目实战评测

B站UP主开源多Agent沙盘经营项目,实测大模型在复杂场景胜出但Token消耗更高。
本文拆解了B站UP主开源的多Agent沙盘经营项目,2-4家商店Agent在定价、补货、营销与供应商谈判中自主决策。项目覆盖规划、工具调用、多Agent通信、长短记忆、HITL、数据库幂等等核心考点,提供规则引擎、试算审核、自主规划三种决策模式。实测显示大模型Agent在简单场景惜败固定策略,但在资源竞争激烈的“供应链风暴”场景中优势明显;试算审核模式收益最佳但Token消耗约为基线三倍。项目支持对照实验,适合作为复合型Agent开发岗位的练手项目,但演示结论基于有限对局,统计显著性有限。
多智能体系统正从论文走向可交互的工程实践。B站UP主开源了一款多Agent沙盘经营项目,让2-4家咖啡/燕麦/能量棒商店在客流、竞价、库存与供应商谈判的约束下自主决策。本文基于UP主的演示与实测数据,拆解其架构设计、决策机制与实测表现,并给出可复用的开发启示。
项目概览:一场多Agent的商业博弈
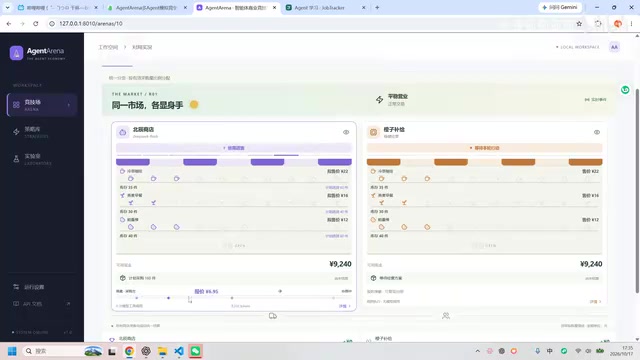
该项目的核心是一个回合制经营模拟器。每局有2-4家商店(可配置),每家商店对应一个Agent,经营咖啡、燕麦和能量棒三种商品。每轮Agent需要决策:定价、补货量、营销投入,以及与供应商Agent进行最多三轮的价格谈判。客户购买行为由固定随机规则模拟,结算后系统会给出利润与现金变化,Agent据此吸收经验、调整后续策略。
项目把商业中经典的取舍——低价冲量 vs 利润优先、囤货防断货 vs 现金流占用、库存损耗 vs 缺货损失——全部编码为环境约束,让不同Agent在相同规则下竞争。这种设计使结果可核对、可复现,也便于横向比较不同模型或策略的优劣。
技术架构:Agent开发的核心考点一网打尽
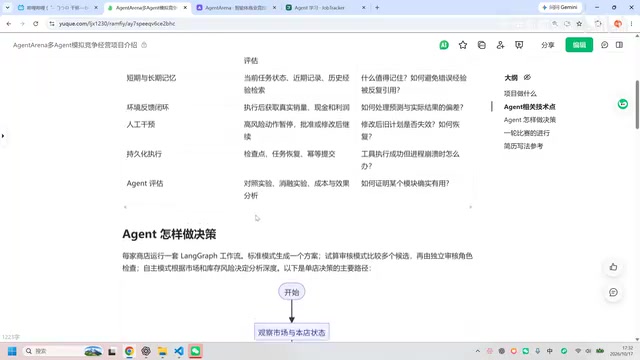
UP主在演示中列举了项目覆盖的Agent技术栈,几乎是一份“多Agent系统开发 checklist”:
- 规划与重新规划:利润目标驱动的大循环,Agent在每轮结算后重新评估策略。
- 工具调用:定价计算、库存查询、供应商通信等均以工具形式暴露。
- 多Agent通信:商店与商店之间、商店与供应商之间的协作与博弈,涉及消息传递与协议设计。
- 短期与长期记忆:区分当前回合的上下文与跨回合的历史经验,并设计检索机制决定“什么值得记住”。
- 错误经验过滤:避免将失败决策固化到记忆中,UP主强调这是容易被忽视的工程细节。
- HITL(Human-in-the-Loop):支持人工审批开关,可切换为模型自动执行。
- 数据库与幂等:回合状态持久化与重复请求处理,偏Web工程侧的考点。
- Agent评估:支持创建对照组实验,固定规则变量、仅调整模型或模块开关,对比收益与Token消耗。
UP主坦言,相比纯coding agent项目,这个项目更贴近“偏agent + 偏web”的复合型岗位需求,涉及数据库、Redis、幂等等工程能力,在求职简历上具备差异化优势。
记忆机制:在多Agent系统中,短期记忆通常指当前回合的对话上下文与临时状态(如本轮报价、库存快照),长期记忆则指跨回合积累的经验(如历史定价策略的效果、供应商的让步模式)。检索机制决定Agent在决策时“回忆”哪些历史片段——常见做法包括基于相似度的向量检索、基于时间衰减的加权,或按任务类型过滤。错误经验过滤则是在写入长期记忆前进行质量评估,避免将一次偶然的失败(如因随机客流波动导致的亏损)误判为策略性错误并固化下来。
幂等性:在回合制系统中,网络重试或用户重复点击可能导致同一回合的决策请求被多次提交。幂等设计保证同一请求ID的重复调用返回相同结果,而不会重复扣减库存或生成多笔订单。常见实现包括数据库唯一约束、Redis去重键(如SETNX)以及请求指纹比对。对于Agent系统,幂等还涉及工具调用的副作用控制——例如“向供应商下单”这一工具必须具备幂等语义,否则重试可能造成重复采购。
决策模式:从规则引擎到自主规划
项目提供三种商店决策模式,对应不同的Agent自主程度:
- 标准决策(workflow):固定规则引擎,按预设逻辑执行,适合作为基线。
- 试算与审核:Agent提出两个方案,分别试算收益后整合决策。UP主实测该模式在三次对局中均排名第一,但Token消耗接近基线的三倍,耗时也接近三倍。
- 自主规划与动态审核:完全由大模型驱动,不依赖硬编码规则,是自主性最高的模式。
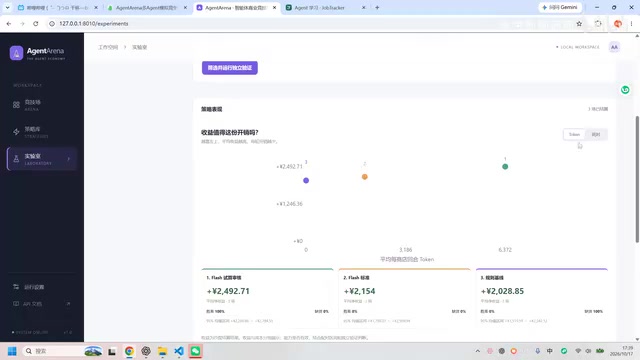
这种分层设计让开发者可以清晰地衡量“增加Agent自主性”带来的收益与成本。UP主在演示中同时开启两个商店,一个用大模型自主规划,一个用固定规则引擎,形成直接对照。
HITL(Human-in-the-Loop):指在Agent的决策流程中保留人工审批节点,使人类可以在关键操作(如确认报价、批准补货)前介入。实现上通常有两种形态:一是阻塞式审批,Agent暂停执行等待人工点击确认;二是异步审核,Agent先执行但标记为“待复核”,人工可在事后否决或修正。HITL的核心价值在于风险控制与信任建立,尤其适用于金融、供应链等容错率低的场景。其代价是自动化程度降低、响应延迟增加,因此需要根据任务风险等级动态配置审批粒度。
实测表现:大模型并非稳赢
在默认场景下,UP主用大模型Agent对阵固定策略,五轮结束后大模型惜败,仅赚996金币,而对手为1600金币。UP主分析原因是“报价报得太高”,但指出大模型在进攻意识上更强,后期有反超趋势。
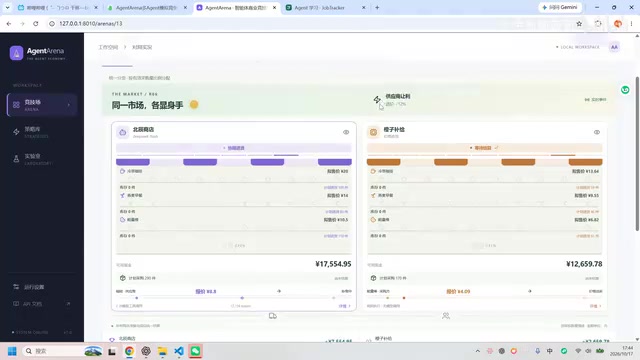
换到“供应链风暴”场景(资源竞争激烈、十回合)后,形势逆转。大模型Agent在资源紧张环境下明显优于固定策略,收益差距随回合数拉大。UP主展示的收益曲线显示,固定策略在中后期几乎失去翻盘可能。这一对比说明:场景复杂度决定了Agent自主决策的边际价值。在规则简单、变量少的场景中,固定策略的稳定性可能占优;在资源竞争激烈、需要动态权衡的场景中,大模型的规划能力才能体现优势。
另一个值得关注的细节是HITL的权衡。UP主将人工审批设为自动执行后,Agent可以完全自主完成谈判与补货决策;而保留审批则类似Codex中的确认机制,每步操作需人工点击同意。两种模式对应不同的风险偏好与自动化程度。
对照实验设计:在Agent评估中,对照实验要求严格控制变量——除待测因素(如模型类型、是否启用记忆模块)外,环境初始状态、随机种子、对手策略、回合数等均应保持一致。由于多Agent系统具有随机性(如客户购买行为由随机规则模拟),单次对局结果不足以支撑结论,通常需要多组重复实验并报告均值与方差。UP主演示中的三次实验、五轮/十回合对局属于小样本探索性测试,其结论应视为方向性参考而非统计显著证据。
对开发者的启示
这个项目最大的价值不在于“让Agent开店”这个噱头,而在于它提供了一个可观测、可对比、可复现的多Agent实验场。开发者可以:
- 固定规则变量,只改模型或模块开关,量化不同配置的收益差异;
- 观察Token消耗与决策质量的 trade-off,为生产环境选型提供依据;- 通过回合详情追溯Agent引用了哪些历史经验(UP主演示中可见第5、6、7轮的经验被调用),调试记忆检索逻辑。
UP主表示项目将开源至GitHub,并在个人主页提供免费源码获取渠道。对于想从单Agent应用迈向多Agent系统开发的工程师,这是一个门槛适中、技术点密集的练手项目。
需要提醒的是,演示中部分结论基于有限对局(如三次实验、五轮/十回合),统计显著性有限;不同模型、不同提示词下的表现可能存在较大波动。建议读者自行运行多组对照实验后再下结论。
相关推荐
11小时视频课程:从零构建推理模型
一套超过11小时的视频课程,用Python和PyTorch讲解推理模型的评估、推理时扩展、强化学习与蒸馏四大模块,适合有基础的开发者系统学习推理模型构建。

Laika二十年磨一剑:Wildwood如何延续定格动画野心
Laika用二十年时间打磨定格动画工艺,新片《Wildwood》邀请资深摄影指导Caleb Deschanel加盟。本文分析Laika的工业化体系、定格动画的独特挑战,以及真人电影与动画人才交融的行业启示。

Telstra终结澳洲RCS漫长等待:运营商为何集体转向?
Telstra正式支持RCS,终结澳大利亚在富通信服务上的漫长等待。本文分析RCS在澳洲推进缓慢的原因、运营商集体转向的深层逻辑,以及对用户和开发者的影响。