#Agent评估
共 15 篇相关文章

别数Token了,数交付成果:AI编程Agent的评估新思路
AI编程Agent单任务Token消耗可达普通对话的10到50倍。本文分析为何Token计数不再是有效评估指标,并提出以任务完成率、修正轮次、人工介入比例等交付指标衡量Agent价值的新思路。

95%准确的Agent为何50步任务成功率仅7.7%?
Reddit讨论揭示:95%单步准确率的AI Agent在50步任务中成功率仅7.7%。本文分析概率乘法效应、减少步骤与提升准确率的权衡,以及弃权机制和端到端评估的重要性。
WebMCP工具怎么测?用Evals评估非确定性AI行为
WebMCP 工具由非确定性的 AI Agent 调用,传统单元测试无法验证 Agent 是否选对工具、传对参数。本文介绍 Evals 评估方法:用 JSON 定义期望工具调用,通过 local 与 browser 两种模式运行,并借助 WebMCP eval-cli 多轮运行获得通过率与 Agent 轨迹报告。

当Agent失败时,该怪模型还是执行框架?
LLM Agent失败该怪模型还是执行框架?一项大规模研究提出五维评估框架,通过52168条轨迹揭示模型与框架的交互才是Agent表现的关键,没有万能框架,只有最佳配对。

AI Agent生产级评估实战:从追踪到自动化闭环
从追踪埋点到代码评估、LLM裁判、自定义评分标准与元评估,完整拆解AI Agent生产级评估体系:如何阅读追踪做错误分析、构建失败数据集、用编程Agent闭环改进提示词,并落地在线评估与持续迭代。
AI Agent生产环境失败?四步构建评估体系
Google工程师Dani与Docs Agent开发者Matt实战演示:四步构建AI Agent评估体系,从追踪数据到OpenInference格式统一,再到自定义指标与可视化报告,解决Agent生产环境质量退化难题。
AI Agent评估新趋势:方法、挑战与生态全解析
解读AI Agent评估新趋势论文:梳理静态基准、交互式评估与人类反馈三大方法,分析评估生态中的角色分歧,并为开发者提供构建评估流水线的实用建议。

AI Agent生产环境翻车,责任到底该谁背?
AI Agent在生产环境失败时责任该由谁承担?Reddit开发者讨论揭示:输出正确不等于行为正确,团队需建立从开发到合规的完整责任链,并将行为验证纳入部署验收标准。
AI Agent评估实战:工具调用、轨迹匹配与LLM裁判
AI Agent评估需要分层进行:先用确定性检查验证工具调用,再用轨迹匹配确保执行路径合理,最后用LLM裁判评估响应质量。本文结合Pydantic Evals和Mastra的实践,详解三层评估框架的设计与落地。

人类评审 vs 自动评估:谁来给AI Agent打分?
人类专家评估与自动化评估谁更适合AI Agent?本文结合Netflix、Rhesis等团队的生产实践,对比两种评估方式各自的强项与断裂点,并给出一个可落地的混合评估闭环。
稀疏奖励只是借口:Agent评估的真正瓶颈是作者成本
长周期Agent评估只能用稀疏奖励?本文分析为何密集评分的真正瓶颈是作者成本而非计算成本,并介绍Tev提出的从世界规格渲染环境、让进展作为副产品自动产生的方法。

AI Agent评估流水线完全指南:从生产追踪到发布决策
AI Agent评估流水线如何搭建?本文拆解生产追踪、隔离试验、发布证据三个核心环节,讲解如何把碎片化测试转化为可支撑上线决策的系统化评估体系。

AI Agent操作恢复基准测试:当任务完成却得零分
一项针对AI Agent操作恢复场景的基准测试揭示:模型在确认回执丢失时如何安全处理非幂等写入。测试对比DeepSeek Flash与Pro,发现任务完成却因JSON解析失败得零分的悖论,并坦诚披露Kaggle平台提交资格缺口。
 深度解读
Replit如何评估AI编程Agent:ByteBench基准测试与持续优化体系详解
深入解析Replit构建的AI Agent双支柱评估体系,包括开源基准测试ByteBench、语义聚类工具Telescope、离线+在线评估闭环,以及A/B测试驱动的持续迭代方法论。
 深度解读
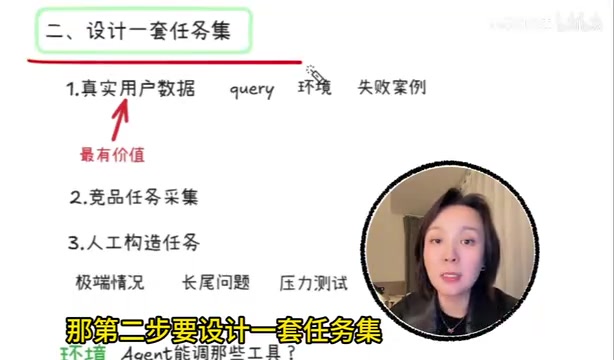
Agent评估五维体系:AI产品经理面试必考题全解析
详解AI Agent评估的五维体系——诚、快、省、稳、安全,涵盖任务集设计、过程与结果评估、对照实验等核心方法,帮助AI产品经理在面试和实际工作中系统化评估Agent产品质量。