AI恶搞基准测试走红:跑分文化背后的社区减压与反思
当基准测试变成社区玩梗
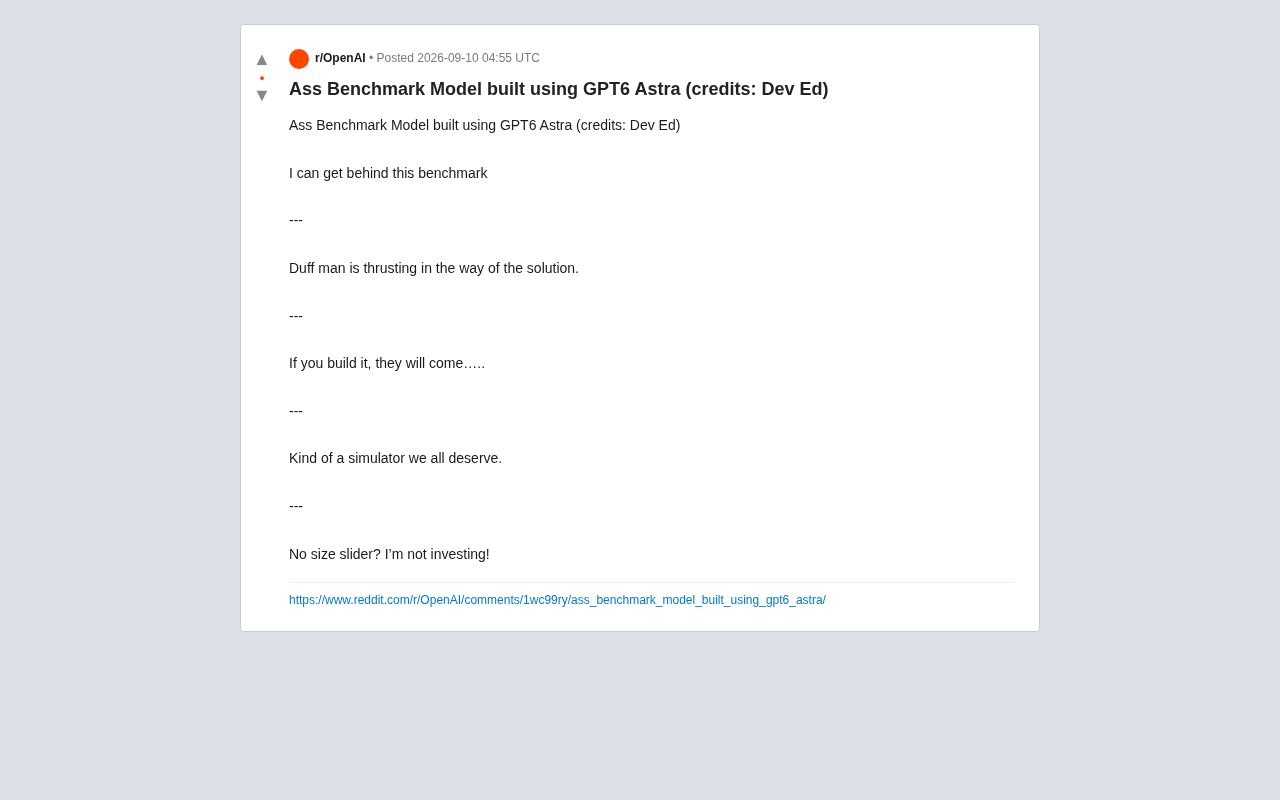
近日,Reddit社区出现了一个名为"Ass Benchmark Model"的恶搞项目,据称基于所谓的"GPT6 Astra"构建(原作者归功于开发者Dev Ed)。这个明显带有调侃性质的"基准测试"迅速在社区中引发了一波讨论热潮,评论区充满了各式各样的玩梗互动。
Reddit在AI技术讨论生态中扮演着独特而关键的角色。与Twitter/X上碎片化的信息流和LinkedIn上偏向职业化的叙事不同,Reddit的子版块(subreddit)机制天然适合深度技术讨论。r/MachineLearning是最早的学术级AI讨论社区之一,许多重要论文的首轮公开讨论都在这里发生;r/LocalLLaMA则聚焦于本地部署开源模型的实践,成为了开源AI运动的重要舆论阵地;r/artificial和r/singularity则更偏向AI的社会影响讨论。这些社区共同构成了一个多层次的技术舆论场,既能产出严肃的技术评测和代码贡献,也能孕育出像"Ass Benchmark Model"这样的恶搞项目。正是Reddit的匿名性、投票机制和社区自治文化,使得这类讽刺性内容能够迅速获得可见度,成为社区集体情绪的温度计。
Dev Ed作为项目的归功对象,代表了一个正在崛起的技术内容创作者群体。这些创作者活跃于YouTube、Twitch和TikTok等平台,以轻松幽默的风格解读AI技术,与传统学术界和企业公关形成鲜明对比。Dev Ed本人以其诙谐的编程教程和对技术趋势的调侃式评论而闻名,拥有大量年轻开发者粉丝。这类创作者的影响力不容小觑——他们正在重塑技术社区的话语方式,将原本晦涩的技术讨论转化为可参与、可传播的文化事件。当一个恶搞项目被归功于这样的创作者时,它本身就获得了一层"圈内认可"的合法性,更容易在社区中引发共鸣和二次传播。
虽然项目本身并非严肃的技术产出,但它折射出的现象却值得深入关注:当AI技术加速迭代、各大厂商争相发布"史上最强"模型和基准测试成绩时,开发者社区正在用幽默的方式消解这种技术焦虑与营销轰炸。
社区反应:调侃中的真实技术态度
从Reddit评论区的反应来看,用户们对这个恶搞项目表现出了高度的"配合"精神。有人调侃道"我可以支持这个基准测试"(I can get behind this benchmark),也有人套用《梦幻成真》的经典台词"If you build it, they will come"(如果你建造它,他们就会来)。
更有意思的是,有评论者以产品评测的口吻吐槽:"没有尺寸滑块?那我不投资!"(No size slider? I'm not investing!)——这句看似荒诞的评论,实际上精准地讽刺了当下科技产品发布会中堆砌参数、强调可定制性的营销话术。在当前的AI产品发布中,"上下文窗口大小""参数量""推理速度"等数字已经成为必备的营销弹药,每一个滑块、每一个可调节的参数都被包装成产品差异化的卖点,而用户真正关心的实际使用体验反而退居其次。这种"参数崇拜"现象在消费电子领域早有先例——智能手机行业曾经历过"像素大战""跑分至上"的阶段,最终消费者发现更高的纸面参数并不必然带来更好的拍照体验或日常使用感受。如今AI行业正在重演类似的剧本,只是这一次的"参数"变成了万亿级的模型权重和百万级的上下文窗口。更具讽刺意味的是,许多AI产品的"可调节参数"(如temperature、top-p、频率惩罚等)对于普通用户而言几乎是不可理解的黑箱——它们的存在更多是为了营造"专业感"和"掌控感",而非真正提升用户体验。这与消费电子产品中"专业模式"的设计逻辑如出一辙:绝大多数用户永远不会去手动调节这些参数,但它们的存在本身就是一种营销叙事。
还有用户称这是"我们都应得的模拟器"(Kind of a simulator we all deserve),暗含着对当前AI产品泛滥的一种自嘲式反思。
恶搞背后的技术文化现象
对AI基准测试军备竞赛的反讽
近年来,AI领域的基准测试(Benchmark)已经成为各大模型厂商的必争之地。从MMLU、HumanEval到各种自定义评测集,模型排行榜几乎成了衡量技术实力的唯一标尺。
具体来说,MMLU(Massive Multitask Language Understanding)是一个涵盖57个学科领域的大规模知识与推理评测集,被广泛用于衡量大语言模型的通用知识水平。HumanEval则是OpenAI开发的编程能力评测集,包含164道Python编程题,用于测试模型的代码生成能力。除此之外,业界常用的基准测试还包括GSM8K(数学推理)、GPQA(研究生级别问答)、ARC(科学推理)等。这些评测集构成了一套复杂的模型能力评价体系,但也催生了严重的"刷榜"现象——部分开发者会针对特定评测集进行数据污染或过拟合训练,导致模型在榜单上表现优异,却在实际应用中表现平庸。业内将这种现象称为"Goodhart定律"的典型体现:当一个指标变成目标时,它就不再是好的指标。
从技术层面来看,过拟合评测集(benchmark overfitting)的手段已经变得相当隐蔽和多样化。最直接的方式是将评测集数据混入训练语料(即数据泄漏),但更常见的是间接污染:由于许多基准测试的题目和答案被大量讨论、引用和转载于互联网各处,大规模网络爬虫在收集训练数据时会不可避免地将这些内容纳入语料库。此外,一些开发者会采用"教学式微调"(instruction tuning)的策略,使用与评测集题型高度相似但并非完全相同的训练样本,让模型学会特定的答题模式和格式偏好。更极端的情况下,某些模型甚至会被训练出"识别评测场景"的能力——当检测到输入模式类似于常见基准测试时,切换到更保守、更标准化的回答策略。这些手段使得单纯依靠静态基准测试来评估模型能力变得越来越不可靠,也推动了业界对评估方法论的深刻反思。
然而,过度依赖基准测试带来的"刷榜"和"过拟合评测集"等问题,导致模型的真实能力与榜单成绩出现明显脱节。所谓"基准测试污染"(Benchmark Contamination),是指模型在训练过程中有意或无意地接触到了评测集中的数据,从而在测试中获得虚高的分数。这种污染可能发生在预训练阶段(评测题目被包含在海量训练语料中)或微调阶段(开发者故意使用评测集数据进行针对性训练)。为了应对这一困境,业界开始探索更加动态和抗污染的评估方法。其中最具代表性的是由LMSYS组织运营的Chatbot Arena——一个基于众包的实时评测平台,用户可以同时与两个匿名模型对话,然后投票选出表现更好的一方。这种"盲测+Elo评分"的机制借鉴了国际象棋的排名系统,能够持续产生新的评测样本,有效规避了数据污染问题。截至目前,Chatbot Arena已经积累了数百万次人类投票,被许多研究者认为是比静态基准测试更可靠的模型能力参考。
Chatbot Arena所采用的Elo评分系统值得进一步了解。这套系统最初由匈牙利裔美国物理学家Arpad Elo在1960年代为国际象棋设计,其核心思想是:每个选手拥有一个动态更新的分数,每场对局结束后,胜者从败者处获得一定的分数转移,转移量取决于双方赛前的分数差——以弱胜强获得的分数多于以强胜弱。这套系统后来被广泛应用于电子竞技、在线游戏匹配等领域。在Chatbot Arena中,每个AI模型就是一个"选手",每次用户的偏好投票就是一场"对局"。然而,这套系统在AI评测中也面临独特挑战:用户的投票可能受到回答风格(如更长的回答往往被认为更好)、格式偏好(如使用Markdown格式的回答得分更高)等非能力因素的影响;此外,不同语言和文化背景的用户可能有系统性的偏好差异。LMSYS团队为此引入了多种统计修正方法,包括控制变量分析和Bootstrap置信区间估计,以提高排名的可靠性。尽管如此,Chatbot Arena仍然代表了目前最接近"真实用户体验"的模型评估范式。
这个恶搞基准测试的走红,某种程度上正是社区对这种"跑分文化"的戏谑回应。当一切都可以被量化、被基准化时,用一个荒诞的"基准"来解构其严肃性,反而成了一种巧妙的批判方式。
虚构的"GPT6 Astra":对模型炒作的讽刺
你可能没注意到,项目中提到的"GPT6 Astra"目前并不存在——OpenAI尚未发布GPT-5的正式版本,更遑论GPT-6。
要充分理解这个虚构名称的讽刺力度,需要了解OpenAI GPT系列的实际发展脉络:GPT-3于2020年发布,GPT-3.5在2022年底随ChatGPT一同亮相并引爆全球AI热潮,GPT-4于2023年3月发布,GPT-4o("o"代表omni,即全能)在2024年5月推出。截至目前,GPT-5尚未正式发布,仅有各种传闻和猜测。而"Astra"这个命名则可能戏仿了Google DeepMind在2024年展示的Project Astra(一个多模态AI助手原型),将不同公司的品牌元素混搭在一起,进一步放大了恶搞效果。直接跳过整整两个版本号到"GPT-6",本身就是对社区中"下一代模型必将颠覆一切"这种叙事的极致嘲讽。
值得注意的是,AI行业的模型命名本身已经演变为一种精心设计的品牌策略。OpenAI的"GPT"系列通过简洁的数字递增暗示持续进步,Anthropic的"Claude"以人名命名营造亲和力(Claude的名字据说致敬了信息论之父Claude Shannon),Google则在"Gemini"(双子座)的星座意象中融入"超越"的隐喻(暗示超越GPT-4)。Meta的"LLaMA"(大型语言模型Meta AI)巧妙利用了动物形象的亲切感,而中国的各大模型也纷纷采用富有文化内涵的名称,如"文心一言""通义千问"等。这种命名军备竞赛本身就构成了一道独特的行业景观。"GPT6 Astra"将OpenAI的版本号体系与Google的项目名称混搭在一起,恰恰是对这种命名游戏的绝妙戏仿——它暗示在炒作的逻辑下,品牌符号可以被任意组合拼贴,反正没有人会去验证一个尚不存在的产品的真实性。
这种品牌命名策略的深层逻辑与AI行业的融资和估值紧密相关。在风险投资驱动的商业环境中,一个响亮的产品名称和版本号不仅是面向用户的营销工具,更是面向投资者的信号装置。当OpenAI宣布GPT-4时,仅凭版本号的递增就能在资本市场引发巨大反响;当Google将其模型从"Bard"更名为"Gemini"时,背后是一整套品牌重塑和市场定位的战略考量。在这种语境下,"GPT6 Astra"的虚构不仅讽刺了技术炒作,也暗讽了一种商业现实——在AI行业,有时候"命名"和"预告"本身就能创造价值,即使产品尚未存在。
这种对尚未发布产品的调侃,在AI社区中相当常见。每当有新模型的风声传出,网络上总会涌现大量真假难辨的"预告"和"内幕消息",而恶搞项目正是对这种信息噪音的幽默回击。
幽默:技术社区不可缺少的"减压阀"
从更宏观的角度来看,这类恶搞内容在开发者和AI爱好者社区中扮演着重要的减压角色。面对AI技术近乎疯狂的迭代速度、层出不穷的新工具和新概念,从业者难免产生技术焦虑(俗称"AI FOMO"——害怕错过下一个重大突破)。
AI FOMO已经成为技术从业者中一个被广泛讨论的心理现象。据多项行业调查显示,超过60%的开发者表示在过去一年中感受到了前所未有的技术焦虑。这种焦虑的来源是多方面的:一方面,大模型的能力迭代周期从过去的数年缩短到数月甚至数周,上周刚学会使用的工具可能本周就被新版本淘汰;另一方面,社交媒体上充斥着各种"某某工具将取代某某职业"的惊悚标题,持续制造恐慌情绪。这种"永远在追赶、永远觉得落后"的心理状态,如果得不到适当的释放和调节,可能导致职业倦怠甚至心理健康问题。
值得注意的是,AI FOMO不仅影响个体开发者,还深刻塑造了企业的技术决策。许多公司在尚未明确业务需求的情况下,就急于部署AI解决方案,这种现象被业内戏称为"AI锤子找钉子"——手握AI这把锤子,看什么问题都像钉子。Gartner等研究机构的报告指出,相当比例的企业AI项目在概念验证阶段就宣告失败,其中很大一部分原因就是决策者出于FOMO心理而非实际业务需求来推动项目。这种从个人焦虑到组织决策失误的传导链条,使得AI FOMO从一个心理学现象升级为一个具有实际经济影响的行业问题。社区中的恶搞内容在某种程度上也起到了"去魅"的作用——当人们能够笑着看待AI炒作时,他们在做技术决策时也更有可能保持理性。
这种焦虑的加速器之一是开源社区的爆发式增长。以Hugging Face为例,这个被称为"AI界的GitHub"的模型托管平台,截至2024年已经托管了超过50万个模型和10万个数据集,每天都有数百个新模型被上传。开发者面对的不再是"要不要学新技术"的问题,而是"该学哪一个"的选择困难。与此同时,AI领域的论文发表速度也在急剧攀升——仅arXiv平台上,与大语言模型相关的预印本论文数量在2023年就超过了此前所有年份的总和。这种信息过载与技术更迭的双重压力,使得即便是全职AI研究人员也难以全面跟踪领域进展,更不用说需要兼顾日常工作的一线开发者。在这样的背景下,社区中的恶搞和幽默内容实际上提供了一种"信息降噪"的功能——它帮助人们用笑声来消化那些令人焦虑的信息流,将严肃的竞争压力转化为共享的娱乐体验。
通过创造和分享这类无厘头的项目,社区成员得以在紧张的学习和竞争氛围中找到片刻的轻松。这种集体幽默不仅拉近了成员之间的距离,也构成了技术亚文化的重要组成部分。
回顾互联网技术发展史,从早期的编程笑话、Stack Overflow上的经典问答梗,到如今的AI恶搞项目,幽默始终是技术社区文化基因中不可或缺的一环。事实上,技术社区的恶搞传统由来已久——早在1990年代,程序员就创造了诸如"Brainfuck"(一种极简但几乎不可读的编程语言)这样的恶搞作品。Stack Overflow上关于"如何退出Vim编辑器"的问题累计浏览量超过数百万次,成为了程序员圈子的经典梗。GitHub上也长期存在各种恶搞仓库,如"nocode"(一个完全没有代码的项目,讽刺低代码/无代码运动)曾获得数万颗星。在AI时代,这种传统自然延伸到了对模型能力、基准测试和行业炒作的调侃领域。还有一些经典案例同样值得一提:2015年的"is-thirteen"(一个专门用来判断一个数是否为13的npm包,讽刺JavaScript生态中过度模块化的倾向)、"FizzBuzzEnterpriseEdition"(用极度过度工程化的方式实现简单的FizzBuzz问题,讽刺企业级Java开发的臃肿)等。这些项目的共同特点是以荒诞的方式精准命中行业痛点,通过"把荒谬推向极致"来揭示现实中已经存在但被习以为常的荒谬。"Ass Benchmark Model"完全继承了这一传统,只是将矛头对准了AI时代最显眼的靶子——基准测试崇拜和模型炒作。
从文化研究的视角来看,这些恶搞行为可以用俄国文学理论家巴赫金的"狂欢化"(Carnivalization)理论来理解。巴赫金认为,中世纪的狂欢节通过戏仿和颠覆官方话语,创造了一个暂时消除等级秩序的"笑的世界"。技术社区的恶搞项目扮演着类似的角色:在正式的技术话语体系中,大公司的产品发布、学术论文的评审标准、基准测试的排行榜构成了一套"官方叙事";而恶搞项目则通过荒诞的模仿,暂时解构了这套叙事的权威性,让普通开发者获得了一种平等参与和批判的权力。这种"技术狂欢"不仅不会损害技术进步,反而有助于社区保持批判性思维的活力,防止对任何单一叙事的盲目信仰。
这些恶搞行为看似无厘头,实际上是技术社区进行自我调节和批判性思考的重要机制。它提醒每一个参与者:技术的最终目的是服务于人,而不是制造焦虑。
结语:在AI狂飙时代保持清醒
虽然"Ass Benchmark Model"本身没有任何实际的技术价值,但它作为一个社区文化现象,提醒我们在追逐技术前沿的同时,也应当保持一份轻松和自省的心态。
对于真正的开发者而言,与其纠结于各种真真假假的基准跑分和模型泄露传闻,不如脚踏实地地理解技术本质、构建真正能解决问题的应用。而社区的这份幽默感,恰恰是保持理性与热情平衡的良药。
毕竟正如那句评论所说——"这是我们都应得的模拟器"。在AI狂飙突进的时代,偶尔的自嘲和调侃,或许正是我们保持清醒所需要的。
相关推荐
MiniMax H3 开源视频模型本地部署实测:8G显存即可玩转
MiniMax H3 最新开源视频生成模型本地部署实测教程,支持文生视频、图生视频与首尾帧控制。8G显存即可运行,含ComfyUI部署流程、量化版本选择与实际应用效果分析。
LTX2.5开源本地部署实测:AMD显卡最低8G显存跑视频生成
开源视频生成模型 LTX2.5 本地部署实测:AMD 7900XTX 显卡在 Windows 11 环境下最低 8G 显存可运行,2 分钟生成 5 秒视频。附五套工作流对比与整合包、手动部署教程。
ComfyUI双语提示词节点实测:不懂英文也能玩转标签
一位B站UP主借助GPT打造的ComfyUI双语标签提示词拓展节点实测:中英标签双向联动、30万词库支持、未知标签一键翻译沉淀,让不懂英文的小白也能玩转提示词,目前适配anima本地部署模型。