#AI基准测试
共 5 篇相关文章

·8 分钟
GhostInk基准测试:AI能承认"我看不清"吗?
GhostInk基准测试揭示视觉语言模型的一个致命盲区:面对褪色账单,Gemini与Gemma能读字却不会承认"读不出",反而自信编造商品名与税号。本文解析该OCR诚实度基准的设计、评分与核心发现。
阅读全文 →

·4 分钟
一张"跑分神图"引爆Reddit:AI基准测试的荒诞真相
一张恶搞"AI基准测试"图在Reddit爆火:Y轴竟是模型版本号本身。这场关于GPT跑分文化的讽刺实验,意外照出了人们批判性思维的缺失,也揭示了AI行业benchmaxxing刷榜的荒诞现实。
阅读全文 →
Fireworks推出SII专业智能指数:面向真实工作的行业基准
·3 分钟
Fireworks推出SII专业智能指数:面向真实工作的行业基准
Fireworks推出Specialized Intelligence Index(SII)专业智能指数,聚合各行业真实工作基准测试,由实际使用团队构建,推动AI评测从通用榜单走向应用导向。
阅读全文 →

·3 分钟
Vals AI获a16z投资:打造AI基准测试的黄金标准
获Andreessen Horowitz投资的Vals AI,正试图成为AI基准测试的黄金标准,为模型泛滥的市场提供中立、可信的第三方评测资源。本文解析其定位、a16z背书的意义及面临的挑战。
阅读全文 →
 前沿研究
·9 分钟
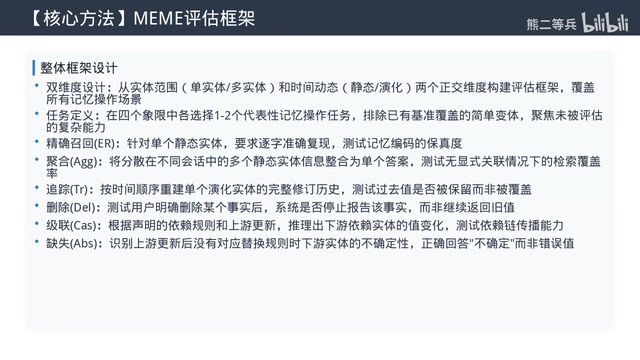
MEME基准测试揭示LLM记忆系统致命缺陷:依赖推理准确率不足50%
MEME基准首次全面评估LLM记忆系统的依赖推理能力,测试6大主流系统结果显示最佳准确率仅42%。本文深度解析级联推理、缺失推理等关键任务的失败根因,并探讨下一代AI Agent记忆架构的改进方向。
阅读全文 →