Claude识破ChatGPT代码风格:AI能认出AI吗?

Claude识破用户粘贴ChatGPT代码,揭示AI模型通过风格与上下文推断文本来源的原理与局限。
Reddit上一则趣味帖子引发了关于AI风格识别的讨论:一位用Claude学Python的用户将ChatGPT生成的代码偷偷粘回对话,结果被Claude识破。文章指出,这并非Claude内置了某种检测器,而是大语言模型对文本风格分布高度敏感,加之对话上下文提供了用户原有水平的参照,使得风格突变成为强烈信号。不同模型在RLHF微调过程中形成各自的「写作指纹」,体现在注释密度、命名习惯、代码结构等细节上。然而,这种识别能力并不稳定,现有AI内容检测工具误报率较高,Claude的「精准识别」更多是特定情境下的合理推断。文章最终落脚于学习层面:用AI辅助编程时,亲自动手才是真正掌握算法的唯一路径。
一次学习编程时的意外发现
最近,Reddit上一则趣味帖子引发了不少AI爱好者的讨论。一位正在用Claude学习Python编程的网友分享了自己的经历:当他掌握了经典算法题「3Sum」(三数之和)后,Claude建议他自己动手写一个示例。然而这位网友「偷懒」了——他转头让ChatGPT生成了一段代码,再粘贴回Claude的对话框中。
没想到的是,Claude竟然「看穿」了这段代码并非出自用户之手,而是ChatGPT的手笔。这让发帖人惊呼:「连Claude都知道我是从ChatGPT那里粘贴过来的💀」。
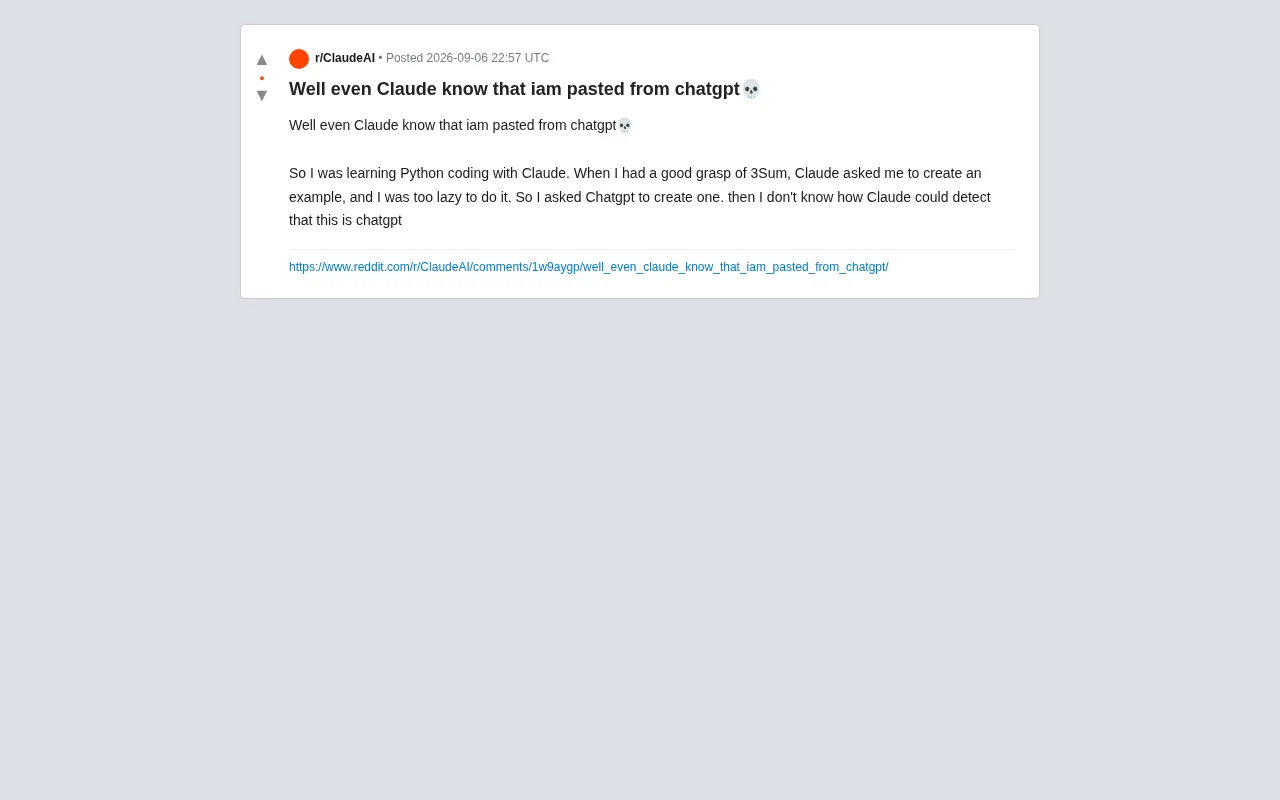
这个看似玩笑的场景,实际上触及了一个有趣的技术话题:AI模型是否真的能识别出另一个AI生成的内容? 答案比表面看起来更复杂。
AI真的能「认出」彼此吗?
不是「检测」,而是「风格识别」
首先需要澄清一个常见误解。Claude并没有某种内置的「ChatGPT检测器」,能够扫描代码并给出「这是AI生成」的确定判断。更准确的说法是,大语言模型对文本风格有着极强的敏感度。
不同的AI模型在长期训练和微调过程中,形成了各自独特的「写作指纹」。以代码为例,ChatGPT生成的Python代码往往有一些鲜明特征:
- 过于详尽的注释:几乎每一行都配有解释性注释
- 规范但略显冗余的命名:如
nums_sorted、result_list等 - 固定的结构模式:偏好使用特定的边界检查和异常处理写法
- 教科书式的排版:docstring、类型注解一应俱全
当一段代码突然从「学习者的稚嫩笔触」变成「工整规范的标准答案」时,这种风格上的巨大跳跃本身就是一个强烈信号。
「写作指纹」的形成与大模型的RLHF(基于人类反馈的强化学习)微调密切相关。不同公司的模型在预训练后会用各自的偏好数据对模型进行微调,使其输出更符合特定的风格标准——例如OpenAI倾向于训练ChatGPT给出结构清晰、注释完备的代码示例,而Anthropic对Claude的训练则侧重另一套交互风格。这种微调过程会在模型输出中留下可被感知的「品牌烙印」,表现为词汇选择、代码结构、错误处理方式等维度上的系统性偏好。正是这种由训练数据和强化学习目标共同塑造的差异,让不同模型的输出在风格上形成了各自的特征分布。
对话上下文才是关键线索
你可能没注意到,Claude之所以能「察觉」,很大程度上依赖于对话上下文。在整个学习过程中,Claude已经「见过」用户此前的代码风格、提问方式和理解水平。当一段明显超出用户当前水平、且带有典型ChatGPT特征的代码突然出现时,模型基于上下文推断出「这不像是你写的」,是完全合理的。
这其实和一位有经验的老师批改作业时的直觉类似——当一个平时基础薄弱的学生突然交出一份完美答案,老师自然会心生疑问。
背后的技术原理:大模型如何感知文本风格
AI生成文本的统计特征
大语言模型本质上是在海量文本上训练出的概率模型。它们对语言的分布规律极为敏感,能够捕捉到人类难以察觉的细微模式。研究表明,AI生成的文本往往在词汇多样性、句式结构、困惑度(perplexity) 等维度上呈现出与人类写作不同的统计特征。
具体到代码领域,AI生成代码的「可预测性」通常更高——即每个token的出现更符合模型的期望分布,这使得另一个大模型在处理时更容易识别出这种「机器味」。
困惑度(Perplexity) 是衡量语言模型对一段文本「感到意外程度」的指标。直觉上,如果一段文本的每个词都高度符合模型的预测,困惑度就低;反之则高。AI生成的文本往往困惑度偏低,因为它本身就是由类似的概率机制产生的,词汇选择趋向「最优解」而缺乏人类写作中的随机性和个人偏好。GPTZero等检测工具早期就大量借助困惑度指标来判断文本来源。与困惑度相关的另一个概念是突发性(Burstiness),指文本中复杂句与简单句交替出现的波动程度——人类写作通常有更明显的突发性起伏,而AI生成的文本则相对平稳均匀。这两个维度结合起来,构成了当前AI内容检测方法的重要基础。
AI内容检测的局限性
然而,必须强调的是:这种识别能力并不稳定,也不应被当作可信的检测手段。 目前业界的AI内容检测工具(如GPTZero等)都存在较高的误报率。原因在于:
- 优秀的人类程序员写出的规范代码,同样可能被误判为AI生成
- 经过修改润色的AI代码,识别难度大幅上升
- 不同模型的风格差异正在随着技术迭代逐渐模糊
因此,Claude这次的「精准识别」更像是特定情境下的合理推断,而非某种可靠的鉴定技术。
这件小事给我们的启示
对AI辅助编程学习者的提醒
这个帖子虽然带着调侃意味,但其中蕴含的道理值得每位技术学习者深思。当我们用AI辅助学习编程时,真正的成长来自于亲自动手。Claude让用户自己写示例,本意正是为了巩固对「3Sum」算法的理解。绕过这个练习去复制粘贴,看似省事,实则错失了最宝贵的学习环节。
正如许多资深开发者所强调的:读懂代码和写出代码之间,隔着一条巨大的鸿沟。而跨越这条鸿沟的唯一方式,就是反复的刻意练习。
多AI协作时代的思考
从更宏观的角度看,这个案例也揭示了当前AI工具生态的一个有趣现象:多个AI模型正在越来越多地参与到同一个工作流中。用户在Claude和ChatGPT之间来回切换,让不同模型各展所长,已经成为不少人的日常。
在这种「多AI协作」的场景下,模型之间的风格差异和相互识别能力,可能会衍生出新的应用可能——比如内容溯源、质量交叉验证等。当然,这也提醒我们,在混用多个AI工具时,保持输出风格的一致性和内容的原创性,仍然需要人类使用者的主动把关。
结语
一个略带自嘲的Reddit帖子,意外地打开了关于AI风格识别的讨论窗口。Claude能「认出」ChatGPT的代码,靠的不是什么神秘的检测黑科技,而是大模型对文本风格的深度敏感,以及对对话上下文的合理推理。
对于我们每个人而言,这件趣事最实用的启示或许很简单:用AI学编程时,该自己动手的时候,就别偷懒了。 毕竟,连AI都看得出你在糊弄它呢。
相关推荐

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。

trainlint:静态检查揪出不会崩溃的 ML 训练 Bug
trainlint 是一个静态检查工具,能找出不会报错的机器学习训练 bug,包括数据泄漏、eval 模式残留、softmax 与 CrossEntropyLoss 冲突等十四类问题。本文介绍其原理、验证结果与局限。