trainlint:静态检查揪出不会崩溃的 ML 训练 Bug

开源工具 trainlint 用静态分析在运行前捕获训练代码中的静默 bug。
trainlint 是开发者 Satvik Jain 发布的开源工具,基于 Python 的 ast 模块做静态分析,无需运行代码、数据或 GPU,即可识别训练与评估脚本中的十四类反模式。作者用随机特征实验说明数据泄漏的严重性:在全量数据上选特征再做交叉验证,准确率可达 85%,而正确做法仅约 50%。工具覆盖模式切换、损失函数误用、训练循环错误和工程卫生等问题,在 pytorch/examples 固定 commit 上验证,22 个报错中 20 个为真实问题。其局限在于仅支持 PyTorch 与 scikit-learn、依赖命名匹配和单文件解析、缺少召回率数据,适合作 CI 第一道防线。
训练代码里最危险的 bug 往往不会报错——模型照常训练,损失正常下降,但结果就是不对。最近一个名为 trainlint 的开源工具试图用静态分析解决这类「沉默的错误」。
开发者 Satvik Jain 在 Reddit 上介绍了这个项目:它用 Python 的 ast 模块解析代码,匹配变量名和 API 调用,在不运行代码、不需要数据、模型或 GPU 的情况下,找出训练和评估脚本中的常见反模式。
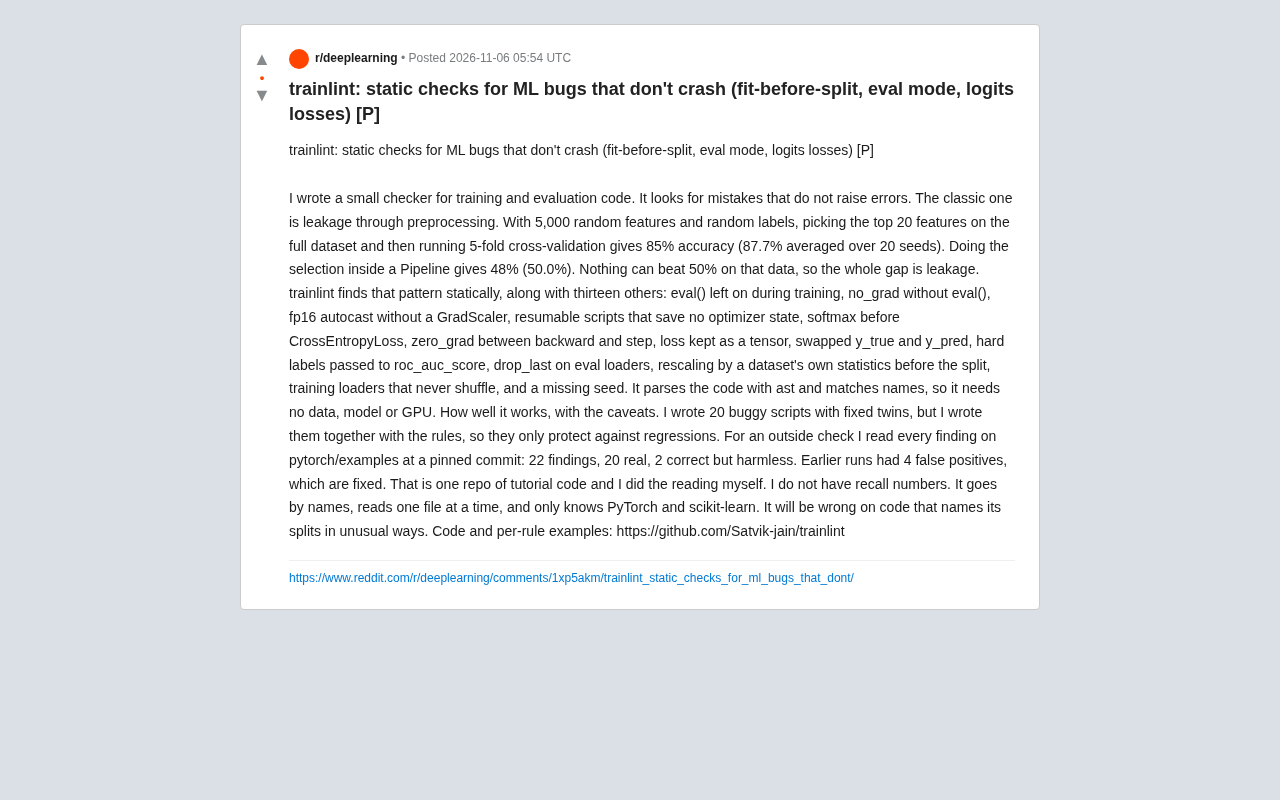
数据泄漏:最经典的静默 bug
作者用一组直观的实验说明了问题的严重性:在 5,000 个随机特征、随机标签的数据集上,如果先在完整数据上挑选 top 20 特征,再做 5 折交叉验证,准确率能到 85%(20 个随机种子平均 87.7%)。而把特征选择放进 Pipeline 内部后,准确率回落到 48%(平均 50.0%)。
随机标签上任何模型的理论上限就是 50%,所以这 35 个百分点的差距全部来自泄漏。trainlint 能静态识别这种「先在全量数据上做预处理、再划分数据集」的模式,这是它检测的第一个规则,也是最容易造成误导性实验结论的一类错误。
交叉验证中的数据泄漏机制:当特征选择、标准化、缺失值填充等预处理步骤在划分训练集与验证集之前、于全量数据上执行时,验证折的统计信息会通过预处理参数"渗透"进训练过程。以特征选择为例,若用包含验证折标签的全量数据挑选与目标最相关的特征,被选中的特征本身就携带了验证集的信息,模型在验证时相当于"见过答案"。正确的做法是把预处理封装进 Pipeline,使其只在每个训练折上 fit、在对应验证折上 transform。衡量泄漏的直观标尺是:在纯随机标签上,任何无泄漏模型的期望准确率都是 50%,一旦显著高于该基线,几乎必然存在信息泄漏。
十三条规则覆盖训练与评估陷阱
除了 fit-before-split,trainlint 还检查另外十三类问题,大致可以分为几组:
- 模式切换类:训练时忘记调用
model.train()导致 eval 模式残留;用了no_grad却没切到 eval;fp16 autocast 缺少 GradScaler。 - 损失函数类:在 CrossEntropyLoss 之前手动加 softmax;把 loss 保留为 tensor 而非标量;把 y_true 和 y_pred 顺序传反;把硬标签传给 roc_auc_score。
- 训练循环类:在 backward 和 step 之间调用 zero_grad;评估用的 DataLoader 设置了 drop_last;训练 DataLoader 从不 shuffle。
- 工程卫生类:可恢复训练脚本没有保存 optimizer state;缺少随机种子。
这些规则的共同点是:代码都能跑通,甚至 loss 曲线看起来也正常,但训练结果的可靠性已经受损。
PyTorch 的 train/eval 模式与 torch.no_grad() 是两套独立机制:model.train() 与 model.eval() 控制的是 Dropout 是否生效、BatchNorm 是否使用当前 batch 的统计量并更新滑动均值;而 torch.no_grad() 只关闭梯度计算以节省显存。评估时若忘记 model.eval(),Dropout 会继续随机丢弃神经元、BatchNorm 会持续更新统计量,导致指标波动且不可复现;反之训练时残留 eval 模式会让正则化失效。因此"用了 no_grad 却没切 eval"是典型的静默错误——代码能跑、loss 也下降,但评估结果不可信。
混合精度训练为何需要 GradScaler:fp16 的最小正规数约为 6e-5,许多梯度值在此量级以下会直接下溢为零,使参数停止更新。GradScaler 在反向传播前把 loss 放大一个动态系数,让梯度落入 fp16 可表示范围,在 optimizer.step() 前再缩放回去;若缺少它,训练可能看似正常却在部分层"学不动"。
静态分析的能力边界
trainlint 基于名称匹配和单文件解析,这意味着它的判断依赖命名习惯。作者坦承了几点局限:只支持 PyTorch 和 scikit-learn;如果代码用不寻常的方式命名划分变量,可能漏报或误报;没有召回率数据。
在准确率方面,作者做了两类验证。内部测试是 20 个带 bug 的脚本与修复版本配对,但由于规则和测试用例是一起写的,只能防回归。更有说服力的是外部验证:在固定 commit 的 pytorch/examples 仓库上,工具报出 22 个问题,其中 20 个是真实问题,2 个正确但无害。更早的运行中有 4 个误报,目前已经修复。
作者明确表示,这只是一个教程代码仓库、由他本人人工判读,样本有限。这种坦诚本身值得肯定——静态检查工具的价值不在于零误报,而在于用低成本捕获那些人工 review 容易滑过的模式。
静态分析(static analysis)与数据流分析的区别:静态分析指在不执行程序的前提下检查源码结构,Python 的 ast 模块把源码解析为抽象语法树,工具遍历节点即可识别"某函数在另一函数之前被调用"这类模式。trainlint 采用的是基于命名与调用顺序的模式匹配,属于最轻量的一档;而数据流分析会追踪变量在赋值、传递、别名间的实际流向,能判断某个 DataFrame 是否真的来自全量数据,但实现复杂度和误报控制难度都高得多。这也解释了工具为何依赖命名习惯、只能单文件解析:它并不真正"理解"数据如何流动,只是识别可疑的代码形状。
适用场景与局限
对于个人研究者和中小团队,trainlint 可以作为一个轻量的 pre-commit 检查,在代码进入训练集群前拦截明显的反模式。它的零依赖、不需要运行时的特性让它容易集成到 CI 流程中。
但需要清楚它的定位:这不是形式化验证,也不是数据流分析。它读不懂复杂的变量别名、跨文件的数据处理逻辑,也无法判断实验设计本身是否合理。把它当作安全网的第一层,而不是最终保障。
代码和每条规则的示例都在 GitHub 仓库 Satvik-jain/trainlint 中,作者欢迎社区反馈误报和漏报案例。
pre-commit 与 CI 集成:pre-commit 是一个在 git commit 前自动运行检查钩子的框架,开发者可在配置文件中声明工具,提交时若检查失败则阻止提交。将 trainlint 这类零依赖、无需 GPU 的检查接入 pre-commit 或 CI,成本极低,能在代码进入训练集群前拦截明显问题。需要注意其定位:静态规则的"误报"(报出实际无害的问题)会消耗信任,"漏报"(放过真实 bug)则留下隐患,因此这类工具通常作为人工 review 与运行时校验之前的第一道低成本过滤网,而非正确性的最终保证。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。