#模型训练
共 21 篇相关文章
OpenAI停止用实时互联网训练AI模型,称存在重大风险
OpenAI宣布不再使用实时互联网数据训练前沿AI模型,称存在重大风险。本文分析这一策略转变背后的安全考量、工程现实及对AI行业的潜在影响。
OpenAI前沿模型训练断网:安全隔离成新常态
OpenAI宣布前沿AI模型训练不再联网,构建离线测试环境以应对 rogue hacking 事件。本文分析其安全机制、技术实现及对行业的影响。
从零构建15M参数AI:个人开发者的完整训练指南
开发者Playerdotexe从零构建15M参数AI模型的完整实践:涵盖数据准备、模型架构、训练循环与推理评估,对比自建小模型与微调大模型的优劣,为个人开发者提供端到端训练指南。

无GPU训练大模型:推理专用NPU跑通反向传播
VIDRAFT在推理专用NPU上从零预训练了46M参数语言模型VKORE-46M-NPU,损失轨迹与GPU训练相关系数达0.99。本文解析其工程方法、技术限制与实际意义。
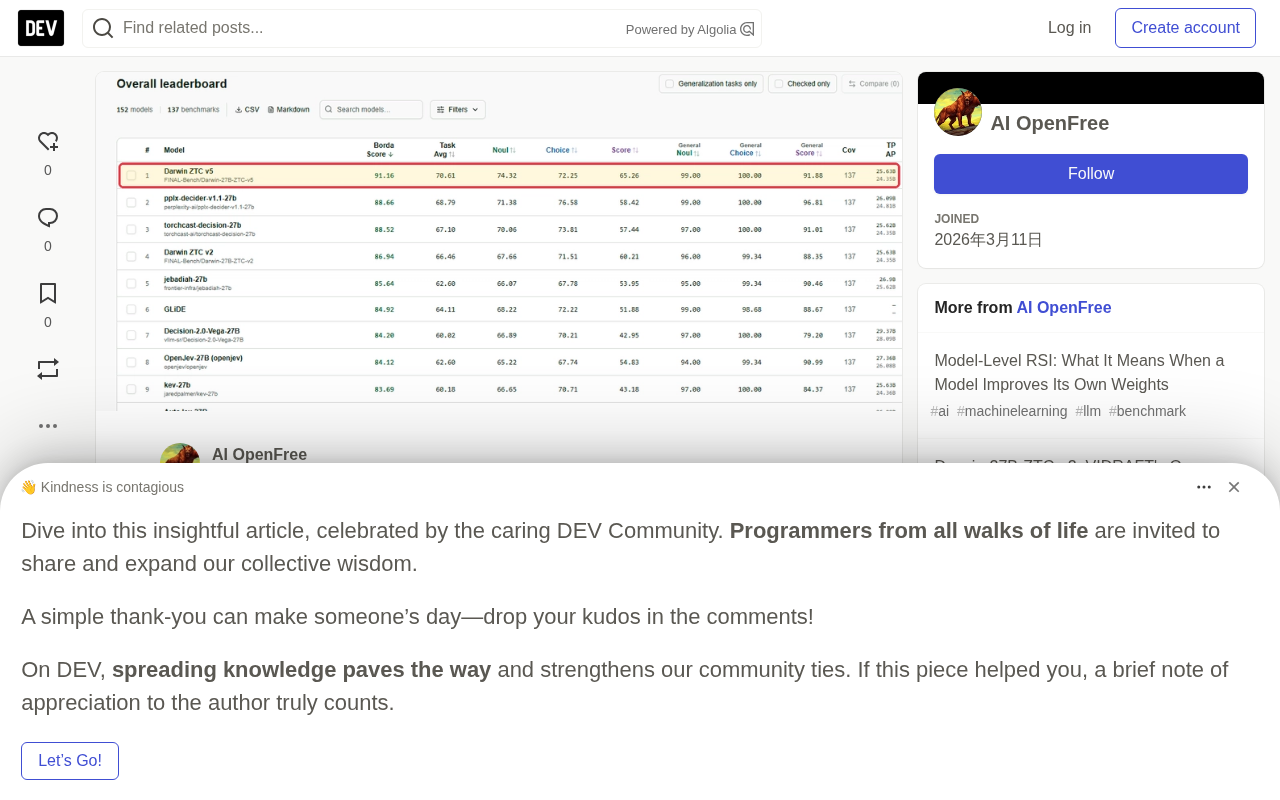
推理专用NPU也能训练Transformer:VKORE实现0.9999精度对齐
VIDRAFT推出VKORE软件加速层,在不改动芯片的前提下让推理专用NPU实现Transformer LoRA训练,精度与PyTorch达0.9999对齐,推理吞吐提升4.1倍,训练速度达同服务器CPU的170倍。

模型级RSI:当AI开始改进自身权重意味着什么
模型级RSI(递归自我改进)指的是模型在没有人类标注的情况下改进自身权重。本文梳理自我改进的五个阶段、避免自欺的三条规则,以及如何正确解读公开排行榜成绩,区分真实进步与数据泄漏。
设了随机种子却训出不同模型?PyTorch可复现性真相
设置了随机种子,训出来的模型却不一样?本文通过 ResNet18 实测揭示 PyTorch 可复现性的真相:浮点运算与 GPU 并行调度导致训练从第 1 步就分叉,并给出 use_deterministic_algorithms 的修复方法与仅 16% 的真实性能开销。

Unsloth 0.1.900 更新:Laya 决策模型与统一媒体库上线
Unsloth 发布 v0.1.900 版本,新增 Laya 决策模型支持、统一媒体库与文档查看器,图像视频生成提速约 4.5 倍,并带来大量 Apple Silicon 与训练推理优化。
Fireworks推出ARCv3压缩器:BF16权重更新体积近乎腰斩
Fireworks推出ARCv3压缩器,可将BF16权重更新体积压缩近50%,让跨区域强化学习训练更具可行性,并保持rollout采样的策略时效性。适用于使用自有训练器搭配Fireworks rollout的团队。
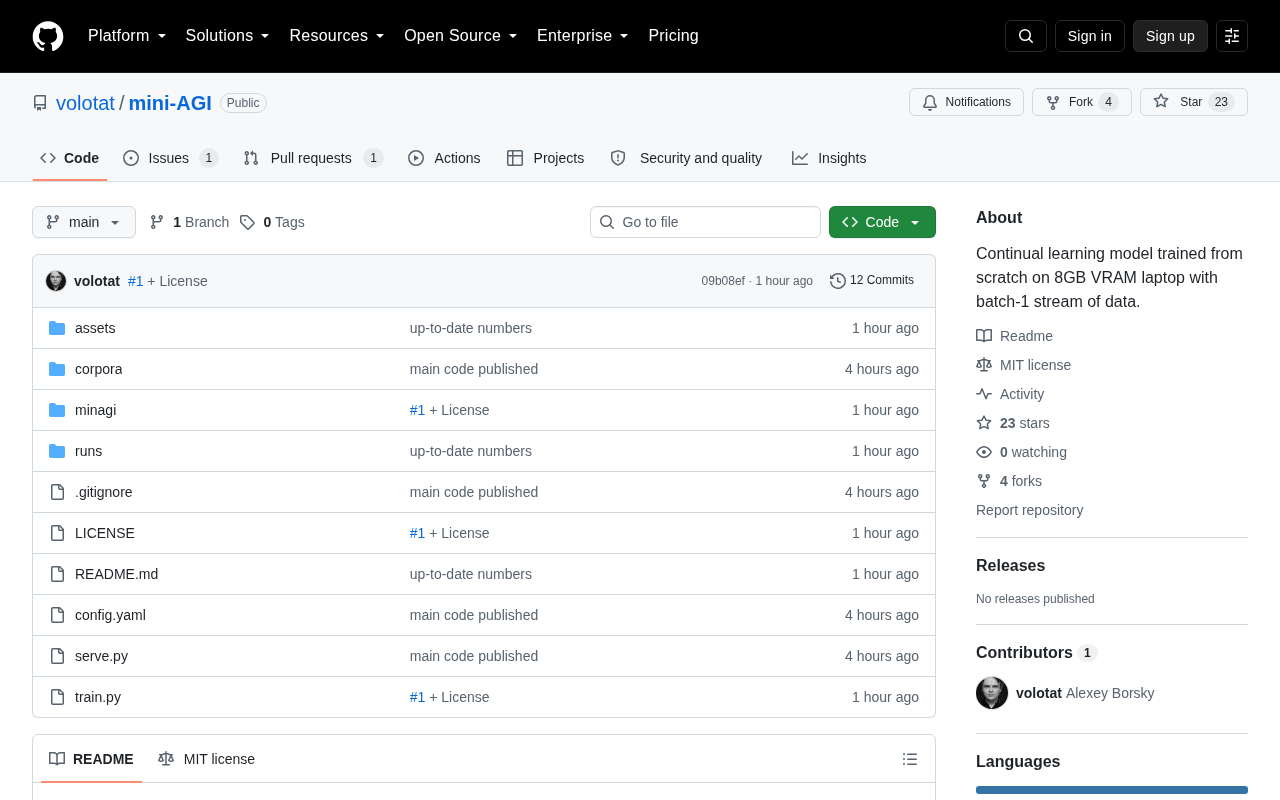
Mini-AGI:8GB显存从零训练的动态持续学习模型
Mini-AGI 是一个开源项目,主打在 8GB 显存的消费级 GPU 上从零训练具备动态持续学习能力的模型。本文解析其技术方向、持续学习原理及应给予的理性预期。
文生图模型训练提速3.6倍:技术路径与意义解析
文生图模型训练速度提升3.6倍引发关注。本文解析扩散模型训练加速的可能技术路径、对行业的潜在影响,以及为何需要更多基准验证,帮助读者理性看待AI训练效率优化。

Fireworks Lab 携手 Genspark 共研 RL 算法:100+ 实验揪出模型"刷分"行为
Fireworks Lab 与 Genspark 合作开发强化学习算法,在前沿级基础设施上运行 100+ 实验,通过轨迹审查捕捉模型刷分行为。本文解析 RL 奖励工程与反 reward hacking 的工程实践。
Cosine AI用生产代码训练Lumen模型,成本效率超GPT-5.5三倍
Cosine AI 用真实生产代码训练专用编程模型 Lumen Outpost,针对 Fortran、Verilog 等通用模型难以处理的语言,在每次成功任务成本上超过 GPT-5.5 三倍以上,整套管线运行在 Fireworks Training 平台。
 深度解读
合成数据是解药还是毒药?AI训练数据枯竭的破局之道
互联网数据即将见顶,合成数据成为AI模型训练的必然选择。本文深入分析合成数据的模型崩溃风险、三条安全使用铁律,以及从资源依赖到数据工程能力竞争的范式转变。
 教程攻略
Qwen3-0.6B微调入门:大模型基础概念与微调方法论详解
从大模型三大核心特征讲起,系统梳理Qwen3-0.6B微调所需的基础知识,包括大模型与应用软件的区别、国内外主流模型对比、微调价值分析,以及从原理到实操的完整学习路径。
 科技前沿
Hugging Face开源Agent生态全解:从本地部署到AI自动训练
深度解析Hugging Face开源Agent生态系统:开源模型已追平闭源表现,本地Agent部署方案对比(Hermes/LLama/Plandex),Skills系统实现对话式自动训练模型,MCP集成实战案例,一文掌握AI Agent开发全链路。
 教程攻略
Unsloth教程:本地微调大模型省显存提速5倍
详解Unsloth开源工具如何通过LoRA优化和Web UI界面,让消费级显卡也能高效微调Gemma 4、Qwen3、DeepSeek等主流大模型,训练速度提升2-5倍,显存降低50%-70%。
 教程攻略
Unsloth教程:本地微调大模型速度提升数倍,显存节省60%
Unsloth是GitHub 63K星标的开源大模型微调工具,支持Gemma 4、Qwen3、DeepSeek等模型。通过底层内核优化实现训练加速数倍、显存大幅降低,消费级GPU即可完成微调,提供Web UI图形界面,适合个人开发者和企业私有化部署。

