AI圈爆料周:GPT-6.5泄露、Claude新模型与MiniMax性价比

本周AI圈爆料密集:OpenAI新模型线索、Anthropic能力预览、Gemini早期检查点失望、MiniMax低价模型冲击市场。
本周AI圈信息密集,呈现两条主线。一是头部厂商下一代模型发布前兆:神秘网站源码现GPT-6.5引用但可信度存疑,微软评估配置中GPT-6.1 Tera被视为更可靠线索;Anthropic新模型据称能识别bug背后的整类问题并主动询问;Google Gemini 4 Carbon早期检查点编码表现令人失望。二是中国模型以极致性价比冲击市场:MiniMax M3.1 Flash每百万输入Token仅15美分,自动化基准得分62%超Claude Opus 5和GPT-5.6 Sol,速度超每秒200 Token。此外,OpenAI强调旧编程语言现代化能力,智谱Zcode引入多智能体工作流,Kimi K3.1泄露四个推理层级,NVIDIA通过软件优化在Kimi K3上实现每秒423 Token,Anthropic推出开源安全扫描计划。
本周AI圈爆料密集,从GPT-6.5的蛛丝马迹到中国模型的价格战,信息量巨大。
最近一周,AI社区被一系列泄露、传闻和正式发布搅得热闹非凡。从OpenAI下一代模型的疑似踪迹,到Anthropic新模型的能力预览,再到中国厂商MiniMax以极低成本推出的Flash模型,几乎每条消息都值得单独讨论。本文基于B站UP主“AI圈”的视频内容,梳理其中最关键的信息,并加入适当分析。
GPT-6.5与GPT-6.1 Tera:泄露还是巧合?
视频首先提到一个神秘网站openside.lo,其HTML源码中被发现包含“6.5”的引用,同时有一个指向旧金山时间11月1日上午10点的倒计时。这个日期恰好与OpenAI的“28天发货承诺”第28天吻合,因此引发猜测:OpenAI可能以一款重磅新模型为这一系列发布收官。
但UP主也指出一个重要疑点:该网站9月23日的存档显示,它原本是一个待售的独立OpenAI恶搞网站。因此这并非官方信息,可信度存疑。
更值得关注的是另一条线索:据报道,微软的评估配置中出现了GPT-6.1 Tera的引用,共有18项配置从GPT-5.6 Tera升级至GPT-6.1 Tera。UP主认为,这比网站域名更有说服力,因为涉及微软评估基础设施的实际代码改动。
HTML源码与倒计时线索:网页的HTML源码中有时会嵌入开发者注释、数据属性或未渲染的脚本变量,这些内容虽不直接显示给用户,却可能泄露内部项目代号、版本号或计划时间。openside.lo网站源码中出现“6.5”引用,结合指向旧金山时间11月1日上午10点的倒计时,被社区解读为OpenAI新模型发布线索。但需注意,源码可被任何人修改,且该网站历史存档显示其原为恶搞网站,因此此类“泄露”的可靠性通常较低。
微软评估配置:微软等云厂商在内部会维护模型评估配置列表,用于测试不同模型的性能、成本与集成兼容性。这些配置文件(如JSON或YAML)中的模型标识、版本号和参数设置,往往反映厂商正在对接或评估的模型。报道称微软评估配置中出现“GPT-6.1 Tera”引用,且有18项配置从GPT-5.6 Tera升级,这类基础设施代码改动比公开网站线索更难伪造,因此被视为更可信的发布前兆。
Anthropic新模型:不止修Bug,还能识别整类问题
据The Information报道,Anthropic正准备发布一款新模型,很可能就是Fable 5.5(或Fable 5.1)。视频引用匿名测试者的说法称,该模型在推理、直觉和理解用户真实需求方面明显更强。
一个具体例子是:当你用Claude代码让它修复某个bug时,新模型不仅修复单个问题,还能识别出该bug属于更大的底层问题,并主动询问你是否希望处理整类问题。UP主认为,这对自主编程智能体意义重大,因为当前模型通常需要用户明确指定修复目标,而能推断潜在意图的模型将带来完全不同层次的协助。
Gemini 4 Carbon:早期检查点表现令人失望
Business Insider此前报道称,Google内部测试的Gemini新检查点代号Carbon,编码能力可与Claude Opus 5.5相比。但UP主实测了两个不同检查点(Carbon B和Carbon Z)后表示,结果相当失望。
他声称,与Opus 5.5相比,这些检查点在编码任务上完全不在同一水平;甚至与Google现有的Gemini模型相比,也几乎注意不到有意义的改进。Carbon检查点稍快一些,但实际编码质量反而更差。UP主认为,声称其编码性能达到Opus 5水平的说法“绝对是假的”,Google可能还需要好几个月才能达到那个水平。
不过他也承认,这些是早期检查点,随着时间会大幅改善。
MiniMax M3.1 Flash:价格极低,基准测试亮眼
来自中国的MiniMax正式发布了M3.1 Flash,此前霸榜的神秘模型SpaceBunny Alpha被确认为其早期版本。该模型处理速度超过每秒200个Token,比之前的M3模型快近3倍,成本降低约70%。
定价方面:每百万输入Token 15美分,每百万输出Token 60美分,缓存输入Token低至每百万1.5美分。相比之下,Claude Opus 5每百万输入Token收费5美元、输出25美元;GPT-5.6 Sol输入4美元、输出20美元。
基准测试中,M3.1 Flash在自动化基准上得分62%,而Claude Opus 5为50.3%,GPT-5.6 Sol为45.8%。在DeepSuite上,MiniMax报告了74%的得分。UP主强调,基准测试不能说明一切,但该模型表现确实令人印象深刻。
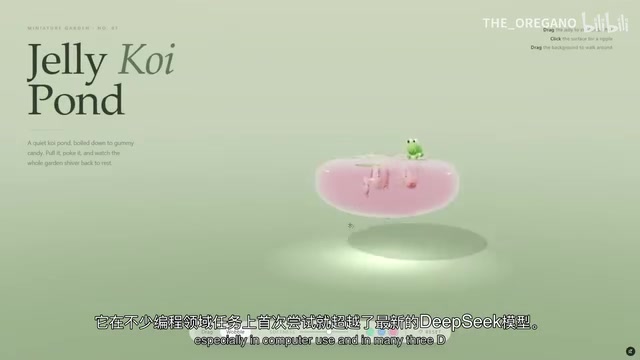
在一项复刻特斯拉Roadster警车追逐场景的对比测试中,MiniMax仅花费2.34美元完成任务,而DeepSeek广告花费约3.07美元,成本便宜约24%。另一项为硬件设备发布创建落地页的测试中,MiniMax完成仅花1美分,而Opus 5需1.22美元,便宜近88倍,速度还快4倍。
UP主综合多个基准和提示测试后认为,M3.1 Flash目前综合排名第18,对于一款Flash模型来说相当惊人。此外,MiniMax还在开发更强的Pro版本,据路透社早期报道,该模型或拥有2.7万亿参数。
Token定价与成本结构:大模型API通常按处理的Token数量计费,输入Token指用户发送的提示词(包括上下文),输出Token指模型生成的回复。缓存输入Token(Cached Input Token)指对重复使用的提示词前缀进行缓存后再次调用时享受的折扣价,可大幅降低多轮对话或固定系统提示的成本。每百万Token的美元单价是行业通用比较口径,MiniMax M3.1 Flash的15美分/百万输入Token和60美分/百万输出Token,仅为Claude Opus 5(5美元/25美元)的约3%和2.4%,属于极低价格带。
自动化基准(Agentic Benchmark):这类基准测试模型在自动化任务中的综合表现,如多步骤工具调用、代码执行、网页操作等,而非单轮问答。得分通常以百分比表示任务完成率或正确率。M3.1 Flash在自动化基准上得分62%,高于Claude Opus 5的50.3%和GPT-5.6 Sol的45.8%,但需注意基准测试的设计、数据污染和任务分布会影响可比性,且低价模型可能在复杂推理或长上下文任务中存在未覆盖的短板。
其他值得关注的动态
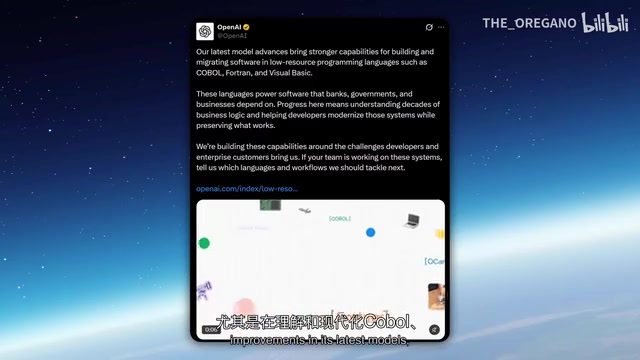
OpenAI强调旧编程语言现代化能力。 OpenAI表示其最新模型在理解COBOL、Fortran乃至Visual Basic等老旧代码库方面显著更强,能帮助开发者迁移旧代码而不破坏现有功能。UP主认为这是AI编程代理最被低估的应用。
智谱Zcode工作流模式。 智谱的编程平台Zcode获得大规模更新,引入工作流模式,允许开发者同时编排多个AI智能体。一个演示展示了十个子智能体独立工作并实时追踪进度。
Kimi K3.1泄露。 据报道,Kimi K3.1在API请求中出现,7分钟后关闭。泄露信息显示其使用与Kimi K3相同的Tokenizer和聊天格式,但引入4个推理层级(低、中、高、最高,默认最高),支持图像输入。
NVIDIA推理优化。 NVIDIA的CentML团队在2.8万亿参数的Kimi K3大模型上实现了每用户每秒423个Token,在相同架构上速度提升1.68倍。这得益于用CUDA DSL编写的解码内核和Mega Kernel Fusion技术,约12000行高度优化代码,无需额外硬件即可从现有GPU榨取更多性能。
Dreamlabs机器人基础模型Dream 1。 Dreamlabs结束隐身模式,推出Dream 1,可控制从未遇到过的机器人,在陌生环境中完成未训练过的操作。使用Dream API的起步价仅为每小时3美元。
Anthropic推出OSS Scanner。 该计划利用其最强大模型为关键开源项目提供免费定期安全扫描,每项发现都包含概念验证和建议补丁。
CUDA DSL与Mega Kernel Fusion:CUDA DSL指基于CUDA的领域特定语言(如NVIDIA的TileLang或类似工具),允许开发者用更高层抽象编写GPU内核,再编译为高效机器码。解码内核(Decoding Kernel)是推理过程中负责逐Token生成的核心计算模块,其效率直接决定吞吐量。Mega Kernel Fusion(巨型内核融合)将多个细粒度GPU操作合并为单个大内核,减少内核启动开销和显存读写次数,从而在不增加硬件的情况下提升每秒Token数。NVIDIA CentML团队用约12000行高度优化代码,在2.8万亿参数Kimi K3上实现每用户每秒423个Token、同架构提升1.68倍,正是软件层推理优化的典型案例。
机器人基础模型(Robot Foundation Model):这类模型在大规模机器人操作数据上预训练,学习通用的感知-动作映射,使其能泛化到未见过的机器人本体和陌生环境。Dreamlabs的Dream 1宣称可控制从未遇到的机器人并完成未训练过的操作,其难点在于跨本体迁移(不同关节数、传感器配置)和零样本任务泛化。按小时3美元的API起步价,意味着机器人策略正以云服务形式提供,降低了机器人应用的门槛。
小结
本周信息呈现两条主线:一是头部厂商下一代模型的发布前兆(GPT-6.5传闻、Claude新模型、Gemini Carbon),二是中国模型以极致性价比冲击市场(MiniMax M3.1 Flash)。需要提醒的是,泄露和传闻存在不确定性,部分早期检查点表现不代表最终发布质量。建议读者关注官方信息,并对基准测试结果保持审慎。
相关推荐

Microsoft Fabric数据库Agent实战:从被动救火到智能侦探
深入解析Microsoft Fabric数据库Agent的功能与配置方法:如何启用、支持的监控场景、阻塞问题演示,以及从被动响应到自主运维的产品路线图。
Zendesk用ChatGPT Enterprise打造千名日活销售Agent
Zendesk向全员开放ChatGPT Enterprise,员工自行构建约600个应用,其中销售扩张智能体日均约1000名活跃用户。本文分析其如何将内部数据转化为销售机会,以及“不要等待”的落地策略。

谷歌发布Gemini 4 Carbon:最强模型首发主打网络安全
谷歌发布Gemini 4 Carbon,称其为最强模型,主打网络安全能力,第三方综合排名以59分居首但领先优势仅一两分。本文解析其安全测试表现、分阶段开放策略、Token定价及自测与第三方测试在幻觉问题上的分歧。