AI认得出大笑奶龙吗?实测11个模型的奶蛙Bench

UP主自制奶蛙Bench评测11个视觉模型,揭示AI认梗与画梗的共性短板。
B站UP主用自制“奶蛙Bench”评测了11个视觉模型,分为看图认梗和照着画两部分。认梗环节,八个模型仅三个认出“奶龙”,无一提到“变异奶龙”;核心榜GPT-6 Astra以63分居首,Gemini 3.8 Flash垫底。画梗环节,仅给名字时ChatGPT和Gemini均约30分,补详细描述或参考图后升至七八十分,但参考图也会导致机械迁移(如给猫套黄皮套)。评测虽因单次运行和评委为主观模型而存在随机性,但暴露了模型能描述画面却难抓迷因文化坐标、能模仿外形却易丢失结构逻辑的共性短板。
一个表情包引发的评测基准
刷到那只弯腰捂肚子、眯眼张嘴的“大笑奶龙”,你会心一笑。但如果把这张图丢给AI,它认得出吗?B站UP主用一套自制的“奶蛙Bench”,实测了11个视觉模型,结果比想象中更有意思。
先交代背景:大笑奶龙并非官方形象,它源自星野平台上一个名为“奶龙”的AI智能体头像——一只AI生成的变异奶龙。后来这个形象衍生出完整表情包家族,也被称作“变异奶龙”或“奶蛙”。UP主因此设计了两部分评测:看图认梗和照着画,并且要求评委回避给自家模型打分,以降低厂商偏向。
认梗环节:看得清,不等于懂得
第一轮把大笑奶龙丢给八个视觉模型,场面一度很混乱。有模型说这是《爆笑虫子》里的蝗虫,有模型给它编了个“狂笑小黄人”的外号,还有模型觉得像某部俄罗斯儿童动画但不敢确定。八个模型里只有三个认出了“奶龙”,却没有一个提到“变异奶龙”或“奶蛙”。
这说明一个关键问题:模型能识别图像内容,却缺乏对网络迷因演变脉络的认知。梗的识别依赖训练数据里对社区语境的覆盖,而表情包这类快速衍生的亚文化符号,恰恰是模型知识更新最薄弱的环节。
核心榜:Astra第一,但只有63分
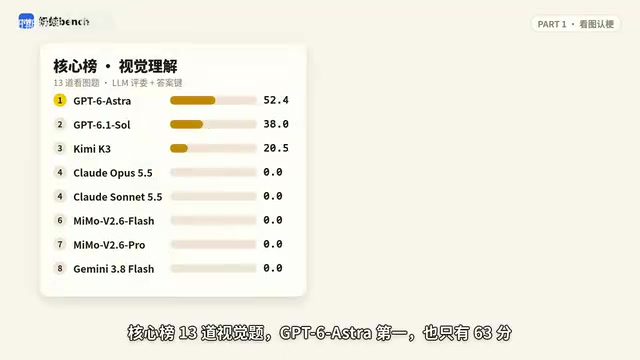
13道视觉题的核心榜上,GPT-6 Astra排名第一,得分63分;Gemini 3.8 Flash垫底。换句话说,即便最强模型,在这类“认梗”任务上也刚过及格线。
奶Hobb榜:高分背后有问号
换成“奶Hobb”提及的24张图版本,规则是先判断是不是变异奶龙,再答对姿势和表情才算全对。Gemini一下冲到并列第二,Astra拿到96分。但UP主也指出:这套答案是Astra自己标注的,它的高分得打个问号。两套题口径不同,但至少说明——看得清不等于懂得。
视觉语言模型(VLM) 是一类能同时处理图像和文本输入的多模态模型,典型代表包括 GPT-4V、Gemini 系列等。它们通常由视觉编码器(如 ViT)将图像转换为特征向量,再通过投影层对齐到语言模型的空间,最后由大语言模型生成描述或回答。VLM 在图像分类、目标检测、图像描述等任务上表现优异,但其知识主要来自训练数据中的图文对,对训练时未见过的、快速演变的网络迷因往往缺乏认知。因此,VLM 能准确描述“黄色、弯腰、大笑的卡通形象”,却难以将其与特定社区中“变异奶龙”的戏称关联起来。
画梗环节:从名字到参考图,差距在哪
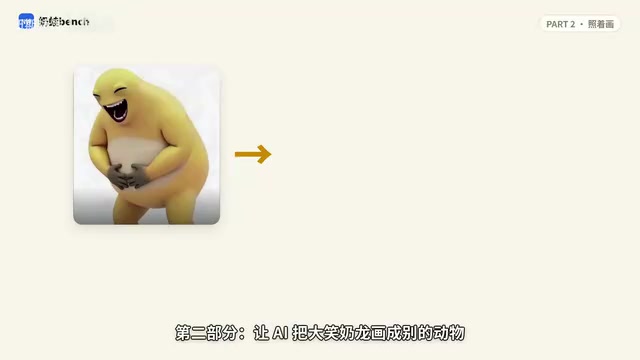
第二部分要求AI把大笑奶龙画成别的动物:猫、熊猫、青蛙、长颈鹿、章鱼、大象。提示词分五档:中文名、英文名、简略描述、详细描述,以及直接给参考图。
只给中文名时,Gemini给猫装上了一对龙翅膀;只给英文名时,它交出一张表情包大杂烩。ChatGPT在只给名字时画得挺可爱,但更像普通的大笑小动物,两家都只有30分上下。补上详细描述或参考图后,分数能涨到七八十分。
参考图也会“翻车”
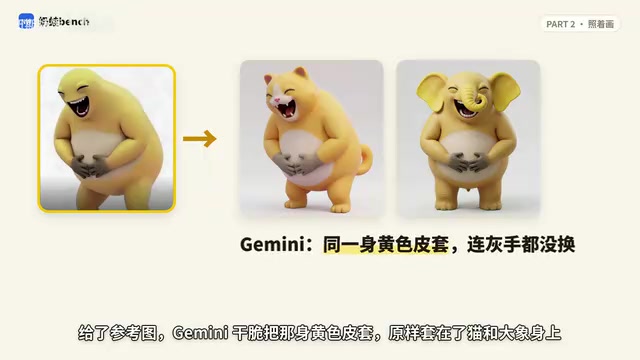
有意思的是,给了参考图之后,Gemini干脆把那身黄色皮套原样套在了猫和大象身上——迁移是迁移了,但没真正理解形象结构。
ChatGPT有一张图被内容服务拦截,画的是一只笑弯了腰的熊猫。最终得分ChatGPT 60分,Gemini 56分。还有一个不计分的“家事”环节:把奶蛙的各种表情迁移到猫和青蛙身上,目前仍是初稿。
风格迁移 指在保持图像内容结构不变的前提下,将一种艺术风格应用到另一张图像上。在生成式 AI 中,常见方法包括基于参考图的图像生成(如 IP-Adapter、ControlNet)和文本引导的风格控制。评测中要求模型将“大笑奶龙”画成其他动物,实质是内容与风格的双重迁移:既要保留奶龙的表情和姿态特征,又要将其融入目标动物的形态。理想情况下,模型应理解形象的结构逻辑(如弯曲的腰部、夸张的嘴部),而非简单复制颜色或纹理。参考图方法虽然能提升相似度,但若模型缺乏对结构的深层理解,就容易出现“黄皮套猫”式的机械迁移。
怎么看待这份成绩单
每格只跑一次、评委也是大模型、几分的差别其实很随机,UP主自己也提醒“别太当真”。但这份评测仍然有参考价值:它暴露了当前视觉模型在网络迷因理解和风格迁移上的共性短板——能描述画面,却难以抓住一个梗的文化坐标;能模仿外形,却容易丢失形象的结构逻辑。
代码和完整评测结果都已公开,想验证的话,你也可以拿自己的模型跑一跑。
相关推荐

PPO算法破解移动沙发难题,重建Gerver最优解
开发者利用PPO强化学习算法成功重建移动沙发问题的Gerver最优解,展示了AI在几何优化难题中的潜力。文章详细介绍了问题背景、方法、结果及局限性。

PPO算法破解移动沙发难题,重建经典Gerver沙发
探索PPO算法如何通过强化学习重建移动沙发问题的经典解Gerver沙发,展示AI在几何优化和数学发现中的潜力与局限。

Qwen4-27B 意外曝光:vLLM PR 泄露新模型线索
Reddit 社区发现 vLLM XPU 仓库 PR 疑似泄露 Qwen4-27B 线索,涉及 KV cache 规格与 Intel 平台适配,本文梳理 PR 信息、社区反应及对开发者的参考价值。