#多模态模型
共 32 篇相关文章
Liquid AI发布LFM3:6款2B级开源多模态模型
Liquid AI发布LFM3系列,一次推出6款2B级开源权重多模态模型,覆盖文本、视觉、音频、omni与决策。LFM3-1.7B采用三混合骨干,支持256K上下文,4-bit量化下约1GB。

多模态大模型分阶段训练:能力互斥还是协同进化?
一项针对84亿参数多模态模型的研究发现,分阶段训练中数学蒸馏会覆盖金融知识,领域阶段更多是修复而非安装能力,最佳检查点取决于任务,对检查点保留和调度策略提出新挑战。

UniWALM:统一世界-动作-语言模型如何突破机器人控制瓶颈
UniWALM 提出统一世界-动作-语言模型,在单一 Transformer 骨干内同步生成视频、动作和语言,无需外部规划器。在 RMBench 记忆任务上达 34.5%,真实物品查找任务成功率从 11.1% 提升至 61.1%。
VICE:用视频-语言蕴涵实现概念级视频相似度估计
VICE 提出双分支视频-语言蕴涵框架,利用大型多模态模型的单视频理解能力实现概念级视频相似度估计,在 ConViS-Bench 和 StepDiff 基准上超越同时处理两段视频的模型。

Glimpse视觉模型价格仅为GPT-6 Astra的6%,自家榜单却输6项
Elorian 发布视觉思考模型 Glimpse,输入价格仅为 GPT-6 Astra 的 6%,但自家 12 行基准表中输了 6 行。本文拆解完整测试数据、视觉草稿纸的计费逻辑,以及迁移前该怎么做自测。

Elorian Glimpse视觉推理模型登陆AI Gateway
Elorian 视觉推理模型 Glimpse 接入 AI Gateway,支持图像与视频输入,可跨帧追踪物体、回溯视觉证据,适用于图表分析、视频描述、视觉计数与机器人数据标注。本文介绍其能力、AI SDK 接入代码与帧率配置要点。
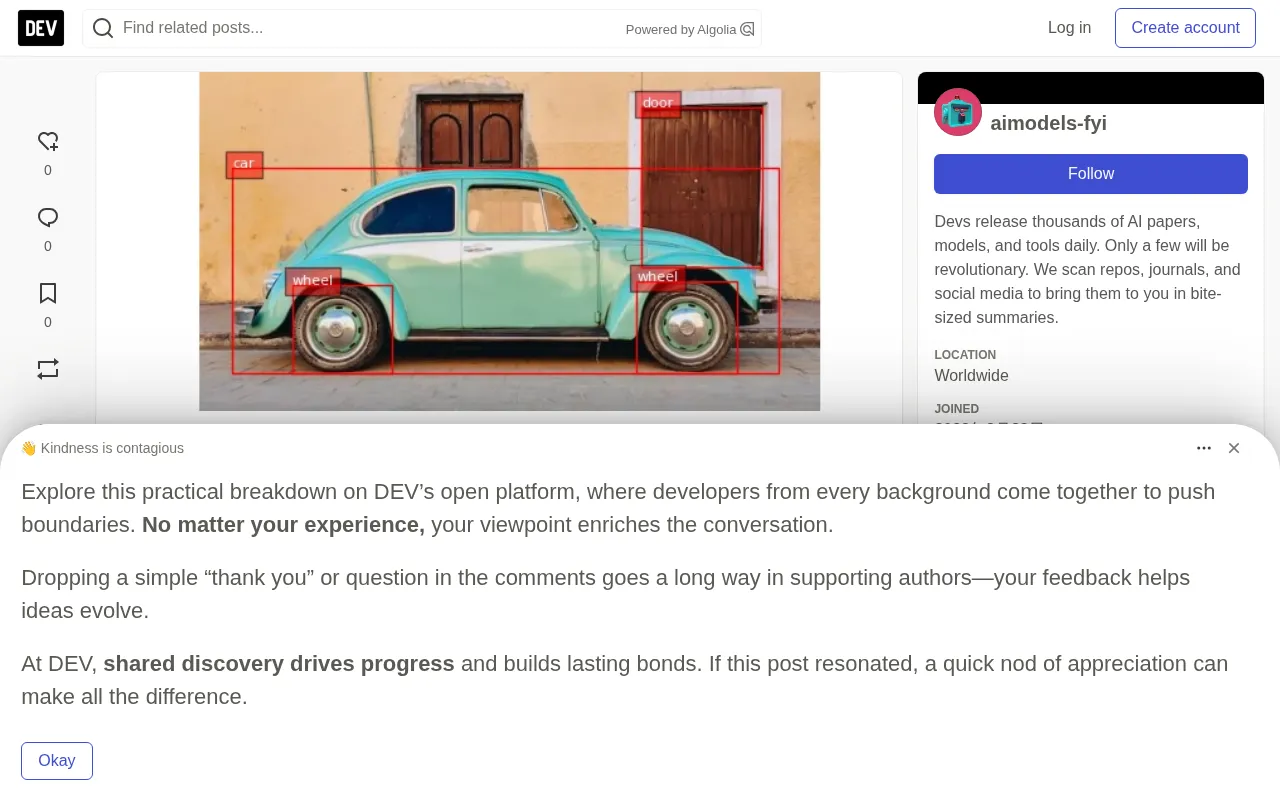
Florence-2-Large入门指南:一个模型搞定多任务视觉
Florence-2-Large 是 Lucataco 部署在 Replicate 上的多任务视觉基础模型,统一支持图像描述、目标检测、视觉定位与分割提示。本文梳理其核心能力、四类适用场景、五个关键限制,与 base、Kosmos-2、InternVL 等模型的选型对比,并附 Python 上手代码。
Elorian发布首款AI模型Glimpse:用图像推理,而非推理图像
Elorian发布首款AI模型Glimpse,采用视觉原生推理架构,据其评估在科学图表推理和短视频描述任务上超越GPT-6 Astra,探索"用图像推理而非关于图像推理"的新路径。
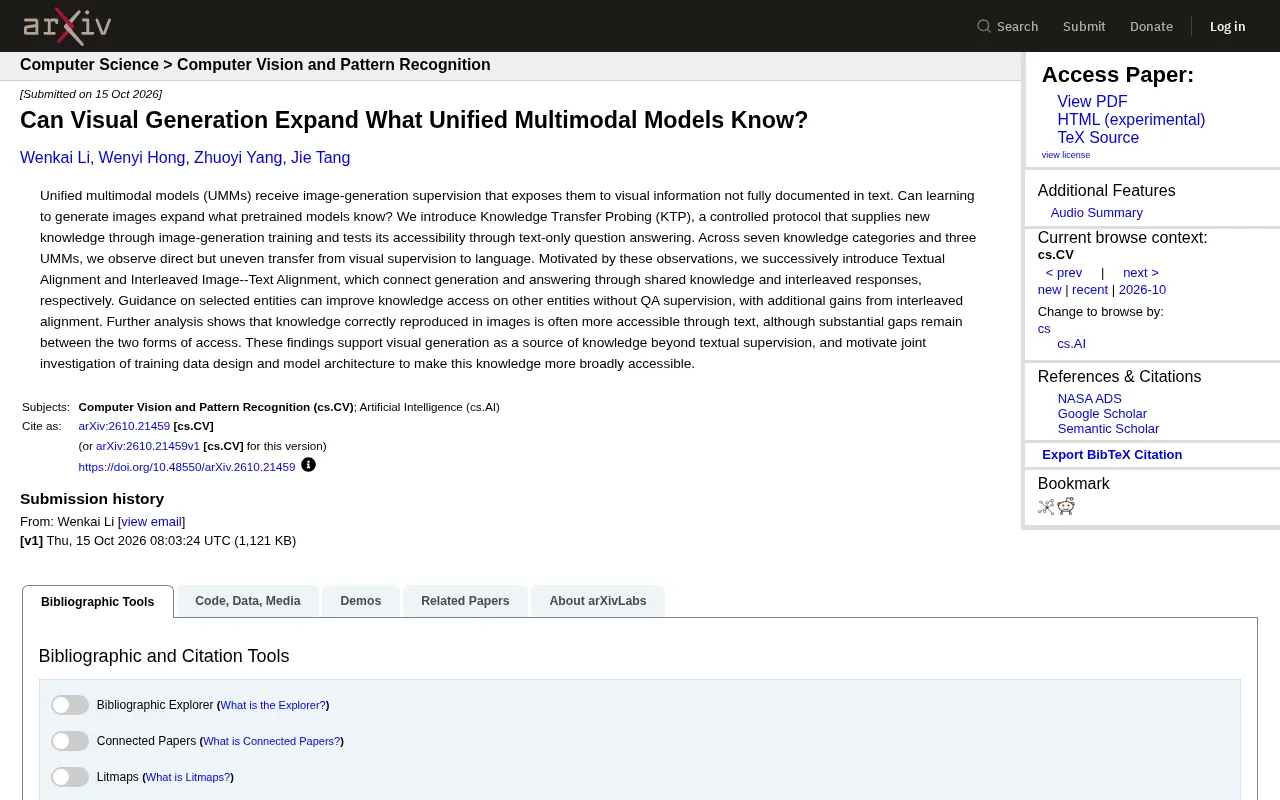
视觉生成能否扩展多模态模型的知识边界?
最新研究提出KTP协议,系统探索统一多模态模型能否通过图像生成训练获取新知识。实验覆盖七类知识和三种模型,揭示视觉监督向语言迁移的直接但非均衡路径,并提出文本对齐与交错图文对齐两种改进策略。
Liquid AI发布d1-ultra:多模态决策模型AA指数达65
Liquid AI发布d1-ultra多模态决策模型,文本图像双输入,一次前向传播输出校准概率,AA Decision Index得分65,每百万输入token仅0.042美元。
NVIDIA发布Nemotron 3.5 Super VL:120B开源多模态智能体模型
NVIDIA发布Nemotron 3.5 Super VL开源多模态智能体模型:120B参数MoE、12B激活、1M上下文、NVFP4权重可在单台DGX Spark运行,同步推出两款Bolt边缘模型。
自蒸馏空间推理:精度提升且延迟几乎不增
SpatialOPSD 通过自蒸馏将特权深度信息内化到 RGB 单次前向推理,在 Qwen3.5‑9B 上把准确率从 45.9 提升到 51.9,保留教师模型 91% 性能,同时消除外部工具调用的运行时开销,优于 SFT 与 GRPO。
Gemini 4 Argon深度实测:编程、多模态全面进化,AI自我复制引担忧
Gemini 4 Argon正式发布并全球推送,深度实测显示其在编程、多模态、3D生成方面表现强劲,编程速度与成本优于Opus 5.5,但幻觉问题仍存。同时Anthropic Fable 5.5、OpenAI GPT-6.1 Astra曝光,AI自我复制研究引发安全担忧。
NEURA推出Neuron AI:让机器人能触摸、聆听与记忆的基础模型
NEURA Robotics发布Neuron AI多模态基础模型,在VLA架构上融合触觉、声音与记忆能力,支持机器人本体运行无需云端。本文梳理其PLA架构、训练数据、部署方式及待验证的能力主张。
微软MAI模型接入Vercel AI Gateway:语音、转录与图像一站集成
微软 MAI 系列模型正式接入 Vercel AI Gateway,覆盖语音生成、实时转录与图像生成编辑,公布按模态分别计费的定价,并提供零数据保留姿态与集成路径。
Le Chonk视觉定位模型:Dense 200跑出42%超越闭源前沿
Le Chonk视觉定位模型在Dense 200基准上取得42%成绩,宣称超越前沿闭源模型。本文解读视觉定位任务难点、该成绩的技术信号及对开发者的实际价值。
Cloudflare clef-omni:不生成文本的30B开源决策模型
Cloudflare 开源 clef-omni,一个 30B 多模态决策模型,不生成文本,只输出带校准的概率。本文拆解它的原理、对比 Jev 的基准数据、音视频调用成本与本地部署门槛。

MiniCPM-V 4.7 35B-A3B:首个开源MoE多模态端侧模型
面壁智能发布 MiniCPM-V 4.7 35B-A3B,MiniCPM-V 系列首个 MoE 多模态模型,支持 iPhone 17 Pro Max 端侧 13+ tokens/s 推理,覆盖 iOS/Android/HarmonyOS 及多芯片平台。
VLM空间理解之谜:表征层面为何不如词汇先验可靠
一项新研究发现,视觉语言模型(VLM)在表征层面对空间关系的编码忠实度远低于词汇信息,即便输出评估得分很高。借助 EICS 指标与 CASP-VL 基准,研究揭示关系信息在句子聚合阶段被 EOS token 或均值池化抹除,暴露了输出评估无法察觉的系统性缺陷。
PRISM:多模态语言模型如何重塑临床预后预测
PRISM 是一个检索增强的多模态语言模型,用于临床预后预测。它结合数值 token 化、纵向 ECG 聚合与人群记忆库,在 MDS-ED 基准上取得优异表现,并揭示了结构化融合与跨机构适配的关键价值。