AI尚未准备好应对战略冲突:兵棋推演的五大失效模式
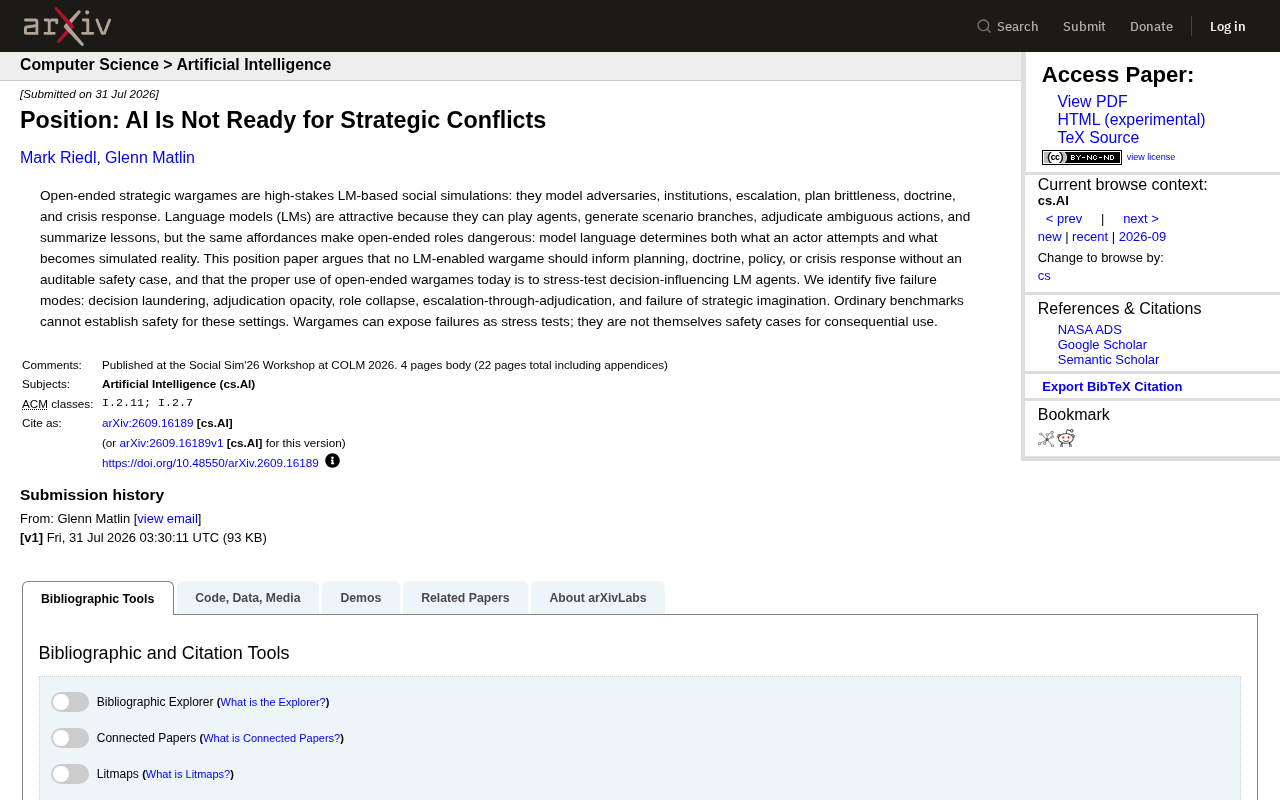
立场论文警告:LM驱动的战略兵棋推演存在五大失效模式,在缺乏可审计安全论证前不应用于实际决策。
一篇最新立场论文(arXiv:2609.16189)对语言模型在开放式战略兵棋推演中的应用发出严肃警示。论文指出,语言模型在推演中同时充当剧本作者、裁判与现实构建者,这一双重角色使其偏差和幻觉被直接固化为模拟"事实"。论文识别出五大失效模式:决策洗白、裁决不透明、角色崩塌、通过裁决制造升级、以及战略想象力的失效。作者特别强调,常规基准测试无法为高风险战略场景建立安全性保证。其建设性结论是:开放式兵棋推演的正确定位是对决策AI进行压力测试,而非直接作为影响政策与危机响应的安全论证依据。
开放式战略兵棋推演(wargame)正成为大语言模型(LM)应用的一个高风险前沿领域。这类模拟涉及对手建模、制度演化、危机升级、方案脆弱性、军事学说与危机响应等复杂因素。一篇最新的立场论文(arXiv:2609.16189)提出了尖锐的警示:任何由语言模型驱动的兵棋推演,在缺乏可审计的安全论证之前,都不应用于指导规划、学说、政策或危机响应。
为什么语言模型对战略推演既诱人又危险
语言模型之所以吸引战略模拟领域,是因为它们具备多重能力:可以扮演智能体角色、生成场景分支、裁决模糊行动,并总结经验教训。这些能力让传统上依赖大量人力的兵棋推演变得可扩展、可自动化。
然而,论文指出,正是这些能力使得开放式角色变得危险。核心问题在于:模型的语言输出同时决定了「一个行为体试图做什么」以及「什么成为了被模拟的现实」。换句话说,语言模型既是剧本作者,又是裁判,还是现实的构建者。当模型的措辞既定义行动意图、又定义行动结果时,其中的偏差和幻觉将被直接固化为模拟世界的「事实」,进而影响决策者的判断。
五大失效模式
论文识别出五种关键的失效模式,这些模式共同构成了对当前LM战略推演可靠性的质疑:
决策洗白(Decision Laundering)
人类决策者可能借助AI的「客观」外衣,为本已倾向的决策寻找背书。模型生成的分析被当作独立验证,实际上只是把主观判断「洗白」为看似中立的机器结论,削弱了对决策本身的问责。
决策洗白与认知科学中的"自动化偏见"(automation bias)密切相关。研究表明,人类在面对算法或机器输出时,往往比面对同等质量的人类建议更倾向于接受,并降低批判性审视。在高压的危机决策环境中,这一倾向尤为突出:决策者承受时间压力,而AI生成的分析报告在形式上往往显得详尽、中立,从而产生额外的说服力。这一机制使得AI辅助决策的问责链条难以厘清——当错误决策造成后果时,责任究竟归属于采纳建议的人类,还是生成建议的模型?这种问责模糊本身就是治理风险的重要来源。
裁决不透明(Adjudication Opacity)
当语言模型裁决模糊行动的结果时,其推理过程往往不可解释。为什么某次军事行动被判定为成功或失败?模型给出的裁决缺乏可追溯的依据,使得整个推演结果难以审计和复现。
角色崩塌(Role Collapse)
在多智能体模拟中,模型可能无法稳定维持所扮演对手或机构的独立立场,导致不同角色的行为趋同或混淆。这会严重损害推演对真实对抗性场景的还原度。
通过裁决制造升级(Escalation-through-Adjudication)
模型在裁决过程中可能系统性地倾向于制造冲突升级——不是因为战略逻辑,而是因为语言模型的生成偏好。这种由裁决机制引入的人为升级,可能误导人们对真实危机动态的理解。
战略想象力的失效(Failure of Strategic Imagination)
模型受限于训练数据中的既有模式,难以生成真正新颖的、突破性的战略场景。在高风险的战略博弈中,恰恰是那些「想不到」的黑天鹅情形最为致命,而这正是当前模型的短板。
兵棋推演(wargame)本身是一种有悠久历史的军事分析工具,最早可追溯至19世纪普鲁士军队使用的"克里格斯皮尔"(Kriegsspiel)。传统兵棋推演依赖人类专家扮演对手、裁决行动结果,其核心价值在于通过对抗性模拟暴露计划漏洞、检验假设。引入语言模型后,推演规模可大幅扩展——模型能在数秒内生成数百个场景分支,并自动裁决结果。但这种自动化同时移除了人类专家在传统推演中提供的情境判断与责任锚点,使得下述失效模式的影响被系统性放大。
普通基准测试无法证明安全性
论文强调了一个重要观点:常规的基准测试(benchmarks)无法为这类高风险场景建立安全性保证。传统的模型评测关注准确率、流畅度等指标,但在战略冲突模拟中,问题的核心不是模型「答得对不对」,而是模型的输出是否会以不可控、不可审计的方式塑造决策现实。
这意味着,即便一个模型在标准评测中表现优异,也不足以证明它适合参与影响政策与危机响应的推演。安全论证需要针对具体应用场景,包含对上述五种失效模式的系统性审查。
当前主流的大语言模型评测体系,如MMLU、HellaSwag、BIG-Bench等,主要衡量知识覆盖度、逻辑推理与语言流畅性。这些基准的设计假设是:存在可验证的"正确答案",且模型的任务是在封闭问题空间内逼近该答案。战略冲突模拟则根本不符合这一假设——模拟结果不存在客观标准答案,模型输出的影响通过塑造决策者的认知间接发生,危害往往在部署后才显现。这与AI安全领域所讨论的"分布外泛化"(out-of-distribution generalization)问题相互叠加:真实危机情境往往超出训练数据的覆盖范围,而基准测试对此类情境下的模型行为几乎没有预测力。
兵棋推演的正确定位:压力测试而非安全论证
论文给出的建设性结论是:当前开放式兵棋推演的恰当用途,是对「影响决策的LM智能体」进行压力测试(stress-test),而非直接用于有实际后果的决策。
这一区分至关重要。兵棋推演能够暴露模型的失效,充当发现问题的探针;但它们本身并不构成让模型投入实际应用的安全论证。作者的立场清晰而克制:用推演去检验AI的脆弱性是有价值的,但把推演结果直接当作战略决策依据则是危险的。
对于AI治理和国防科技领域而言,这篇论文提供了一个务实的框架——在拥抱语言模型带来的效率之前,先建立起可审计的安全边界。技术能力的领先,并不等同于在高风险领域的可信部署资格。
这一立场与AI安全领域"红队测试"(red-teaming)的理念相呼应。红队测试的核心逻辑是:主动寻找系统的失效边界,而非证明系统的安全性。论文作者实际上在呼吁将兵棋推演重新定位为一种制度化的红队机制——专门用于在受控环境中触发和记录语言模型的失效,为后续的安全论证积累证据。这与核武器、航空、医疗器械等高风险领域的安全认证逻辑一致:压力测试暴露问题,但通过压力测试本身并不等于获得部署许可。对AI治理而言,这意味着需要建立独立于开发者的第三方审计机制,才能在战略应用中为语言模型的可信部署提供制度背书。
相关推荐
Claude挑战循环真相:Wayfinder技能修复AI一次构建应用
解析Claude挑战循环(Challenge Loop)的运作原理与两大致命缺陷,以及如何用Matt Pocock的Wayfinder技能生成可验证规格文件,让AI代理一次性构建真实项目而非仅限游戏演示。
Claude Code 令牌耗尽?7个隐藏消耗点审计与修复指南
Claude Code 总是提前撞上令牌限制?本文拆解 Token 复合增长的底层机制,梳理从 /clear 到定时任务的七个隐藏消耗点,并澄清短提示、压缩、截图等无效省钱建议,附实用自查命令与审计方法。
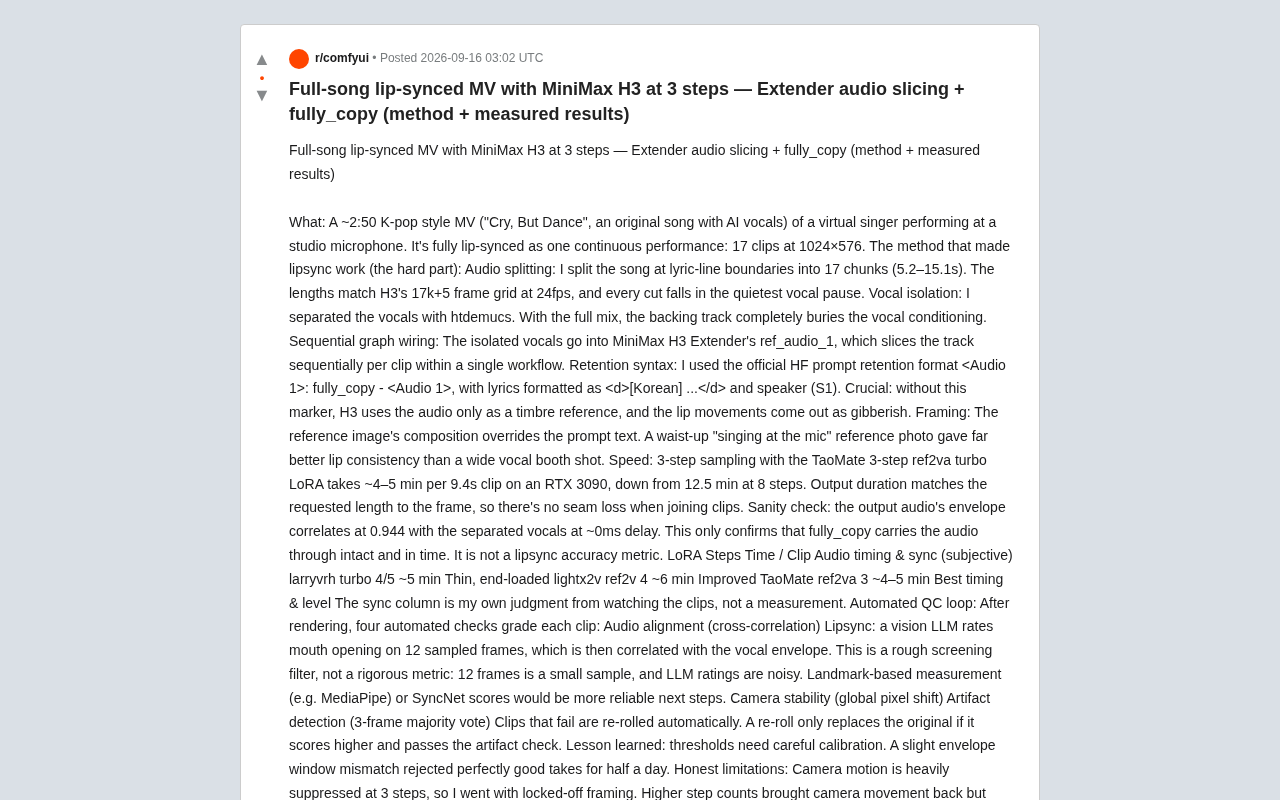
MiniMax H3实测:3步采样打造整首歌口型同步MV
一位创作者用MiniMax H3 Extender制作整首歌口型同步MV的完整实测:音频切片、htdemucs人声隔离、fully_copy保留语法、3步turbo LoRA提速,附三款LoRA对比与自动化质检方案。