AI审计90万条法国新闻标题:措辞与选择如何双重塑造舆论框架

研究将新闻框架拆解为「怎么说」与「说什么」两个可量化维度,对90万条法语标题展开迄今最大规模审计。
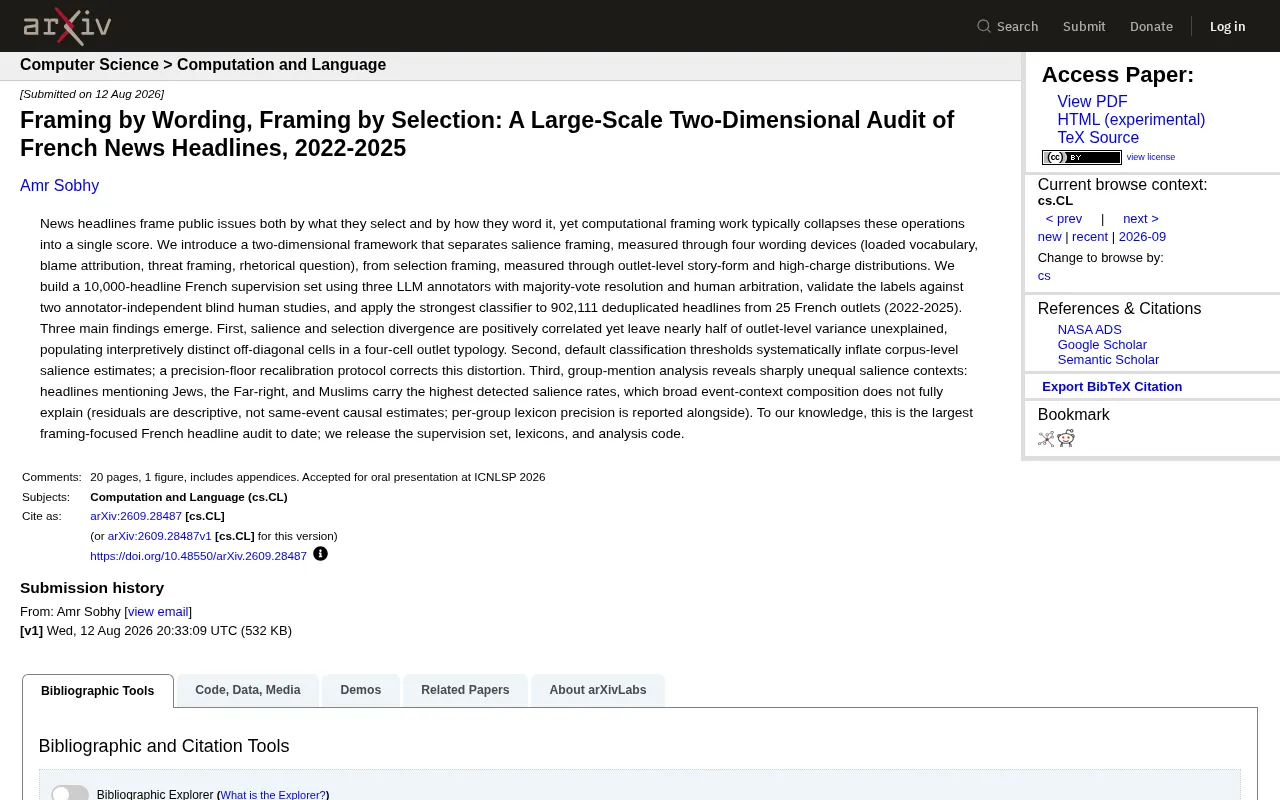
一项arXiv研究提出二维框架分析模型,将新闻框架效应明确区分为显著性框架(措辞尖锐程度)与选择性框架(选题倾向),并对2022—2025年间25家法国媒体的90万余条标题进行大规模计算审计。研究团队先用三个LLM标注器结合人工仲裁构建1万条监督数据集,再将最优分类器应用于全语料库。核心发现包括:两类框架维度仅中度相关,媒体在「用词」与「选题」上的偏离可以相当不一致;分类器默认阈值会系统性高估煽动性,需通过精确率下限协议校准;提及犹太人、极右翼和穆斯林的标题显著性比率最高,但研究者明确指出这是描述性残差而非因果结论。团队公开了数据集与代码,为计算传播学研究提供了可复现的方法论基础。
新闻标题从来不只是对事件的中立概括。它通过选择报道什么、以及如何措辞两种方式,悄然塑造着公众对社会议题的认知。一项发表于 arXiv 的最新研究提出了一套二维分析框架,对 2022 至 2025 年间超过 90 万条法国新闻标题进行了大规模审计,试图把「框架效应」这一模糊的概念拆解为可量化的两个维度。
把「框架」拆成两个维度
以往的计算传播学研究常把新闻框架压缩成一个单一分数,掩盖了两种截然不同的操作机制。这项研究的核心创新在于将框架效应明确区分为两类:显著性框架(salience framing)与选择性框架(selection framing)。
显著性框架关注「怎么说」,通过四种措辞手段来测量:情绪化词汇(loaded vocabulary)、归咎归因(blame attribution)、威胁化表述(threat framing)以及反问句(rhetorical question)。这些语言装置决定了同一件事被描述得多么尖锐或煽动。
选择性框架则关注「说什么」,通过媒体机构层面的报道形态分布和「高情绪浓度」内容占比来衡量。换句话说,一家媒体倾向于选择哪类故事、以什么形式呈现,本身就是一种框架行为。将这两者分离,让研究者能够刻画出以往被混为一谈的媒体倾向性。
「框架效应」(framing effect)这一概念源自社会学家戈夫曼(Erving Goffman)1974年的奠基性研究,后被传播学者恩特曼(Robert Entman)于1993年引入新闻分析领域。恩特曼将框架定义为:选择感知现实的某些面向,使之在传播文本中更为突显,从而推动特定的问题界定、因果解释、道德评判或行动建议。传统框架分析多依赖人工编码,成本高、规模受限,且常将「怎么说」与「说什么」混同为一个笼统的偏见评分。计算传播学兴起后,研究者开始用词典、机器学习和大语言模型对框架进行自动化识别,但维度分离的问题长期未被系统解决。这也是本研究将显著性框架与选择性框架明确区分的理论背景。
用大模型构建万条标注数据集
要在近百万条标题上做分析,标注质量是关键瓶颈。研究团队先构建了一个包含 10,000 条法语标题的监督数据集,采用三个 LLM 标注器进行标注,通过多数投票(majority-vote)解决分歧,并辅以人工仲裁。
为验证标签的可靠性,团队还做了两项独立于标注器的盲测人类研究,将机器标签与人工判断交叉比对。这种「LLM 初标 + 人类验证」的流程,代表了当前大规模文本标注的一种务实路径——在成本可控的前提下尽量逼近人类标注质量。随后,团队用表现最强的分类器处理了来自 25 家法国媒体、去重后共 902,111 条标题的语料库。
多数投票(majority voting)是集成标注中解决分歧的常见策略:当多个标注者(无论人类还是模型)对同一样本给出不同判断时,取多数派意见作为最终标签。这一方法的核心假设是各标注者的错误相互独立,从而在聚合后相互抵消。然而,当多个LLM共享相似的预训练数据或对齐偏差时,该假设可能不成立——多个模型可能在同一类样本上系统性地犯同一方向的错误,多数投票无法纠正这类共同偏差。这正是研究者额外引入独立人类盲测验证的原因:通过来自不同认知背景的人类判断,检验机器标签是否存在系统性漂移,而非仅依赖模型内部的一致性。
三个关键发现
显著性与选择并非同一回事
研究发现,显著性偏离与选择性偏离之间存在正相关,但两者之间近一半的媒体层面方差无法互相解释。这意味着一家媒体在「用词尖锐」和「选题倾向」上的表现可以相当不一致。基于此,研究构建了一个四象限的媒体类型学,那些处于「非对角线」格子中的媒体——比如用词温和但选题极端,或选题平常但措辞激烈——恰恰是解读价值最高的对象。
默认阈值会系统性高估煽动性
第二个发现具有方法论警示意义:分类器的默认判定阈值会系统性地夸大语料库层面的显著性估计。也就是说,如果不加校准直接套用模型,会得出「新闻比实际更煽动」的失真结论。研究提出了一套基于精确率下限(precision-floor)的重新校准协议来修正这一偏差。对任何用 AI 做大规模内容分析的研究者而言,这是一个值得警惕的陷阱。
分类器的决策阈值(decision threshold)是将模型输出的连续概率转化为离散类别标签的临界值,默认通常设为0.5。然而在类别不平衡或评估目标不对称的场景下,默认阈值往往并非最优选择。精确率下限(precision-floor)校准是一种以保证精确率为优先目标的阈值调整策略:研究者先设定一个可接受的最低精确率要求(例如:至少80%的正类预测是真正的正例),然后将阈值上调至满足该要求的最低值,以此牺牲一部分召回率来换取更可靠的正类判断。在新闻煽动性检测这类任务中,过低的阈值会将大量模糊样本误判为「煽动性」,导致语料库层面的比率虚高;精确率下限校准提供了一种系统性的纠偏方法,对依赖AI进行大规模内容分析的研究具有重要的方法论参考价值。
群体提及背后的不平等语境
最引人注意的是群体提及分析。研究显示,提及犹太人、极右翼和穆斯林的标题,其检测到的显著性比率最高。这种差异无法完全由事件背景的整体构成来解释。
研究者在此处相当克制地说明了方法边界:残差是描述性的,而非同一事件下的因果估计;同时报告了每个群体词库的精确率。换句话说,数据揭示了不同群体被置于何种「情绪语境」中的显著差异,但并未断言这是媒体的主观意图所致。这种谨慎的表述方式,恰恰是这类敏感议题研究应有的严谨态度。
意义与开放资源
据研究团队所述,这是迄今为止规模最大的、聚焦框架效应的法语新闻标题审计。其价值不仅在于结论本身,更在于方法论层面的贡献:将框架拆分为可测量的两个维度、警示分类阈值的失真风险、以及在敏感群体分析中保持因果谨慎。
团队还公开了监督数据集、词库和分析代码,为后续研究提供了可复现的基础。对于关注媒体偏见、计算传播学以及 LLM 在社会科学中应用的研究者来说,这套框架和数据都具有直接的参考价值。它也提醒我们,当 AI 被用来「审计」人类的信息环境时,工具本身的偏差同样需要被审计。
相关推荐

笔记本CPU跑本地大模型:Ollama+千问3给桌宠装大脑
普通笔记本没显卡也能跑本地大模型:B站UP主用Ollama加开源千问3 8B纯CPU运行,为原创桌宠小金娘装上本地大脑,配合DeepSeekHarness完成插件开发与三轮调试,模型0元、断网可用、隐私不出本机。

Mistral Large 4开源权重发布:1万亿参数,激活49亿
Mistral Large 4开源权重发布:约1万亿参数、激活约49亿,支持图文与百万级上下文。解析厂商自测的编码与网络安全数据、修改版宽松许可、数据中心级硬件门槛,以及权重公开后不可回收的安全风险。

AgentScope 2.0实战:Java企业级AI Agent开发指南
AgentScope 2.0是阿里巴巴推出的Java企业级分布式智能体框架。本文解析它为何适合服务端AI应用,对比客户端AI应用在权限、状态管理、并发上的差异,并梳理从环境配置到项目联调的实战学习路线。