笔记本CPU跑本地大模型:Ollama+千问3给桌宠装大脑

B站UP主用普通笔记本纯CPU跑千问3 8B,借DSH开发出能聊天有记忆的本地AI桌宠。
文章记录了UP主魏明将原创桌宠“小金娘”升级到3.0版本的过程:选择Ollama+千问3 8B本地部署,纯CPU推理每秒约9 token,成本0元且聊天内容不出本机。工程开发交给AI代理DSH,约50分钟完成插件编写、测试与修复。过程中遭遇DSH窗口来源地址被Ollama拒绝的CORS问题,通过插件后台转发解决;并实现了模型关闭时的降级话术、记忆关掉即清空等细节。最终桌宠能聊天、有记忆、表情随对话变化,插件已开源。
云端API按字数收费、必须联网,本地部署又常被"没显卡"劝退——B站UP主魏明用一台普通笔记本给出了另一条路:Ollama 加开源千问3 8B,模型约5个G,纯CPU运行,聊天内容不出本机,成本为0元。他把自己原创的桌宠"小金娘"从只会七种表情、能换装的壳子,推进到能聊天、有记忆、会看脸色的3.0版本,整个过程收录在《小鲸娘进化日记》第一集里。
两条技术路线,为什么选本地
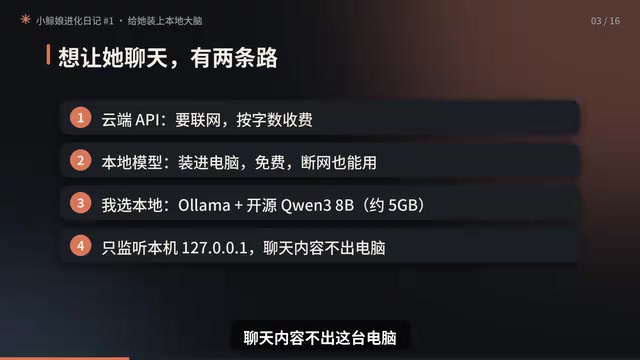
让桌宠会说话,摆在面前的是两条路。接云端API,要联网,按字数计费;把模型直接装进电脑,免费,断网也能用。魏明选了后者,理由很直接:陪伴型桌宠的对话内容天然私密,跑在本机意味着"聊天内容不出这台电脑",也不用为每句话付钱。
这条路的隐性门槛是硬件。很多人默认本地大模型必须配独立显卡,而他的实测恰好相反——用显卡跑时每秒只出0.1个token,还报CUDA错误;干脆改成纯CPU后,反而每秒能出约9个。配合"每句不超过40个字"的输出限制,等两三秒就能拿到回答。对一台普通笔记本来说,这个体验已经够用。
这里值得展开的是取舍逻辑:本地小模型的价值不在于跑分,而在于把"可用性"做出来。限制回答长度、接受秒级延迟、放弃复杂推理,换来的是一颗不花钱、不断网、不泄露的"本地大脑"。
Ollama 是一个开源的本地大模型运行工具,相当于给大模型装了一个“一键启动器”。它把模型下载、量化、推理服务打包成简单命令,用户只需 ollama run qwen3:8b 就能在本地跑起模型。Ollama 默认监听 127.0.0.1:11434,通过 HTTP API 对外提供接口,因此第三方程序(如本文的桌宠插件)可以调用它。其核心价值是降低本地部署门槛:自动处理模型格式、内存管理和硬件适配,让没有深度学习背景的开发者也能快速集成。
千问3 8B 指通义千问广告第三代 80 亿参数版本。参数规模决定模型能力与资源需求:8B 模型量化后约 5GB,适合 CPU 推理;而 70B 以上通常需要多卡 GPU。8B 在中文对话、常识问答上表现均衡,是本地部署的甜点尺寸。
DSH 接手,插件从零到跑通
模型装好后,剩下的工程活交给了 DeepSeekHarness(文中简称DSH)。魏明只写了一段话:双击桌宠弹出输入框,回答显示在头顶气泡里边生成边显示,人设保持简短可爱,表情跟着对话走,聊天只连本机,模型没开就回一句"我的大脑还没睡醒"。完整提示词放在置顶评论里。
接下来二十多分钟是DSH的自主作业:研究插件写法、测试本地模型接口、改代码、写测试,最后还派了一个子智能体逐行复查,找出5个小问题并全部修掉。
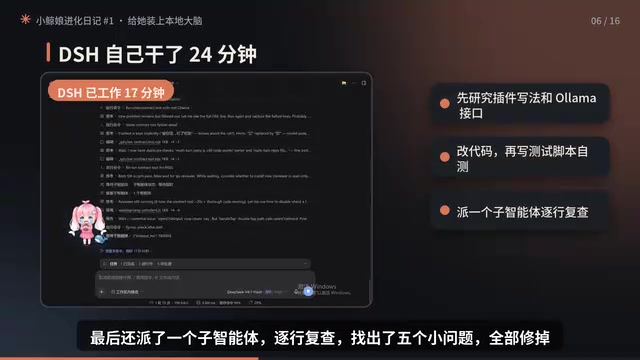
插件安装环节有个细节值得记录:DSH弹窗询问是否允许安装,魏明先确认了要装的正是工作区里自己的插件文件夹,才点了允许。这种"先看清楚再放行"的习惯,是让AI代理动本地文件时的必要防线——自动化程度越高,人对关键操作的确认越不能省。
AI 代理(Agent) 指能自主规划、调用工具、执行多步任务的 AI 程序。与普通聊天机器人不同,代理会拆解目标(如“写一个桌宠插件”)、搜索资料、修改文件、运行测试,并根据结果调整策略。本文中 DSH 就是典型代理:它先研究插件写法,再测试接口、改代码、写测试,最后派子智能体复查。代理的“自主性”带来效率,但也要求人类在关键节点(如安装插件、授权文件访问)进行确认,形成“人在环路”的安全机制。
第二次翻车:模型开着,它却说没睡醒
验收阶段撞上了最典型的一类bug。魏明问"你是谁",气泡立刻回"我的大脑还没睡醒",可本地模型明明开着,刚才的测试也全部通过。
把现象原样告诉DSH后,日志给出了答案:DSH窗口的来源是DHAPP开头的地址,Ollama不认识,直接拒绝了请求。解决办法是让插件后台代为转发,并且只连本机。
紧接着又冒出两个小毛病:聊完一句输入框就消失,再双击也打不开;以及凌晨时段它一直是"困了"的样子,把聊天表情全盖住了。
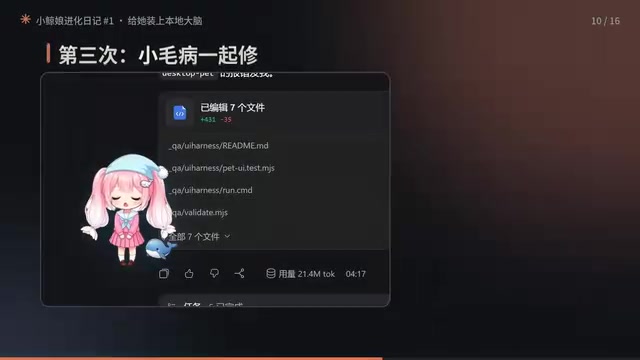
说清现象后约10分钟,3.0.2版本把这些问题全部修好。这段调试过程的启示是:本地模型接入第三方宿主时,CORS与地址来源校验是高频坑点,"测试通过"并不等于"链路跑通",真实调用路径才暴露问题。
CORS(跨源资源共享) 是浏览器的一种安全机制,用于限制不同源(协议+域名+端口)之间的资源请求。默认情况下,浏览器只允许同源请求;若前端页面(如 DSH 窗口,来源 DHAPP://...)向不同源的本地服务(如 Ollama 的 127.0.0.1:11434)发起请求,浏览器会先发送预检请求,若服务端未返回允许该来源的响应头,请求就被拒绝。本文中 Ollama 不认识 DHAPP 来源,直接拒绝,导致插件调用失败。解决办法是由插件后台(同源或受信任环境)代为转发请求,并限制只连本机,既绕过 CORS 又保持本地隐私。
验收:表情、记忆与"睡着"的优雅降级
修好之后的表现可以逐项对照。问要不要熬夜,它先眯眼想一想,再劝早点休息;说代码一直报错好难过,它立刻眼泪汪汪说"别着急我陪你一起找错误";它还记得最近一轮对话——问"我第一句问你什么来着",它答"你第一句问我是谁呢";骂它一句"你真笨",它会委屈。
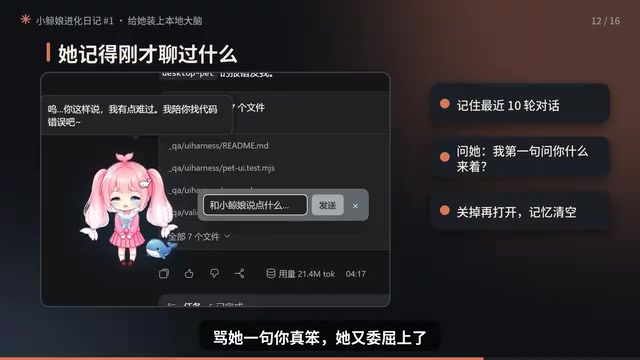
记忆策略也被明确:关掉重开就清空,不会悄悄存下来。这既符合本地优先的隐私取向,也避免了桌宠变成一个未经同意就积累用户数据的黑箱。
最值得称道的是降级处理。把本地模型关掉再说话,它不报错也不卡住,只是迷迷糊糊地说"我的大脑还没睡醒";重新启动模型,第一句要多等几秒加载,然后它说"我刚睡醒,太阳晒屁股了"。把技术故障翻译成人设内的表达,比弹一个错误框高明得多。
优雅降级(Graceful Degradation) 指系统在部分功能失效时,仍能以可接受的方式继续运行,而非直接崩溃或报错。本文中模型关闭时,桌宠不弹错误框,而是用人设内的“我的大脑还没睡醒”回应;模型重启后第一句延迟加载,并说“我刚睡醒,太阳晒屁股了”。这种设计把技术故障翻译成用户可理解、符合角色设定的表达,既保持了体验连贯性,也避免了暴露底层错误信息。对于陪伴型产品,降级话术是维系情感连接的重要环节。
成本账与后续
算下来,本地模型0元、不连网、CPU就能跑;DSH改插件前后约50分钟、三轮修改,消耗2000多万Token,好在缓存命中99%。插件已经开源在GitHub,复制置顶评论那段话给DSH就能装上。
从产品视角看,这套组合的意义在于把"AI桌宠"的门槛压到了普通笔记本:本地推理省钱且隐私,代理工具承接工程化改造,人设与表情系统负责情感表达。下一集魏明要让小金娘开口说话,第一句台词由评论区点赞最高者决定。
对想复刻的读者,路径可以概括为三步:先用Ollama跑通千问3 8B并确认CPU下的出字速度,再用DSH把插件接口接到本地服务,最后补上模型未启动时的兜底话术和记忆清理策略。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。