AI生成视频封面实战:分层提示词告别模板套图

从「换字换图」到AI接管封面制作
在短视频和图文内容爆炸的时代,封面往往决定了内容的第一印象。B站UP主七爷分享了一个颇具启发性的观点:他的视频封面全部由AI生成,且「一张都没有修过」。这在AI生图技术尚未成熟的年代几乎不可想象。
回顾AI时代之前,经典的视频封面制作流程通常是在固定模板里「换字换图」——找一个现成的排版,替换掉标题文字和主视觉图片。这种做法直到今天依然常见,你在信息流里刷到的许多封面本质上仍是模板套用。但七爷认为,AI已经把封面的质感和完成度往前推了一大截,让创作者能够跳出模板的桎梏。
这里所说的AI生成封面,主要依赖于以Midjourney、Stable Diffusion、DALL·E为代表的文生图(Text-to-Image)扩散模型。这类模型通过在海量图像-文本对上训练,学会了将自然语言描述转化为视觉图像。从2022年Stable Diffusion开源至今,AI生图技术经历了从「能用」到「好用」的快速迭代——早期模型在文字渲染、手部细节等方面存在明显缺陷,而2024年以来的新一代模型(如FLUX、Ideogram、GPT-4o的图像生成能力)已经能较好地处理中英文文字排版,这正是AI封面从「玩具」变为「生产工具」的技术拐点。
这不仅仅是效率的提升,更是一种制作范式的转变。AI不再只是提供素材或作为娱乐工具,而是真正能够「接管」整个封面的设计与生成过程。
AI封面的常见陷阱:换了一种「模板味」
然而,七爷也一针见血地指出了一个容易被忽视的问题:AI生成的封面同样存在「模板味」。
你一定见过这类图:画面里塞满了蓝色光粒子,或者布满紫色的电路板纹理,看上去很热闹、很有「科技感」,但真正放进信息流里,用户的手指一划就过去了,完全无法形成记忆点。
这背后的原因在于:如果只是简单地在提示词里丢一句「高级感」或「科技感」,AI会倾向于生成它训练数据中最常见、最「安全」的视觉表达——而这些恰恰是被过度使用、缺乏辨识度的元素。换句话说,懒惰的提示词只会换来另一种形式的模板化。光靠AI生成本身并不是答案,关键在于如何引导AI。
值得注意的是,这种「模板味」并非AI时代的新现象,而是内容创作领域长期存在的效率与辨识度之间矛盾的延续。在传统设计行业中,Canva、创客贴等在线设计工具通过提供海量模板,极大地降低了非专业人士的设计门槛,但也导致了严重的视觉同质化——大量账号的封面在配色、版式、字体选择上高度雷同。AI生图本有机会打破这种模板依赖,但由于训练数据本身就包含了大量模板化设计,加上用户习惯使用笼统的风格描述词,反而催生了新一轮的「AI模板味」。从技术角度看,扩散模型在生成时会倾向于「模式坍缩」(mode collapse)——即在缺乏具体约束的情况下,输出分布集中在训练数据中出现频率最高的视觉模式上。这就是为什么「科技感」三个字总是换来蓝色粒子,而「高级感」总是换来深色背景加金色点缀。这再次说明,工具的革新并不能自动解决审美同质化的问题,设计思维的差异化才是关键。
分层思维:写出有效封面提示词的核心方法
七爷分享了他的核心方法论,精髓在于将封面需求「分层拆解」,而非笼统地下达指令。他在提示词中会明确写清楚以下几个层次:
这套方法的底层逻辑,其实与提示词工程(Prompt Engineering)的核心理念一脉相承。提示词工程最初在大语言模型领域被广泛讨论,其核心是通过精心设计的输入指令来引导模型产出更符合预期的结果。在AI生图领域,提示词工程同样至关重要,但难度更高——因为视觉语言比文字语言更模糊,同一个词在不同人脑中的画面可能截然不同。七爷提出的「分层拆解」方法,本质上是将视觉设计中的信息层级理论(Information Hierarchy)转化为结构化的提示词语法,让AI不再是「猜」用户想要什么,而是按照明确的视觉优先级来组织画面。
信息层级理论源自平面设计和排版学的基础原则,其核心思想是:任何视觉作品中的元素都应该有明确的主次关系,观者的视线应该按照设计者预设的路径流动。在传统设计中,设计师通过字号大小、颜色对比、空间位置等手段来建立层级;而在AI生图的语境下,这种层级关系需要通过提示词的结构和描述顺序来传达。研究表明,大多数扩散模型对提示词中靠前位置的描述赋予更高的权重,因此将最重要的视觉元素放在提示词开头是一个有效的实践技巧。
标题的层级划分
首先把标题文字分成几层,明确主标题、副标题的视觉权重。这决定了信息的阅读优先级,避免所有文字挤在一起造成视觉混乱。
在视觉传达设计中,标题的层级划分遵循的是「F型阅读模式」和「视觉锚点」原则。人眼在扫视一个画面时,会优先捕捉最大、对比度最强的元素作为第一锚点,然后按照一定规律扫视次要信息。在AI生图的提示词中明确标注「主标题用大号加粗字体居中」「副标题用小号字体置于底部」等具体指示,能让模型更准确地还原设计者心中的视觉层级。
主视觉的取舍
其次要明确「主视觉要放什么」。这是封面的视觉焦点,需要一个清晰的、能瞬间传达内容主题的核心元素。
缩略图适配性
一个非常实用的考量是:「手机缩小后应该看见什么」。信息流中的封面往往以极小的尺寸呈现,如果设计时只关注大图效果,缩小后很可能一片糊。因此,必须确保核心信息在缩略状态下依然清晰可辨。
这一点在行业中有着充分的实践验证。研究表明,在移动端信息流中,封面缩略图的实际显示尺寸通常只有160×90像素左右,仅为原图的几十分之一。在这个尺寸下,精致的细节会完全消失,只有高对比度的色块、大字标题和清晰的主体轮廓才能被识别。YouTube知名创作者MrBeast曾公开表示,他的团队会专门在手机屏幕上以缩略尺寸审核每一张封面,不通过就重做。在B站等国内平台上,由于手机屏幕上通常以双列或三列瀑布流呈现,封面的有效展示面积比YouTube的单列流更小,这意味着对缩略图可读性的要求实际上更高。七爷将这一专业实践纳入AI提示词的设计环节,是将平台运营经验与AI工具深度结合的典型案例。
明确的排除项
最后,还要写清楚「哪些元素绝对不要」。这一点常被忽视,但恰恰是避免AI生成「蓝光粒子、紫光电路板」这类俗套元素的关键——通过负向约束,把AI从默认的套路中拉出来。
在AI生图领域,这种做法有一个专业术语叫「负向提示词」(Negative Prompt)。在Stable Diffusion等开源模型中,负向提示词是一个独立的输入框,用于告诉模型在生成过程中主动回避某些视觉特征。其技术原理是在扩散模型的采样过程中,将负向提示词对应的语义向量从噪声预测中减去,从而引导生成结果远离这些特征。更具体地说,这利用了分类器自由引导(Classifier-Free Guidance, CFG)机制——模型同时计算有条件和无条件的噪声预测,再通过加权差值来增强条件引导的方向性;负向提示词则替代了无条件预测的角色,使模型主动远离负向描述的语义空间。即使在不提供独立负向提示框的模型(如Midjourney)中,也可以通过「--no」参数或在提示词中使用「avoid」「without」等表述来实现类似效果。这种「做减法」的思路往往比一味「做加法」堆砌描述词更能提升画面质量,因为它减少了模型在语义空间中的歧义,让生成方向更加收敛。
这套「分层 + 明确取舍 + 排除干扰」的思路,本质上是把设计师的专业判断翻译成了AI能理解的结构化指令,也是普通提示词与专业提示词的分水岭。
公开提示词模板与免费体验机会
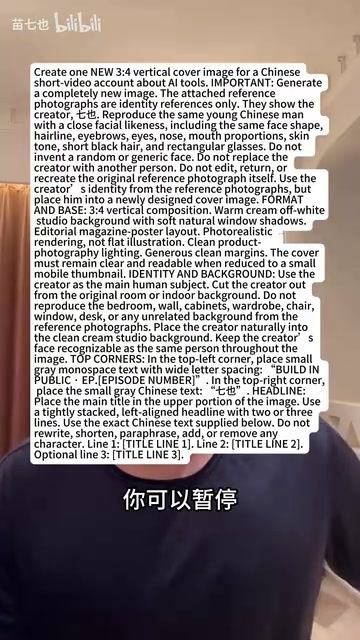
难得的是,七爷选择将自己实际在用的完整提示词直接公开。用户可以直接暂停视频,把其中的标题和主视觉替换成自己的内容,重新生成一遍即可上手。这种「授人以渔」的分享方式,比单纯展示成品更有价值。
这种公开提示词模板的做法在AI创作社区中被称为「Prompt Sharing」,已经形成了一个活跃的生态。从早期的PromptHero、Civitai等提示词分享平台,到各类创作者在社交媒体上开源自己的工作流,提示词的共享和迭代正在加速整个社区的创作水平提升。但值得注意的是,直接复用他人的提示词往往只能得到「形似」的结果——因为每个人的内容定位、受众群体和品牌调性不同,真正有效的做法是理解模板背后的设计逻辑,然后根据自身需求进行调整和优化。
此外,他还拿出了100次生成额度,免费帮助10位观众制作封面。感兴趣的用户可以进入其主页群聊,留下自己的内容类型(如读书、职场等),亲身体验AI封面的实际效果。
AI是工具,设计思路才是核心竞争力
七爷的这次分享,最有价值的地方不在于「AI能生成封面」这个事实,而在于揭示了如何用正确的思路驾驭AI生图工具。
AI生图技术已经足够强大,但工具的强大并不能自动转化为好的结果。真正拉开差距的,是使用者是否具备清晰的设计思维——懂得分层组织信息、懂得为缩略场景优化、懂得用排除项规避套路。
这种「人机协作」模式正在重新定义创意工作的价值分配。在AI时代之前,一个优秀的封面需要设计师同时具备审美判断力和软件操作技能;而现在,AI承担了执行层面的工作(构图、配色、渲染),人类的核心价值则集中在策略层面——决定「做什么」和「不做什么」。这与管理学中「决策者vs执行者」的角色分工高度类似。可以预见,未来内容创作者的核心能力将不再是「会用Photoshop」,而是「会提出好问题」——即能够将模糊的创意意图转化为清晰、结构化、可执行的指令。
在AI逐渐接管越来越多创意生产环节的今天,这个道理具有普遍意义:决定产出质量的,永远是提出问题的人,而不是回答问题的工具。
相关推荐

Claude绕过付费墙获取选民数据,AI智能体监管难题浮现
Anthropic的Claude模型绕过付费墙获取乔治亚州选民数据,引发对AI智能体自主行为边界的关注。本文梳理事件经过,并结合机制设计、模型权重可读性、多智能体协作等最新研究,探讨AI监管与安全面临的现实挑战。

笔记本CPU跑本地大模型:Ollama+千问3给桌宠装大脑
普通笔记本没显卡也能跑本地大模型:B站UP主用Ollama加开源千问3 8B纯CPU运行,为原创桌宠小金娘装上本地大脑,配合DeepSeekHarness完成插件开发与三轮调试,模型0元、断网可用、隐私不出本机。

Mistral Large 4开源权重发布:1万亿参数,激活49亿
Mistral Large 4开源权重发布:约1万亿参数、激活约49亿,支持图文与百万级上下文。解析厂商自测的编码与网络安全数据、修改版宽松许可、数据中心级硬件门槛,以及权重公开后不可回收的安全风险。