AiSOC:开源AI安全运营中心,LLM智能体分诊与可回放决策账本

开源自托管的 AiSOC 用 LLM 智能体分诊告警,并保留可回放决策账本。
GitHub 项目 beenuar/AiSOC 是一个开源的 AI 安全运营中心,采用 Python 编写、MIT 许可证,支持自托管且无需 API Key 即可运行。它针对 SOC 长期存在的告警过载问题,提供四项核心能力:告警融合把多源重复告警聚合降噪;LLM 智能体分诊对告警做初步判定与优先级排序;调查过程映射到 MITRE ATT&CK 框架,输出结构化的攻击战术与技术视图;每一步智能体决策都记录在可回放的决策账本中,回应 AI 安全工具黑箱难审计的痛点。项目还附带面向 Claude、Cursor、Continue 的 MCP 服务器,便于接入现有 AI 工具链。作者认为其价值在于兼顾智能体自动化与可审计性,适合数据主权敏感的组织,但生产采用前需评估告警源覆盖与分诊准确率。
开源AI安全运营中心的新选择
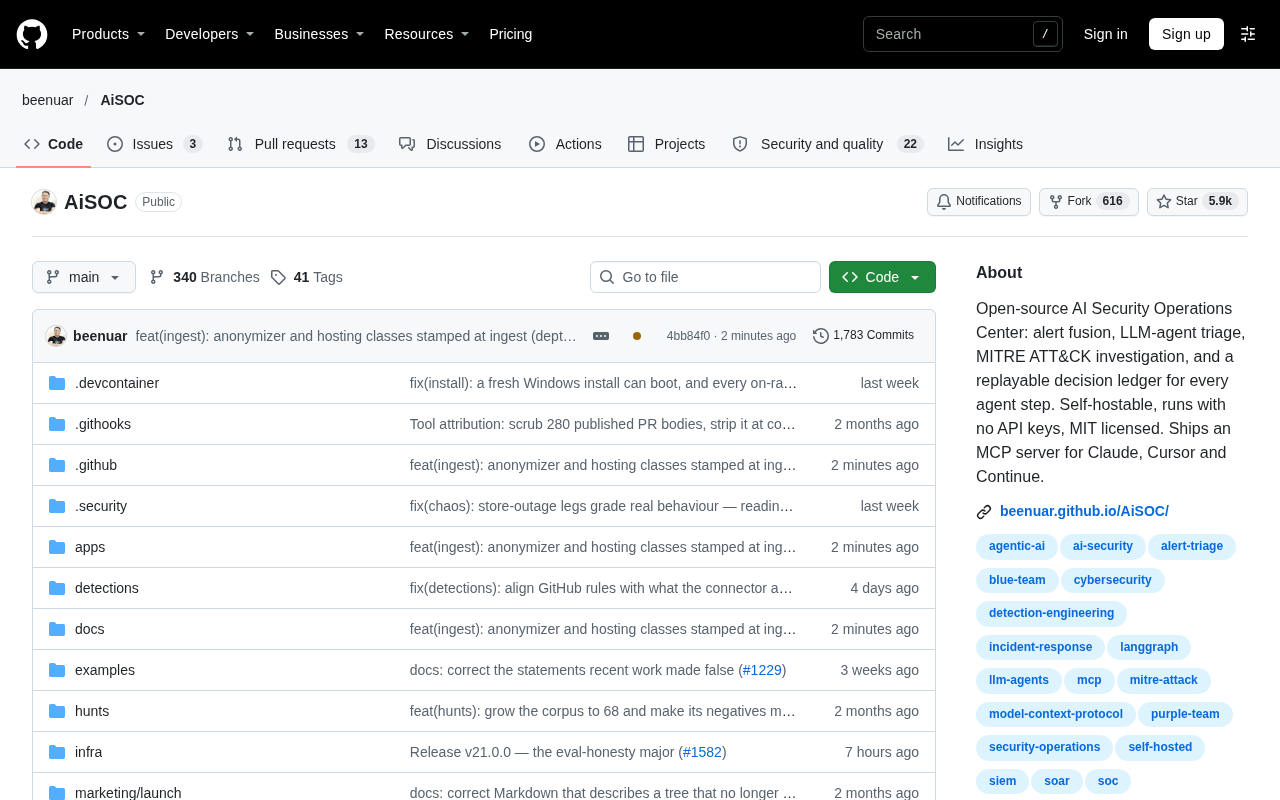
安全运营中心(SOC)长期面临告警过载的困境:海量告警中混杂着大量误报,分析师疲于奔命却难以聚焦真正的威胁。GitHub 上的 beenuar/AiSOC 项目试图用 LLM 智能体来改变这一局面——它是一个开源的 AI 安全运营中心,集告警融合、LLM 智能体分诊、MITRE ATT&CK 调查和可回放决策账本于一体。项目已获得 5841 星、615 次 fork,单日新增 436 星,热度可见一斑。
自托管、无 API Key 也能跑
AiSOC 采用 Python 编写,以 MIT 许可证开源,支持自托管部署。一个值得注意的特性是:它无需 API Key 即可运行。对于安全团队而言,这意味着可以在隔离环境中快速验证效果,而不必担心密钥管理或外部服务依赖带来的合规风险。项目还附带了面向 Claude、Cursor 和 Continue 的 MCP 服务器,方便开发者将安全分析能力接入现有的 AI 编码工具链。
SOC(Security Operations Center,安全运营中心)是组织内集中监控、检测、分析和响应网络安全事件的团队与设施组合,通常配备 SIEM(安全信息与事件管理系统)、SOAR(安全编排自动化与响应)等工具。所谓"告警过载",指安全设备(IDS/IPS、EDR、防火墙、云审计日志等)每日产生成千上万条告警,其中真实威胁占比极低,分析师需人工逐条研判,既消耗人力又容易遗漏关键事件,是行业公认的运营瓶颈。
MCP(Model Context Protocol,模型上下文协议)是由 Anthropic 提出并开源的标准化协议,用于让 LLM 应用以统一方式连接外部工具与数据源。一个 MCP 服务器可以把某项能力(如查询安全告警、检索威胁情报)以标准接口暴露出来,任何支持 MCP 的客户端(如 Claude Desktop、Cursor、Continue)都能即插即用地调用。对 AiSOC 而言,提供 MCP 服务器意味着其安全分析能力不必绑定在自有界面里,而可以嵌入开发者日常使用的 AI 编码工具,降低接入成本。
核心能力拆解
告警融合:从噪声中提炼信号
告警融合是 AiSOC 的第一道关口。面对来自不同安全设备的重复和关联告警,系统将其聚合处理,降低分析师的认知负荷。这一层处理为后续的智能体分诊奠定了基础——只有经过融合的告警,才更适合交给 LLM 进行上下文推理。
LLM 智能体分诊与 MITRE ATT&CK 调查
分诊环节由 LLM 智能体驱动,对告警进行初步判定和优先级排序。进一步地,系统将调查过程映射到 MITRE ATT&CK 框架,使分析结果能够对应到具体的攻击战术与技术。这种结构化输出有助于安全团队理解攻击者的行为模式,而不仅仅是处理单条告警。

MITRE ATT&CK 是由 MITRE 公司维护的公开知识库,系统梳理了真实攻击者使用的战术(Tactics,即"为什么",如初始访问、横向移动、数据渗出)与技术(Techniques,即"怎么做",如钓鱼附件、凭据转储)。它将攻击链按 14 类战术阶段组织,每项技术配有编号(如 T1059 命令执行)。安全工具把告警映射到 ATT&CK 技术,可帮助团队识别攻击所处的阶段、预测下一步动作,并在不同厂商产品之间建立统一的话语体系;AiSOC 将调查结果结构化映射到该框架,正是为了让单条告警上升为可关联的攻击行为视图。
可回放决策账本
智能体做出判断后,如何信任并复现它的决策?AiSOC 为每一个智能体步骤提供可回放的决策账本。这一设计回应了 AI 安全工具的一大痛点:黑箱决策难以审计。可回放意味着团队可以追溯智能体在每一步看到了什么、推理了什么、最终为何做出该判断,为事后复盘和合规审计提供了依据。
LLM 智能体的"黑箱"问题源于其推理过程由模型内部权重与上下文共同决定,同一输入未必产生完全一致的输出,且中间步骤默认不对外暴露。可回放决策账本通常的做法是记录每一步的输入上下文、工具调用、模型输出与时间戳,形成不可篡改的事件序列,事后可按序重放以复现当时的判断路径。这在安全场景尤为关键:审计与取证要求结论可追溯、责任可界定,而监管与合规框架也普遍要求自动化决策具备可解释性。
对安全团队意味着什么
AiSOC 的价值在于把 LLM 智能体引入 SOC 工作流的同时,保留了可审计性。开源和自托管的属性让它适合对数据主权敏感的组织;MCP 集成则让它有机会融入已有的 AI 辅助开发环境。当然,作为一个仍在快速迭代的项目,生产环境采用前需要评估其告警源覆盖范围和智能体分诊的准确率。
对于希望探索 AI 驱动安全运营的团队,AiSOC 提供了一个低门槛的起点:无需 API Key 即可启动,决策过程可回放,代码完全开放。
相关推荐

笔记本CPU跑本地大模型:Ollama+千问3给桌宠装大脑
普通笔记本没显卡也能跑本地大模型:B站UP主用Ollama加开源千问3 8B纯CPU运行,为原创桌宠小金娘装上本地大脑,配合DeepSeekHarness完成插件开发与三轮调试,模型0元、断网可用、隐私不出本机。

Mistral Large 4开源权重发布:1万亿参数,激活49亿
Mistral Large 4开源权重发布:约1万亿参数、激活约49亿,支持图文与百万级上下文。解析厂商自测的编码与网络安全数据、修改版宽松许可、数据中心级硬件门槛,以及权重公开后不可回收的安全风险。

AgentScope 2.0实战:Java企业级AI Agent开发指南
AgentScope 2.0是阿里巴巴推出的Java企业级分布式智能体框架。本文解析它为何适合服务端AI应用,对比客户端AI应用在权限、状态管理、并发上的差异,并梳理从环境配置到项目联调的实战学习路线。