AI写代码时代,如何正确测试你的程序?
三层测试体系在AI编码时代依然成立,但"AI自写自测"会让错误假设同时污染代码与测试。
软件测试分为单元测试、集成测试和端到端测试三个层次,分别捕获孤立逻辑错误、模块边界问题和完整用户流程的失效。测试金字塔主张以最低成本的层次获取足够的信心,即多写快而小的单元测试,少量集成测试,极少量端到端测试。AI大规模参与编码后,这一体系的重要性不降反升——因为AI agent若同时负责实现与测试,会将同一错误假设带入两者,造成"测试全绿但系统仍然有Bug"的隐蔽陷阱。解决方案的核心是让正确行为的定义来自外部:规格说明、API契约或验收标准,并引入独立的审查环节。AI能压低构建反馈回路的成本,但"什么是正确"这一判断始终需要人来完成。
一个程序通过了所有单元测试,产品却依然可能是坏的。也许数据库费用算错了,也许两个服务对 API 的理解不一致,又或者每个模块单独运行都没问题,但用户的结账流程就是走不通。原因很简单:不同类型的测试捕获的是不同类型的 bug。
当 AI 开始大规模参与编码之后,测试这件事不但没有变得可有可无,反而更需要我们理解它背后的逻辑。下面从软件测试的三个层次说起,看看每一层到底擅长解决什么问题,以及 AI 介入后哪些地方发生了变化。
单元测试:快速反馈的地基
以一家在线商店为例。假设我们有一个函数,用来计算订单的最终价格,其中包含折扣、税费和运费。一个单元测试可能会检查 10% 的折扣是否计算正确,或者订单满 50 美元是否触发免运费。
这里的关键在于,我们是在孤立地测试一小段逻辑——没有数据库,没有其他服务依赖。正因如此,单元测试运行极快,可以在每次代码变更时成百上千次地跑。它构成了测试体系最底层、也是数量最庞大的部分。
但只测试孤立的片段远远不够。真实系统里,模块之间会相互调用、相互依赖,这就是单元测试覆盖不到的盲区。
集成测试:守住系统的边界
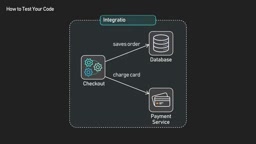
结账服务需要把订单保存进数据库,还要调用支付服务。单元测试管不到这些跨模块的协作,集成测试才是它的用武之地。
集成测试检查的是系统的多个部分能否真正协同工作。比如调用结账 API,验证它是否把正确的数据写入了数据库;又比如确认结账服务传给支付服务的字段是否符合对方的预期。
结账逻辑可能通过了每一个单元测试,却依然在这里失败——因为 SQL 写错了,或者两个服务对 API 的约定根本对不上。这类“边界处的 bug”往往是生产事故的高发区,单靠单元测试永远发现不了。
端到端测试:验证完整的用户旅程
端到端测试则完全是另一种思路。它不直接调用结账 API,而是像真实用户一样打开网站:把商品加入购物车、走完结账流程、确认订单成功页面出现。
这意味着我们一次性测试了整条链路——前端、后端、数据库以及背后的所有服务。这正是它的核心价值:端到端测试验证的是完整的用户工作流是否真的能走通。
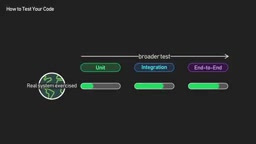
但覆盖面越广,代价也越高。端到端测试更难搭建、运行更慢、也更难调试。单元测试失败时,需要排查的代码量很小;而端到端测试一旦失败,问题可能藏在整条路径的任何一个环节里。
测试金字塔:在正确的层次做测试
上述三种测试的取舍,正是“测试金字塔”这个经典理念的来源。
我们通常希望:底层拥有大量小而快的单元测试,中间是数量较少的集成测试,顶层则是一小组覆盖最重要工作流的端到端测试。
金字塔的精神可以浓缩成一句话:用能给我们带来足够信心的最低层级去测试。能用单元测试搞定的,就别用更昂贵的端到端测试去验证。这样既保证了反馈速度,又控制了维护成本。
测试金字塔(Test Pyramid)由 Mike Cohn 在2009年的著作《Succeeding with Agile》中正式提出,后经 Martin Fowler 等人广泛推广。与金字塔相对的反模式被称为"冰淇淋甜筒"(Ice Cream Cone)——顶层堆满了缓慢、脆弱的手动测试或端到端测试,而底层单元测试寥寥无几。这种结构会导致反馈周期极长:一次代码提交可能需要等待数小时才能知道是否破坏了某个功能。金字塔模型的另一个衍生变体是"测试奖杯"(Testing Trophy),由 Kent C. Dodds 提出,主张将集成测试的权重进一步提升——因为在现代前端与微服务架构中,"模块能否协同工作"往往比"单个函数逻辑是否正确"更接近用户真正关心的问题。不同团队和技术栈可能适合不同的形态,但"避免过度依赖高成本测试"这一核心原则贯穿所有变体。
AI 写代码后,什么变了?
当代码由 AI 生成时,变化主要体现在速度和变更的体量上。一个 AI agent 可以做出一次大规模改动、为它生成测试、运行这些测试、修复失败、再重试——整个循环的成本被大幅压低。
但这里潜伏着一个必须警惕的失效模式:如果同一个 agent 先写了实现,又基于这份实现去写测试,它很可能把同一个错误假设同时带进了代码和测试。结果是——代码是错的,测试却与错误的代码“达成一致”,所有测试全部通过。
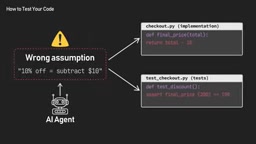
这是一个相当隐蔽的陷阱。要避免它,期望的正确行为必须来自代码之外的某个来源:一份规格说明、一份 API 契约,或是一组验收标准。对于重要的改动,还可以引入独立的审查步骤,甚至安排另一个 agent 来验证结果。
核心原则是:不要让构建代码的 agent 自己给自己批改作业。
这种失效模式在软件工程中有一个对应的经典概念:测试应当基于规格(specification)而非实现(implementation)。传统的测试驱动开发(TDD)通过"先写测试、再写代码"的顺序来强制保证这一点——测试天然来自需求,而非来自代码本身。当 AI agent 同时承担实现与测试两个角色时,实际上打破了 TDD 所建立的这道屏障。一个实用的应对策略是"规格优先":在让 AI 写任何代码之前,先以自然语言或形式化方式写下验收标准,再将这些标准交给 AI 转化为测试骨架,最后才是实现。这样,测试的根基锚定在人类意图上,而非 AI 对意图的某种解读。另一个值得关注的风险是"确认偏误放大"——AI 生成的测试倾向于覆盖它自己"认为重要"的路径,而对边界条件、异常流程的覆盖往往不足,这恰好是 bug 最容易藏身的地方。
AI 工具正在改变代码审查体验
这种“独立验证”的需求,也催生了专门的 AI 审查工具。以 CodeRabbit 为例,它是 GitHub 和 GitLab 上安装量最高的 AI 应用之一。
如今一个 AI 生成的 Pull Request 可能一次性改动十几个毫不相关的地方,审查它意味着在无数标签页之间来回切换。CodeRabbit 的新审查界面把 diff 拆分成一个个小而相关的代码块,可以逐块查看;点击任意函数就能就地弹出其定义;对改动有疑问时直接提问,无需离开页面即可得到答案,它还会标记出关键区段。
这类工具的意义在于,它把“由另一方来审查”这件事变得更低成本、更顺手,正好契合 AI 编码时代对独立验证的强烈需求。
不变的内核
归根结底,那套基础的测试金字塔依然成立:单元测试给我们快速反馈,集成测试捕获系统边界处的问题,端到端测试告诉我们整个工作流到底能不能跑通。
AI 能让构建和使用这些反馈回路变得便宜得多,但它无法定义什么才叫“正确”。定义正确性这件事,始终得由我们自己来完成。
相关推荐

写代码就能出片:Code-to-Video开源项目全解析
web-video-produce 是一个 Code-to-Video 开源项目,用 React 和 Remotion 把做视频变成写代码:分段脚本自动生成配音、字幕、时间轴,支持 Canvas 图表、Three.js 三维、14种中文音色及自动音频验收。

LightOn OCR-3 上线 OpenDocRouter:开源 OCR 的性价比新标杆
LightOn OCR-3 现已上线 OpenDocRouter,定价每百万输入 token $0.28、输出 $1.40,约 $3.19/千页。ParseBench 测试显示其位于开源 OCR 帕累托前沿,性能接近 Gemini 3.8 flash low 且价格低约 45%。

LegalOn 如何将 Codex 成本砍半:模型分级与预算管控实战
法律科技公司 LegalOn 通过按任务匹配 Astra、Sol、Luna 等不同模型并战略性管理预算,在保持开发速度的同时将 Codex 每日成本削减约 65%。本文解析其模型分级与预算管控的实战经验。