AI写的Spec能直接生成代码吗?多智能体评审流程解析

SDFlow在规格与代码间插入多智能体交叉评审,17分钟筛出18条真问题再让人拍板。
SDFlow 流程在 AI 生成的规格文档与代码生成之间插入一道多智能体评审关卡。它派独立 agent 从 CEO、工程、开发体验、代码、领域、对抗等角度并行审查,并按风险等级动态加派,同时引入另一个模型提供独立第二意见。评审结果先合并重复、核验引用行号与原文,再由主会话逐条裁决是否真会发生,50 条问题最终采纳 18 条改进规格,人只需对一条拍板。整套评审约 17 分钟、消耗 1500 万 token,价值在于抵消大模型输出的不确定性并让问题在写代码前暴露。评审存在盲区,需将踩过的坑沉淀为领域清单规则;第一性原理提示词可触发方案再优化。
AI 生成的规格文档(Spec)直接拿去写代码,风险有多大?B 站 UP 主“老刀千里”分享的 SDFlow 流程给出了一个思路:在规格写完、代码开写之前,插入一道多智能体评审关卡,让 AI 从多个角度交叉审查,人只负责拍板关键决策。这套流程的核心逻辑、实操细节和成本收益,值得每一位用 AI 辅助开发的工程师了解。
为什么规格需要“审一遍”?
UP 主在之前的最小开发循环 Demo 中遇到过一个典型问题:需求是温度超过 80 度告警,但规格的测试任务里却写了一条“81.2 度不告警”。子代理跑测试时发现了冲突,查证后确认是规格写错了,改正后才继续。这个案例暴露了一个关键风险——如果规格从头到尾逻辑一致,测试根本发现不了错误,代码就会忠实执行一个错误的需求。
规格文档内容多且复杂,人工审查负担重。UP 主引用 Martin Fowler 网站上的文章指出,有作者试用 SpecKit 等三个规格驱动开发工具后,抱怨生成的 Markdown 文档“又啰嗦又累人”,宁可去审代码。Cloud Code 团队的 Tarek 也坦言,超过 100 行的 Markdown 他自己都不怎么读。让 AI 先审一轮,成为降低人工审查负担的务实选择。
多智能体评审:换上下文、多角度、交叉验证
SDFlow 的评审设计参考了 YC 总裁 Gary Teng 的 G-Stick 框架,并做了扩展。核心做法有三点:
第一,换干净的上下文。 不再让写规格的那个会话去审,而是派独立的 agent,每个 agent 启动时都是干净的,只看文档和代码,不受写作时的思路影响。
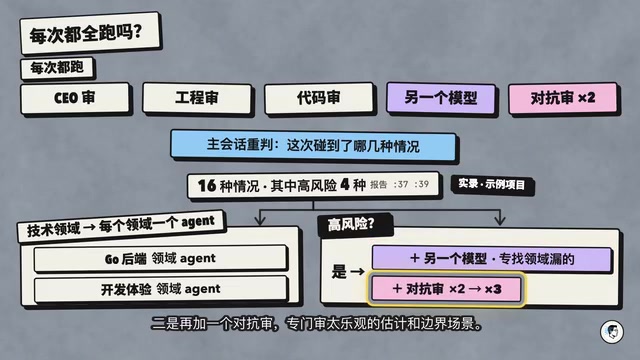
第二,多角度并行审。 每个角度一个独立 agent 同时跑,包括:CEO 审(前提和范围该不该做、做多大)、工程审(架构出错路径、测试计划)、开发体验审(命令接口配置是否好上手)、代码审(规格里说的代码是否真的这么写)、领域审(按技术栈分层清单逐条过)、对抗审(先假设一定出事再找怎么出事)。此外还会请另一个模型给独立第二意见——用 Claude 开发就请 Codex 那边最强的模型,反之亦然。
第三,按需加派。 不是每次都全跑。固定跑的有 CEO 审、工程审、代码审、另一个模型审和两个对抗审。主会话会先判断需求设计情况,16 种情况中 4 种算高风险。命中高风险则加派:另一路模型再审一次专找领域审漏掉的,再加一个对抗审专审太乐观的估计和边界场景。领域审则根据改动是否碰到后端、命令接口等按需派发。
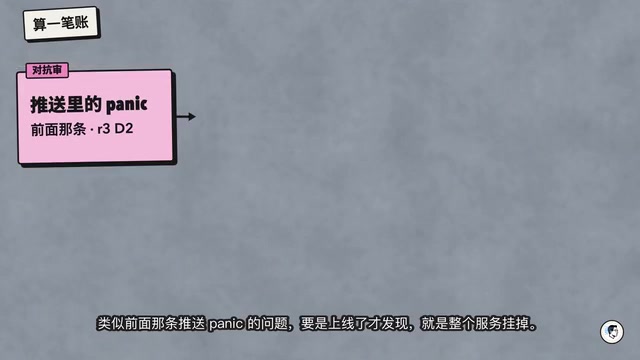
对抗审的价值在一个真实案例中体现得淋漓尽致:需求是在钉钉群通知值班人员,推送放在单独 goroutine 里跑以免拖慢温度上报。对抗审假设这段推送代码崩了会怎样——Go 里 goroutine panic 没有 recover 会导致整个进程退出,推送一崩整个服务就没了,温度也报不上来。规格里没写这一条,但三个对抗审里两个报了,工程审也报了,Go 领域审也查到了清单里本来就有这一条。最终规格补上了“推送里的 panic 要 recover 住,记错误日志,服务照常跑”。
G-Stick 框架是 YC 总裁 Gary Tan(原文中“Gary Teng”应为 Gary Tan)提出的一套 AI 辅助开发方法论,核心主张是“先让 AI 写出详尽的规格(spec),再让多个 AI 代理从不同角色评审并迭代,最后才生成代码”。它强调将人的判断集中在关键决策点,而把繁琐的审查、查证、交叉验证交给 AI。SDFlow 在此基础上扩展了评审角色(如领域审、对抗审)和动态加派机制,使其更适配真实工程场景。
对抗审(Adversarial Review) 是一种刻意“找茬”的评审策略:评审者先假设系统一定会出故障,再反向推演故障可能如何发生、在哪些边界条件下触发。它不追求证明方案正确,而是主动挖掘乐观估计、遗漏的异常路径和未言明的假设。与常规评审相比,对抗审更容易暴露 goroutine panic、并发竞态、超时与重试等隐蔽风险,因此常被用于高风险需求的加派审查。
从 50 条到 18 条:AI 先裁决,人只拍板
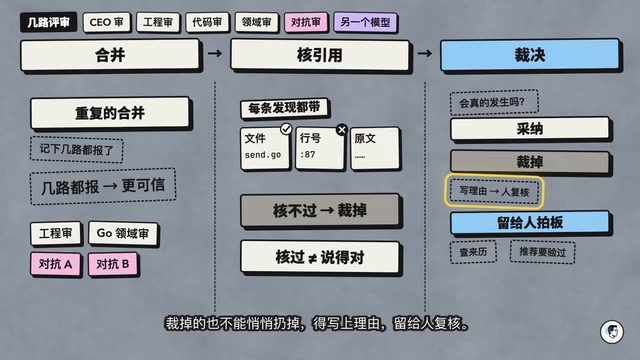
几路评审跑完,报上来 50 条问题,有真有假。主会话的处理流程是:先合并重复项,记录哪几路都报了同一条——多路独立报同一条,可信度更高。比如推送 panic 那条就有四路都报了。然后核引引用,每条发现必须带文件行号和原文,核对文件在不在、行号对不对、那一行是不是真的这么写,核不过的直接裁掉。
核过引用只说明引的是真的,不代表说的对。主会话再逐条裁决:实现时这个问题会不会真的发生?会的留下,不会的裁掉,拿不准的留给人。裁掉的也不能悄悄扔掉,得写上理由。另一个模型和主会话意见不一致的,两边的说法都交给人判断。
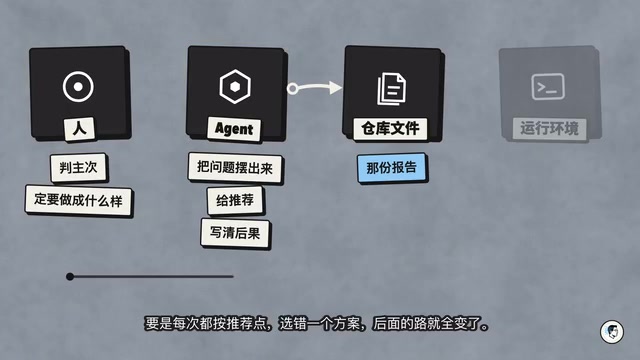
这一轮下来,50 条合并重复后剩 28 条,最终采纳 18 条直接改进规格文档,需要人拍板的只有一条。UP 主强调,评审中途不问人,人只看最后报告。报告以网页形式呈现,固定列三个问题:范围认不认、依赖和顺序认不认、风险和对策认不认。有两个以上方案的要写清选项、推荐哪个、选了以后对系统对用户对以后的开发各有什么后果。
核引引用(Citation Verification)是指对每条评审发现,核对它所引用的文件是否真实存在、行号是否准确、该行原文是否与发现描述一致。这一步能过滤掉 AI 幻觉产生的“看似有理但查无实据”的问题。核过引用只证明引用真实,不代表结论正确,因此还需主会话逐条裁决“实现时这个问题会不会真的发生”,拿不准的才留给人判断。这种“先核事实、再判逻辑”的两段式处理,显著降低了人工复核的负担。
成本与收益:17 分钟、1500 万 token 换什么?
这套评审跑下来大约 17 分钟,消耗 1500 多万 token,九成是缓存读取。UP 主认为值,理由有二:
减少大模型的不确定性。 有团队测试过同一句话跑 1000 次,出了 80 种回答。UP 主自己也做了实验:同一份规格开三个全新会话,同一个模型只问“你自己审一下这份规格”,每次三分钟左右,三次去掉重复共 16 条,其中实质问题 7 条,但三次都查到的只有 2 条,有 4 条只有一次查到。而推送 panic 那条,同样的审法跑几次也看不到,SDFlow 的多路评审里有四路报了。Anthropic 有篇文章举过审代码漏洞的例子:用几个不同提示词各审一遍,一路漏掉的别的路能补上。今年 9 月有篇论文让 OpenAI 和 Anthropic 的 10 个模型评审需求文档,反复跑 100 次,Anthropic 表现最好的那个专家找出的问题也只查到一半左右,论文判断漏的主要是模型固有短板而非随机。10 月另一篇论文也测过,另一个模型找到的错误跟同一个模型换个会话找到的只有部分重合。所以请另一个模型不是因为它更准,是因为它看到的不一样。
问题越早发现越便宜。 这是软件工程的老结论。2001 年有篇总结指出,交付以后再修常常是需求设计阶段的 100 倍,小一点不那么关键的系统也有 5 倍左右。用 AI 写代码返工是快了,可还得重测重审,漏到上线出了事才知道。而在写代码之前改掉,也就是改几行字的事。UP 主算账:推送 panic 那种问题要是上线才发现就是整个服务挂掉,花十几分钟在写代码之前找出来,值。
评审的盲区与一条“魔法咒语”
评审并非万能。UP 主这次遇到一件事从头到尾没人问过:值班的人在钉钉群里看到的时间该是 UTC 还是北京时间?拷问没问,评审也没问,直接把 UTC 写死进了规格。这种“大家都默认”的前提,评审清单里没有,领域审也想不到去问。他的办法是把它写成一条新规则加进领域清单——“给人看的时间用哪个时区要先问人”,下次领域审就会拿它来查。使用者也可以把自己项目踩过的坑一条条加进去。
最后 UP 主推荐了一句“魔法咒语”:“按第一性原理从这次需求的目标出发重新调研一下有没有更简洁更合适更便宜的方案。”这句话会让 AI 回到目标重新调研,大多数时候会把方案再优化一轮,有时候会整个推翻重新设计。他举例:给一个项目补测试,AI 推荐把生产代码里取当前时间的地方都改成可替换接口,以便测试里冻住时间,这条也写进了规范。后来问了这句魔法咒语,AI 回头查代码发现改十来处生产代码只多测了差一秒这种边界,没必要,最后生产代码一处没改,规范也放宽了——以后新写的时间判断把当前时间当参数传进去就行。不过他也试过把这句写进 SDFlow 流程,效果没有单独问好,猜测与上下文和注意力机制有关。
回到开头的问题:AI 写的 Spec 能直接拿去生成代码吗?UP 主的回答是:先审一轮再说。AI 分几路同时审,审出来的先核引用再逐条裁决,人不用盯着,只看评审报告提意见,最后拍板批准。评审花的时间和 token 换来两样——不确定性少了,问题早发现了。审不出来的,发现了就写成规则加进清单,以后就能用了。但规格评审替代不了人对自己需求的判断,最后做成什么样,还是需要自己来做决策。
(本文基于 B 站 UP 主“老刀千里”的视频内容整理,SDFlow 仓库地址见其视频简介。)
相关推荐

Reddit帖子被删引发AI内容审核争议
Reddit一则帖子被平台以违反内容政策为由删除,页面仅显示移除提示。事件折射出AI内容审核系统在透明度、误判风险和申诉机制方面的普遍困境,值得内容平台与创作者关注。

DSH+Ollama本地部署大模型实战:免费对话大肥鱼
B站UP主实测DSH+Ollama本地部署大模型全流程:从Ollama安装、迅雷加速下载、魔搭GGUF模型导入,到DSH自定义API地址配置,并对比千问3.5 4B、8B、Gemma等模型在8G显存下的表现,给出本地部署与API调用的选择建议。

899元Mac Mini实测:能替代200美元AI订阅吗?
实测M4 Mac mini能否替代200美元AI订阅:16GB内存装不下大模型,速度与质量均有差距,但隐私、无上限和近零运行成本让它成为常驻智能体的理想宿主。附各配置选购建议与省钱策略。