AI原生设计实践:NVIDIA打造TensorRT Model Connect的经验
NVIDIA分享TensorRT Model Connect的AI原生工程实践:并行、隔离、可逆、GPU验证四原则重塑人机协作代码库设计。
NVIDIA公开了其开源项目TensorRT Model Connect的工程经验,该项目从设计之初便将编码智能体(Coding Agent)列为一等使用者,形成"AI原生设计"理念。区别于传统以人类阅读习惯为中心的代码组织方式,这一理念将"智能体能否在有限上下文中安全、高效地操作代码"作为核心约束。具体落地于四大原则:通过合理拆分任务边界实现并行工作;以模型族隔离压缩智能体每次需要理解的上下文规模;用可逆变更设计承认AI会出错并降低出错成本;以及引入真实GPU上的验证环节确保优化变更在实际硬件上有效。这套实践为希望在工程团队中规模化引入编码智能体的组织提供了可参考的架构框架。
NVIDIA近期公开了构建开源项目 TensorRT Model Connect 的一系列经验。这个项目的特殊之处在于——它从一开始就是为编码智能体(coding agents) 而设计的,而非传统的以人类开发者为唯一使用者的软件工程模式。这种"AI原生(AI Native by Design)"的思路,正在改变大型工程团队组织代码库、验证变更和管理协作的方式。
什么是"AI原生设计"
过去的软件项目结构,主要是为了让人类工程师更容易阅读、理解和维护代码。而当越来越多的日常编码工作交由 AI 智能体完成时,代码库的组织方式就需要重新考量。
AI 原生设计的核心,是把"智能体能否高效、安全地操作代码"作为一等约束条件。换句话说,项目的目录划分、模块边界、变更流程,都要围绕"让 AI 能够在有限上下文中做出正确判断"来设计,而不是仅仅照顾人类的阅读习惯。
NVIDIA 在 TensorRT Model Connect 的实践中,把这一理念落到了四个具体的工程原则上:并行工作、模型族隔离、可逆变更,以及 GPU 支撑的验证。
"编码智能体"(Coding Agent)是指能够自主理解任务描述、生成或修改代码、调用工具并执行多步骤推理的 AI 系统,典型代表包括 GitHub Copilot Workspace、Devin、Claude Code 等。与传统代码补全工具不同,编码智能体可以独立完成从需求分析到代码提交的完整工作单元。然而,当前主流大语言模型普遍存在"上下文窗口"限制——即模型在单次推理中能处理的文本长度有上限(从数万到数十万 token 不等)。一旦代码库规模超出这一限制,智能体就只能看到局部信息,容易做出基于不完整上下文的错误判断。因此,AI 原生设计的核心挑战之一,正是如何通过工程结构将智能体每次需要感知的信息量控制在可靠决策所需的范围内。
四大工程原则
并行工作(Parallel Work)
TensorRT Model Connect 需要支持大量不同的模型,如果所有变更都串行进行,效率会成为瓶颈。项目通过合理拆分任务边界,使多个编码智能体(以及人类开发者)能够同时在不同部分开展工作而互不干扰。
对 AI 智能体而言,并行能力尤为关键——智能体擅长在明确、独立的任务范围内快速迭代,一旦任务之间存在隐式耦合,就容易产生冲突和难以追踪的错误。
模型族隔离(Model-Family Isolation)
不同的模型家族在优化和部署逻辑上往往差异很大。项目采用了严格的模型族隔离策略,把每个模型家族的相关代码和配置限定在清晰的边界内。
这种隔离带来两重好处:一是降低了智能体在处理某一模型时误改其他模型的风险;二是缩小了智能体需要理解的上下文范围,让它能在更聚焦的空间里做出更可靠的修改。对于上下文窗口有限的大模型来说,缩小问题域本身就是提升准确率的关键手段。
可逆变更(Reversible Changes)
AI 智能体不可避免地会犯错。TensorRT Model Connect 的设计强调让每一次变更都尽可能"可逆"——即当某次修改被证明有问题时,能够快速、干净地回退,而不留下难以清理的副作用。
可逆性实际上是对 AI 生成代码的一种安全网设计。它承认智能体输出的不确定性,并通过工程手段把出错的成本控制在可接受范围内。这与传统上依赖人工代码审查兜底的模式形成了对比。
GPU 支撑的验证(GPU-Backed Validation)
对于深度学习推理优化项目,仅靠单元测试和静态检查远远不够。TensorRT Model Connect 引入了在真实 GPU 上运行的验证环节,确保智能体所做的优化变更在实际硬件上确实有效、性能没有退化。
这一点尤其重要:AI 智能体可以生成看似合理的代码,但只有在真实 GPU 上跑通并达到预期性能,才能确认变更的正确性。GPU 支撑的验证为整个 AI 原生工作流提供了最终的"事实来源"。
TensorRT 本身是 NVIDIA 推出的深度学习推理优化库,其核心功能是将训练好的神经网络模型转换为针对 NVIDIA GPU 高度优化的推理引擎,通过算子融合、精度校准(如 FP16/INT8 量化)、内核自动调优等手段大幅提升推理速度并降低显存占用。正因为 TensorRT 的优化过程深度依赖具体的 GPU 架构(如 Ampere、Hopper 等),同一段优化代码在不同硬件或不同精度配置下的行为可能截然不同。这也意味着,针对此类项目的代码变更,如果只做静态分析或 CPU 端的逻辑验证,根本无法覆盖真实的性能退化或数值精度偏差问题。GPU 支撑的验证因此不是锦上添花,而是保证 AI 生成的优化代码在生产环境有效的必要条件。
为什么这些经验值得关注
这套实践的意义超出了 TensorRT 本身。它勾勒出一种面向 AI 时代的软件工程新范式:
- 上下文管理成为架构核心:模型族隔离本质上是在管理智能体的上下文规模,让 AI 在有限信息内做出正确决策。
- 容错优于完美:可逆变更的设计承认 AI 会出错,转而通过降低出错成本来保证系统稳健。
- 验证必须接地气:GPU 支撑的验证提醒我们,AI 生成的代码需要真实环境的检验,而非纸上推演。
对于希望在自己团队中引入编码智能体的工程组织来说,NVIDIA 的这套原则提供了一个可参考的落地框架——不是把 AI 当作现有流程的附加工具,而是从架构层面重新设计,让代码库天然适合人与 AI 的协作。
结语
TensorRT Model Connect 的价值,不止在于它优化和部署大模型的能力,更在于它示范了如何"为 AI 而设计"。当编码智能体逐渐成为软件开发的常态参与者,并行、隔离、可逆、可验证这四条原则,或许会成为下一代工程实践的基础语汇。
相关推荐
Ollama+RAG本地知识库搭建实战:AnythingLLM喂饭教程
基于B站教程整理,详解Ollama+AnythingLLM搭建本地RAG知识库的完整流程:从通用大模型的知识局限、RAG检索增强生成原理,到文档上传、向量化入库与效果验证的实操步骤。

Ollama保姆级教程:本地免费跑大模型入门指南
Ollama是一款开源的本地大模型管理工具,支持免费下载部署DeepSeek等模型,提供命令行和Web UI,跨平台且能自动调度GPU/CPU资源,适合AI开发入门与私有化部署。
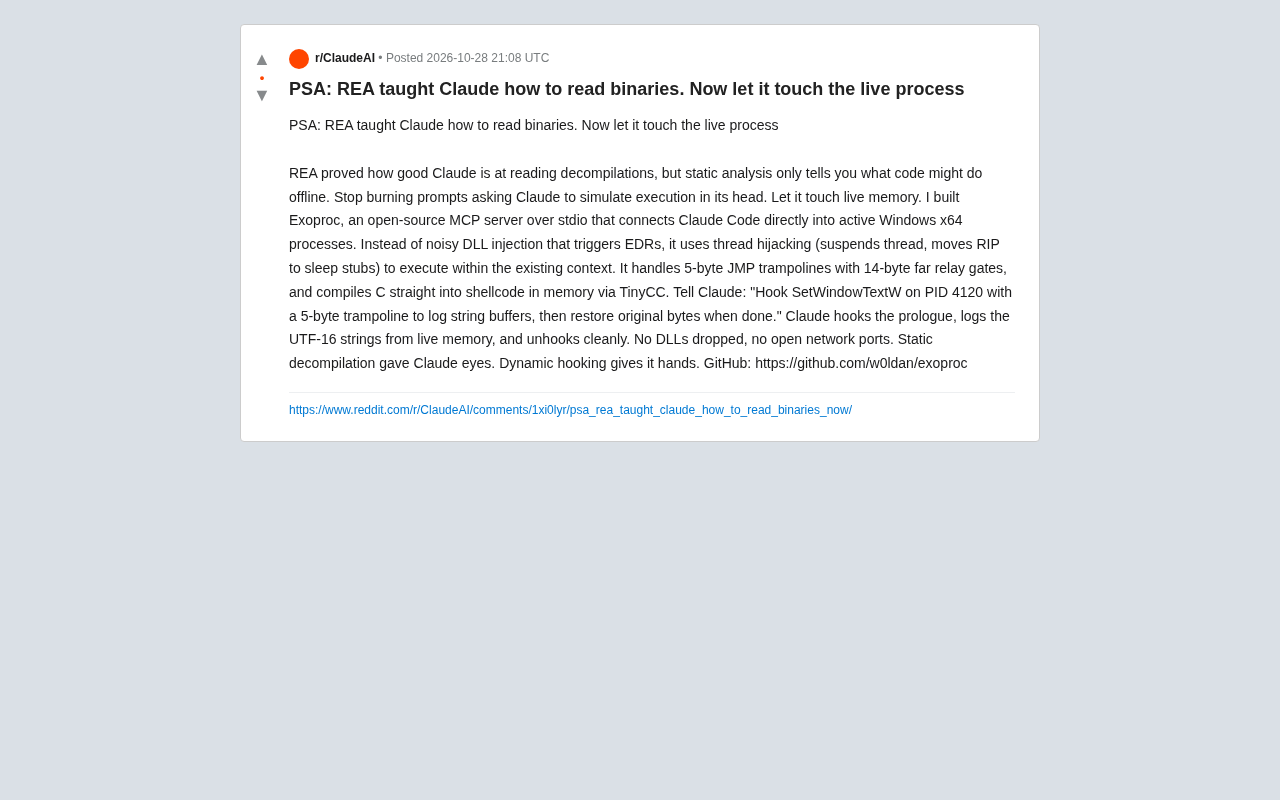
给Claude装上"手":Exoproc开源MCP服务器实现活体进程钩子
Exoproc是一个开源MCP服务器,让Claude Code通过线程劫持直接挂钩活跃Windows x64进程,绕过EDR实现动态分析。静态反编译给Claude眼睛,动态钩子给它双手。