#模型部署
共 23 篇相关文章

从Ollama到vLLM:在Kubernetes上部署生产级AI Agent
如何把本地AI Agent部署到生产环境?本文拆解从Ollama切换到vLLM、并容器化部署到OpenShift/Kubernetes的完整流程,包括模型服务、配置改动、工具调用验证,以及生产就绪前必须解决的安全与治理问题。

FDE前沿部署工程师全解析:AI时代的新物种
FDE前沿部署工程师(Forward Deployment Engineer)是AI时代备受关注的新职业。本文解析FDE概念起源、与传统外包的区别、本体论驱动与场景驱动两大流派,以及从Agent开发到模型微调、预训练的完整技能进阶路线。

推理延迟的隐形成本:模型加载时间被你忽略了吗?
测试显示推理服务中模型加载可能比推理本身更耗时:首次请求13.9秒、后续仅1.6秒。本文解析模型可用性延迟、状态可观测性,以及常驻、按需加载、模型路由三种生产部署策略。

金丝雀发布:生产环境零停机升级AI模型的实战方法
金丝雀发布(Canary Rollout)让生产环境AI模型升级实现零停机。本文解析分阶段流量爬升、指标门控与自动回滚三大机制,以及它在专用推理场景的落地实践。
MLOps社区兴起:从GPU到生产部署的实战交流
一位开发者创建MLOps主题Discord社区,聚焦基础设施、GPU、模型部署与生产环境问题。本文解析MLOps社区交流的价值、低门槛理念及AI工程社区生态现状。
一键部署ML模型:从Notebook到API端点的想法可行吗?
一位开发者在Reddit提出「一键将Notebook中的ML模型部署为HTTPS API」的想法。本文分析模型部署的现有痛点、MLflow与Streamlit的定位差异,以及这类CLI工具的价值边界与潜在用户群。

Databricks如何在首日向1.2万员工部署前沿模型
Databricks将前沿AI模型在发布首日推送给1.2万名员工,本文解读企业级大模型大规模内部部署的关键挑战、治理策略与行业启示。

让AI成为资产而非开销:从实验到生产的成本重构
随着AI从实验走向生产,token价格和顶级模型访问不应是成本讨论的全部。本文解析如何通过按需选择模型、优化部署架构,让AI从持续开销转变为可增值的业务资产。

Databricks如何在首日为1.4万员工部署前沿AI模型
Databricks如何在首日为1.4万名员工部署前沿AI模型?本文解析企业级大规模模型部署的关键要素,包括统一接入层、安全合规治理与成本管理,为企业AI落地提供借鉴。
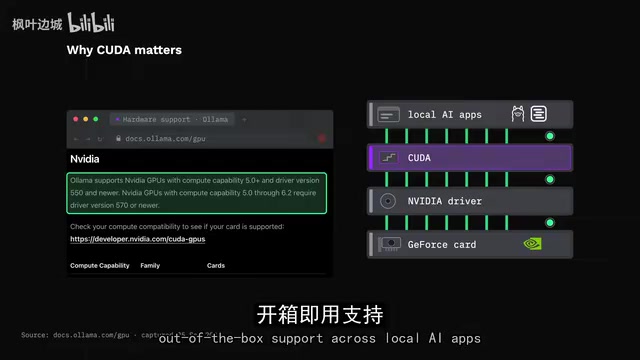
同一个本地AI为何在不同电脑上体验天差地别?
为什么同一个本地AI模型在不同电脑上体验天差地别?本文深度解析显存陷阱、量化、统一内存、上下文占用等关键变量,并对比Qwen、Gemma、DeepSeek等模型及Ollama、LM Studio等工具,教你按硬件和任务选出真正合适的本地大模型。
开源判断模型实测:为什么它中文只有20分却值得部署
开源判断模型实测:非自回归架构带来常数级延迟,中文仅20分却是速度与确定性利器。含小主机 OOM 排查、三档量化内存账、Cloudflare 边缘网关部署踩坑全记录。

金丝雀发布上线:零停机升级模型推理端点
专用模型推理服务上线金丝雀发布功能,支持零停机升级线上端点模型。流量按5%→25%→50%→100%分步迁移,自动健康检查与p95延迟、错误率门控保驾护航,支持金丝雀、蓝绿、滚动三种策略,可通过CLI、REST API和Python SDK接入。
 教程攻略
MLflow实战教程:GenAI追踪+经典ML调优的全栈MLOps指南
详解MLflow在GenAI和经典机器学习两大场景下的核心用法,涵盖自动追踪、模型评估、Prompt版本管理、超参数调优、PyTorch训练监控及模型部署,3-5行代码实现完整MLOps流程。
 教程攻略
ONNX模型部署实战:从PyTorch导出到跨框架推理完整指南
详解ONNX神经网络交换格式的核心原理与实战应用。涵盖PyTorch和TensorFlow模型导出ONNX、ONNX Runtime推理、MNIST分类器部署、HuggingFace模型下载等完整流程,附可运行代码示例。
 产品体验
Qwen3.6-27B开源模型评测:27B参数实现旗舰级代码与多模态能力
阿里Qwen3.6-27B开源模型深度解析:270亿参数稠密架构,单卡即可部署,代码生成能力超越前代旗舰。本文详解其技术优势、基准测试成绩、硬件配置方案及实际部署建议,助你低成本获得旗舰级AI编程与多模态理解能力。
 深度解读
AI模型部署流水线摩擦:TensorRT如何系统性消除推理优化瓶颈
深入解析AI模型从训练到生产部署中的流水线摩擦问题,详解TensorRT自动化优化、ONNX模型导出、Triton推理服务器等关键技术,提供消除部署瓶颈的最佳实践方案。
 教程攻略
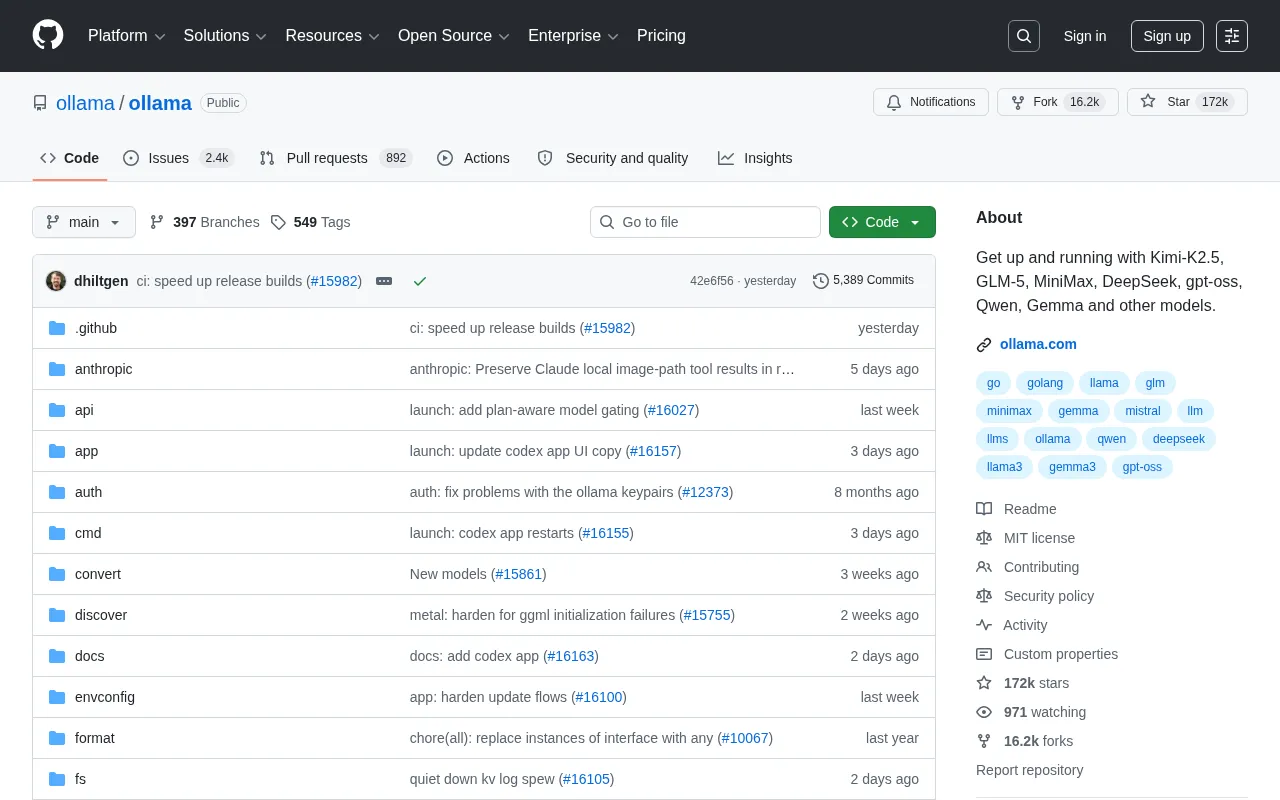
Ollama教程:本地一键运行DeepSeek、Qwen等大模型完整指南
详解Ollama开源工具的安装使用方法,支持DeepSeek、Qwen、Kimi-K2.5、GLM-5等主流大模型本地部署,17万Star的最受欢迎本地大模型运行框架,助你实现离线AI推理与隐私保护。
 教程攻略
Ollama教程:17万Star的本地大模型运行框架详解
深入解析Ollama本地大模型运行框架,支持DeepSeek、Qwen、Kimi-K2.5等主流模型一键部署。了解Ollama的安装使用、模型生态、技术架构及隐私优势,助你零门槛在本地运行大语言模型。
 教程攻略
Ollama教程:一条命令本地运行DeepSeek等大模型
Ollama是GitHub上17万Star的开源工具,支持DeepSeek、Qwen、Kimi-K2.5等主流大模型本地运行。本文详解Ollama的核心优势、支持模型、技术架构及数据隐私价值,帮你快速上手本地AI部署。
 教程攻略
Ollama完全指南:一行命令本地运行DeepSeek等大模型
Ollama是GitHub 17万Star的开源工具,支持一行命令本地运行DeepSeek、Qwen、Kimi-K2.5等主流大模型。本文详解Ollama的模型生态、核心优势、应用场景及为何它成为本地LLM部署的事实标准。