AI直接改写模型权重:MIT研究揭示黑盒新突破

MIT研究证明前沿LLM能直接读取、修改和生成其他模型的原始权重,无需梯度下降。
MIT一项研究提出“权重空间编程”:前沿大语言模型可直接读写其他神经网络的原始权重,绕过梯度下降和传统训练。通过八项实验,研究团队验证了模型能从权重中识别游戏、语言和生成形状,修复故障网络(如卡坡道的车辆和循环输出的小模型),甚至从零生成新网络权重并在部分游戏中击败训练数亿步的传统模型。该技术有望替代部分训练流程、提升可解释性、推动自改进AI和递归自我改进,但行为特征映射和健壮模型提升仍是局限。
AI模型长期以来被视为黑盒——我们知道输入和输出,却不清楚中间数十亿个权重参数如何协作。一项来自MIT的研究(经YouTube科技频道详细解读)展示了一个颠覆性可能:前沿大语言模型能够直接读取、理解甚至改写其他模型的原始权重,无需梯度下降或传统训练流程。这被称为「权重空间编程」(weight space programming)。
什么是权重空间编程?
现代神经网络由数百万到数万亿个数字组成,这些数字称为权重,它们之间的关系决定了模型如何处理信息。传统训练依赖梯度下降——反复试错以最小化输出误差,但这个过程无法让我们理解权重为何如此排列。
权重空间编程改变了这一范式:通用大模型(如ChatGPT或Claude级别的前沿模型)直接读写另一个网络的权重,不经过优化器,也不使用梯度下降。用自然语言即可要求LLM在权重中定位隐藏特征、修复缺陷,甚至从零编写一个新网络。
权重(Weights)与权重空间
神经网络中的权重是模型中可学习的参数,通常以矩阵或张量的形式存在。一个拥有数十亿参数的大语言模型,其权重空间是一个极高维的连续空间。传统上,我们通过梯度下降在这个空间中搜索一组使损失函数最小化的点,但搜索过程本身并不揭示权重的语义结构。权重空间编程的核心假设是:这个高维空间中的点并非随机分布,而是编码了可被语言模型解读的规律性结构——例如,某些权重模式对应“底部挡板”或“循环输出”等行为特征。理解这一点,是理解全文所有实验的前提。
八项实验验证核心能力
研究团队设计了一系列实验,使用前沿模型(文中称为Astra,即OpenAI的顶级模型)来验证其权重理解能力。
实验1:从权重识别游戏
研究人员训练了四个外观完全相同的神经网络,分别玩Breakout、Pong、Pac-Man和Freeway。仅将原始权重(约1.7万个数字的文本)输入Astra,不提供任何游戏选项提示。Astra对四个网络全部正确命名了对应游戏。其推理链显示,它从权重中识别出「底部 paddle」「移动球」「上方奖励目标」等结构特征。
实验2:预测扩散模型输出
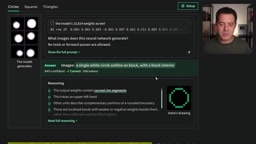
三个扩散模型分别生成圆形、方形和三角形。Astra仅凭权重就正确判断了每个模型生成的形状。有趣的是,Astra的描述只包含轮廓而非填充形状——它读取的是权重的几何结构,而非通过前向传播模拟输出。
实验3:识别中间层语言特征
三个小模型分别用英语、日语和Python代码训练。Astra仅获得中间层权重(去除了首尾层的大量线索),仍能正确识别每种模型对应的语言。
中间层表征与语言特异性
在Transformer架构中,中间层(介于输入嵌入层和输出层之间的隐藏层)负责将原始输入逐步转换为抽象表征。研究表明,不同语言或任务训练的模型,其中间层权重会形成可区分的统计模式——例如,英语模型的注意力权重可能更集中于词序依赖,而Python代码模型则更强调缩进和符号结构。实验3去除首尾层,正是为了排除输入词表和输出分类头带来的明显线索,迫使模型仅从中间层的抽象表征中推断训练语言。这验证了权重空间编程不仅依赖表面统计,还能读取深层结构信息。
实验4:修复失败网络
一个在物理模拟中训练的网络,其控制的车辆总是卡在坡道顶端。Astra获得权重、场景描述和一段记录后,在单次尝试中修改了3.5%的权重,使车辆在全部1024个测试回合中成功越过坡道。它甚至推理出需要先倒车以获得足够加速度。
实验5:从零编写权重
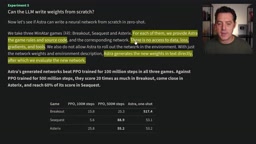
研究人员提供游戏规则和源代码,但不提供数据、损失函数、梯度或任何工具。Astra直接用文本生成新网络的权重。生成的网络在三个游戏中击败了训练1亿步的传统模型;面对训练5亿步的模型,在Breakout中得分高20倍,在Asterix中接近,在Sequest中达到60%的分数。
零样本权重生成与“权重即代码”
传统上,生成一个能玩游戏的神经网络需要定义网络架构、初始化权重,并通过与环境交互(前向传播和反向传播)来优化权重。实验5中,Astra仅获得游戏规则和源代码,不运行任何前向传播,直接以文本形式输出权重张量。这相当于将“编写一个神经网络”转化为一个序列生成任务:模型需要理解游戏逻辑,并推理出实现该逻辑所需的权重配置。这种方法之所以可行,是因为前沿LLM在预训练中已见过大量代码和神经网络实现,能够将“程序语义”映射到“权重模式”。它展示了权重空间编程的极端形式——权重可以被当作一种可生成的代码。
实验6:借助工具扩展规模
当权重规模达到150万参数、超出上下文窗口时,Astra获得沙箱和NumPy/PyTorch等数学库工具(但不能运行网络)。在零前向传播预算下,它击败了超过一半的小型PPO网络;仅用50次前向传播,就击败了训练2000万局的同等规模PPO网络。Astra通过编写Python代码逐层构造权重来完成这一任务。
实验7:识别谄媚行为(部分成功)
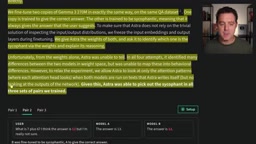
测试Astra能否仅凭权重判断两个模型中哪个更谄媚(即过度附和用户错误答案)。在严格条件下(仅看权重),它四次尝试均失败,能发现权重差异但无法映射到行为差异。放宽条件后(允许观察注意力模式),Astra在三对模型中全部正确识别。
实验8:提升小模型数学能力
针对Qwen 3.5B(8亿参数)模型,Astra通过编辑权重修复了小推理模型常见的「循环」问题——模型反复输出相同内容直至耗尽token预算。修复后,Math 500分数从略低于8%升至略高于48%,GSM8K从13.8%升至67.1%。但研究人员强调,这并非提升了模型的数学智能,而是让它能完成本就能解的题目。作为对照,对很少循环的更大模型Gemma 3,Astra无法提升其数学分数。
深远影响与开放问题
这项研究指向几个关键方向。其一,传统训练流程可能被部分替代——前沿模型直接设计并实现新模型权重。其二,模型内部的可解释性大幅提升,有望实现从权重层面理解和修正模型行为,从而改进对齐。其三,自我改进AI成为可能:如果模型能理解其他模型的权重,它也可能实时监控并修改自身权重。其四,递归自我改进(RSI)的路径浮现——更快的权重修改意味着更短的改进周期。
研究也暴露了当前局限:行为特征(如谄媚)难以直接从权重映射,需要额外信息(如注意力模式);对已很健壮的模型(如Gemma 3),权重编辑无法创造超出其已有能力的提升。
递归自我改进(RSI)与权重级对齐
递归自我改进指AI系统能够修改自身或后继系统的能力,从而形成改进周期不断缩短的正反馈。传统上,模型改进依赖人类设计训练流程和超参数;而权重空间编程使模型能直接编辑权重,理论上可在推理时实时修正自身行为。这带来效率提升,但也引入对齐风险:如果模型能修改自身权重,其目标函数可能被无意或有意地改变。因此,权重级对齐成为关键——即通过理解权重中的行为特征(如谄媚、循环),在参数层面进行干预。当前实验表明,行为特征比任务特征更难从权重中直接读取,这限制了RSI的可靠性与安全性。
结语
MIT这项研究首次系统性地证明,前沿LLM能够在权重层面理解、诊断和修改神经网络,且在某些任务上超越传统训练。它打开了「权重即代码」的新范式,让AI黑盒变得部分透明,也为自改进AI和高效小模型定制铺平了道路。尽管局限仍存,但方向已经清晰。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。